核心要点
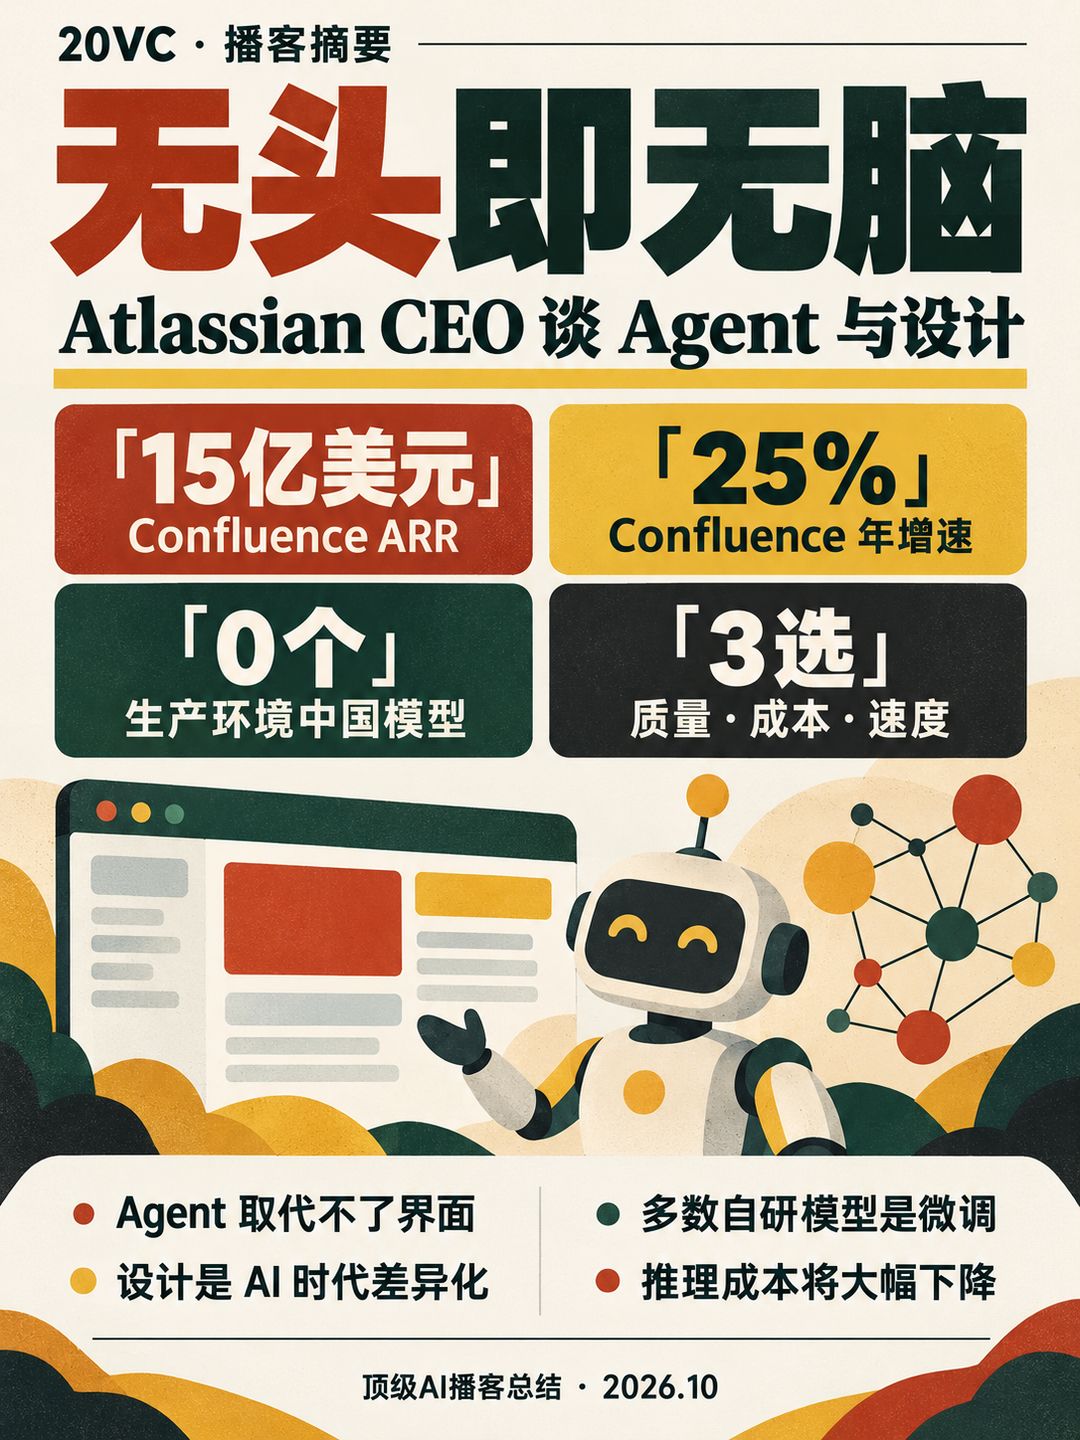
- Headless 即无脑:Mike 认为放弃用户界面、不再演进客户体验是"brainless bet"。Atlassian 大力支持 MCP 与 CLI,但认为 Agent 不会取代所有界面,横向 Agent、垂直 Agent 与界面三者可以并存。
- 设计成为差异化:当技术创造越来越廉价、供给充裕,设计与体验成为突出自己的关键。Atlassian 对设计的投入前所未有,团队十多年来首次在解决"基础性设计难题"。
- 不用中国模型:Atlassian 生产环境不使用任何中国模型,因为部分客户有顾虑,但客户并不排斥开源模型,平台大量使用 Nvidia Nemotron 和 Mistral。他认为这是地缘政治问题,与技术上是否可用是两回事。
- 自研模型存疑:Mike 认为专用模型的收益"jury is out",多数所谓自研其实是在开源(常为中国)模型上微调,百万美元训练的说法不可信。通用模型进步速度正在碾压多数专用模型。
- 推理成本暴跌:他最近改变的最大看法是推理价格会降得比预想更多,因为资本与人才大量涌入每瓦性能优化。他承认杰文斯悖论会推高用量,但认为生产速度已超过消费速度,用量不会无限增长。
- 路由与成本纪律:大公司必须自建模型路由与 AI Gateway 团队,在质量、成本、速度三角中取舍。他建议产品团队先做出神奇功能,规模上来后再优化成本,并提供 token 花费看板。
- 上下文图谱:Teamwork Graph 像 Google 的网页索引,提前推理并保持新鲜,只对单个客户有价值。Mike 称 Confluence ARR 超 15 亿美元、年增长超 25%,说明内容本身不是壁垒。
章节时间轴
- 0:00 开场与 Agent 之问 — Harry 抛出 Agent 取代数据入口后 Atlassian 价值何在,Mike 指出任务类型不同结论不同。
- 3:05 Headless is brainless — 强调 Atlassian 是 MCP 的重度使用者,但界面与设计仍是核心。
- 6:09 横向、垂直 Agent 与 A2A — 举 Figma、Databricks 合作为例,不相信"一个万能按钮"。
- 8:29 基础设计难题 — Agent 来源、人机署名、文本框体验与软件工厂比喻。
- 14:41 五年后的怪想法 — 水印 AI 内容可能反转,类比电影 CGI 与调色,人类判断仍会突出。
- 17:01 中国开源模型之争 — Atlassian 不用中国模型,但不排斥开源,谈蒸馏回路与 Linux 类比。
- 21:36 专用模型与自研之说 — 为什么多数自研模型站不住,验证条件是什么。
- 25:31 成本、路由与 Gateway — 私有公司不关心成本的纪律问题,模型路由与内部 AI Gateway。
- 31:41 推理价格与想象力不对称 — 推理成本趋势、杰文斯悖论,从信息不对称到想象力不对称。
- 38:41 数据成本与上下文图谱 — Teamwork Graph 的作用,对比 Mercor 类数据市场。
- 44:55 Anthropic、OpenAI 入侵应用层 — Confluence 的规模与设计差异化,回应 Linear 对比。
- 48:43 创始人精力与快问快答 — 年轻创始人早退、"wage peace on yourself"、放慢思考。
详细内容
Agent 与界面:为何"无头"是个坏赌注
Harry 的前提是 Agent 会取代人与数据源的交互,让 Atlassian 变成数据提供方。Mike 认为前提过于简化:功能性强的任务确实会被 Agent 吞掉,如买充电线这类只想"拿到东西"的购物;但涉及品味、协作、研究的任务,人仍想亲自参与。企业协作与业务流程里,Agent 已在推进工作,让人专注更高价值的创造性部分,他认为这对 Atlassian 是好事。
他的核心立场是"Headless is brainless"。Atlassian 的 MCP 服务器位列全球前三到前五,Agent 与 harness 可以向 Teamwork Graph 读写数据,这恰好展示了图谱质量。但如果自己的界面与设计不进化,就会陷入麻烦。他举例:门槛很低,现在 90% 的 App 都做得出来,五年后同样的 App 只能超过 20%,体验标准不断上移,需要大量研发与匠心。
关于横向与垂直 Agent,Mike 认为三种形态可以同时成立:有横跨多任务的横向 Agent,有深耕单一任务的垂直 Agent,也有保留界面的产品。Atlassian 的数据可以被 Claude、Codex、Cursor、Teams、Slack 里的 Agent 访问,但这不意味着那是完成所有工作的最佳界面。与 Figma、Databricks 的合作让用户在 Confluence 中选中文字就能向 Databricks 或 Snowflake 查数、出小图,他把这称为 A2A 的好例子,但强调这不等于 Confluence 变成 BI 工具。他自称是"magic button 论"的空头,不相信一个万能 Agent 能做一切。
设计的基础性难题
Mike 说,上一次要重新思考设计范式是移动时代,现在团队又在解决基础问题:Agent 如何出现在协作平台里,人如何与 Agent 交互,Agent 代表人行事时如何署名,如何区分 AI 触碰过与未触碰的内容。他还认为"文本框很烂":一条空白输入线声称拥有无限能力,多数用户只是把它当 Google 搜索。如何向用户解释能力、在合适时机给出合适功能,是 agentic UI 要解决的问题。
署名与来源是另一个难点。Codex 提交了 pull request,是 Harry 做的、Codex 做的,还是 Codex 代表 Harry 做的?人参与多少会改变内容性质。他以 Anthropic 的水印功能为例,指出水印文字不等于坏:是让 AI 写 3000 字,还是让 AI 润色已有文章,文本相同、水印相同,但含义完全不同。来源与问责因此变得重要,同时用户不需要看到所有 Agent 轨迹,只需要在出错时被通知。
他也谈到"软件工厂"的说法:并不完美,因为软件本质上是创造性的,但思路是人不再亲手冲压钢材,而是运营工厂、启动、处理异常和共同引导。界面该如何设计,让人知道何时介入、何时无须关注,是眼下一个令人兴奋的变化领域。
五年后的"怪想法":水印可能反转
Harry 预测五年后人类创作内容会带水印,因为 90% 内容由 AI 生成。Mike 举例:20 年前网上找老婆很奇怪,现在占 60%;他们早期卖软件时,客户要下载 PDF,填信用卡号后传真过来,团队早上再把传真手动录入机器。他的预测是水印可能反过来,我们不再知道哪些内容没被 AI 触碰,也不会因此判断好坏,就像看电影不会问有没有 CGI,用 Word 拼写检查也不会被嫌弃。纯 AI 垃圾内容会存在,所以手工匠心之作会更显眼,人类判断仍会让内容脱颖而出。
中国模型与开源:地缘政治与技术是两个问题
Harry 转述 Jason 的话:大企业不愿用中国开源模型。Mike 回应:客户确实在某些地方对"所谓中国模型"有顾虑,但对开源模型没有顾虑。Atlassian 与 Nvidia 深度合作,使用大量 Nemotron,也用 Mistral 等;其理念是"用最适合的模型完成工作",混合模型以取得最优价格。但因为客户的担忧,Atlassian 生产环境不使用任何中国模型,并对此立场明确。
他认为人们没意识到蒸馏的回路:美国模型越来越多地用中国模型训练自己,却不公开。他拿 Linux 打比方:约 40% 的贡献据称来自中国,企业照样使用,因为开源可以被检查,AI 甚至让检查更容易。他区分了"谁掌握战略控制权"的地缘政治问题和"是否使用某个开放模型"的技术问题,前者超出他的能力范围。Harry 则补充,中国模型开发者及其家人离境需向政府报备,二者在一定程度上合一;Mike 说自己不评论社会议题,只从技术视角看,企业拒绝更便宜、效果更好且知道里面是什么的方案,长期看是困难的选择。
专用模型与"自研"的水分
Harry 提到 Harvey、Ramp 等公司宣称自建模型有收益,问 Mike 是否被验证。Mike 说 jury is out:有大量专有数据和特殊应用(如机器人、世界模型)的情况合理,但多数人并不在这种情况里。即便上线时有价格性能优势,也未必能持续,因为通用模型越来越强。很多人说自己训练了模型,实际是拿中国模型加领域微调,以"一百万美元"完成,他认为不可能:你拿的是别人十亿美元的模型。
Atlassian 自己也微调了一批开放权重模型以取得价格性能优势,但不会称其为自己的模型。他说要被说服,需要看到专用模型在每瓦价格上相对最新基础模型持续展现指数级优势。他认为 harness 设计很重要,但那不是模型进步。两三年前自研模型的创业公司,如今多数被基础模型"smashed"。
成本、路由与推理价格
Harry 指出私有公司融资多,不在乎成本。Mike 回答:这些公司没有在培养成本纪律,纪律是任何事情的根本。他认为用较便宜或较旧的模型并善加运用,对多数技术是真实优势。他接触的大型企业如今对价格性能非常敏感,Atlassian 推出了产品,展示 token 花费,帮助工程组织了解在哪里、用哪个模型、哪些功能产生价值。
模型路由方面,他认为 Atlassian 这种规模必须自己做好,有很大的 AI Gateway 团队,内部路由而不依赖第三方,可能也会叠加 OpenRouter 等;小公司则可以用现成路由。他认为通用的自动路由很难,需要给出意图或引导,harness 也会参与路由。对产品团队,他的建议是不要过早优化成本:5 个用户时不在乎,500 万用户时才在乎,中间有足够时间优化。
在"五年后什么会变便宜"上,他说答案是模型推理。大量资本、人才本来会去麦肯锡或 NASA,如今在做每瓦性能优化,从新芯片到数据中心设计到蒸馏,价格会以"断崖式"速度下降。Harry 提出杰文斯悖论,Mike 承认接近免费时用量会爆炸,但认为总会有经济曲线:现在技术生产快于消费,你的手机不会 100% 烧 CPU。他并总结为,这会是创造力驱动的经济,引用 Culture Amp 创始人(字幕记为 DDA)的说法,世界从"信息不对称"走向"想象力不对称"。
数据、上下文图谱与对 OpenAI/Anthropic 的看法
面对数据市场(Mercor、Surge)的问题,Mike 说企业知识与它们不同:很多事实与数字其实存在 PowerPoint 里,从未进入数据库。Teamwork Graph 把组织知识、决策、人员社交图和代码连在一起,像 Google 对网页建索引,提前推理,使 Agent 提问时能低成本回答;每个公司的图都独一无二,不会出售。他提到 Spirit Airlines 数据以约 3000 万美元出售百万封邮件,不确定是否成趋势。关键是图谱要新鲜:他 2003 年写的 Java 代码对 2026 年毫无用处,但"我曾经是程序员"这一历史有助于解释概念。因此组织图谱需要事实很新、学习很历史。
他也强调并购数据并不重要,因为那是客户自己的上下文:Atlassian 在做的是图、词法与语义搜索、面向 Agent 的 MCP/CLI 查询语言,以及让客户加入自定义数据。
对 OpenAI 与 Anthropic 向文档、Office 类应用扩张,Mike 说两者都是深度合作伙伴,边界会被激烈争夺,没人知道答案。他以 Confluence 为例:超过 15 亿美元 ARR(几个季度前披露),年增长超过 25%,本身就能成为上市公司;写文字本身不是壁垒,来自设计、体验、目的和跨工作流集成。至于 Linear 的设计更受称赞,他认为不公平,Atlassian 一直"不停提升",Jira 与 Teamwork Collection 今年增长创下新高。
创始人精力、金钱与建议
Harry 担心 20 岁出头的创始人"tap out"。Mike 说要管理自己的能量来源:他与上万名聪明的人解决难题,是他的能量,联合创始人 Scott 虽已"退休",每月仍会聚聚。他认为动机只是钱或圈子的人很难坚持五到十年,而当前融资 1500 万美元的预种子太容易,是 VC 的责任之一。
快问快答中,他改变的最大看法是未来推理价格"比想象的更低";钱既是美好也是沉重负担,是暂时持有的,应当做对社会有利的事;教育孩子要以身作则,借用"看大象"的比喻;最好的建议是 "wage peace on yourself";他最想增强的能力是创造慢思考的时刻,每周哪怕只有几小时,在被 Agent 与通知不断打断的世界里保持深度思考。
金句
如果你放弃了自己的用户界面,放弃为客户演进体验,那是一个无脑的赌注。 —— Mike Cannon-Brooks 0:00
我们正从信息不对称的世界,走向想象力不对称的世界。 —— Mike Cannon-Brooks 0:46
现在技术的生产速度快于技术的消费速度。 —— Mike Cannon-Brooks 33:14
我是"一个万能按钮"论的大空头,我不认为 AI 会这样运作。 —— Mike Cannon-Brooks 8:29
对自己宣布和平。 —— Mike Cannon-Brooks 57:09
在一切都更碎片化、更快的时代,我们要学会放慢,才能做深度思考。 —— Mike Cannon-Brooks 57:55
提到的书·产品·人物
- Atlassian / Jira / Confluence / Robo:Mike 的公司与产品,Confluence ARR 超 15 亿美元,年增长超 25%。
- Teamwork Graph:Atlassian 的企业上下文图谱,被比作 Google 的网页索引。
- MCP / CLI:Atlassian 的 MCP 服务器被称为全球前三到前五。
- Claude、Codex、Cursor、Teams、Slack:访问 Atlassian 平台并回写数据的 Agent 运行环境。
- Figma、Databricks、Snowflake:Atlassian 的合作伙伴,用于跨平台 A2A 功能。
- Nvidia Nemotron、Mistral:Atlassian 生产中使用的开放模型。
- OpenRouter:被收购的模型路由服务,Harry 提到作为路由层的例子。
- Harvey、Ramp:宣称自建模型的公司,作为专用模型讨论的例子。
- Mercor、Surge:数据市场公司,对比企业上下文数据。
- Linear:以设计与匠心著称的竞品,Harry 拿来与 Jira 比较。
- Jason:投资人,称大企业不愿用中国开源模型。
- DDA(Culture Amp 创始人):提出"想象力不对称"一说的人。
- Scott:Atlassian 联合创始人,已"退休",与 Mike 每月聚一次。
- Anthropic、OpenAI、Microsoft:Atlassian 的合作伙伴,同时向应用层扩张。
- Fireworks:Harry 投资的开放模型推理公司。
适合谁听
关心企业软件如何应对 Agent 冲击、模型选型与成本策略的创始人、产品负责人和投资人。