核心要点
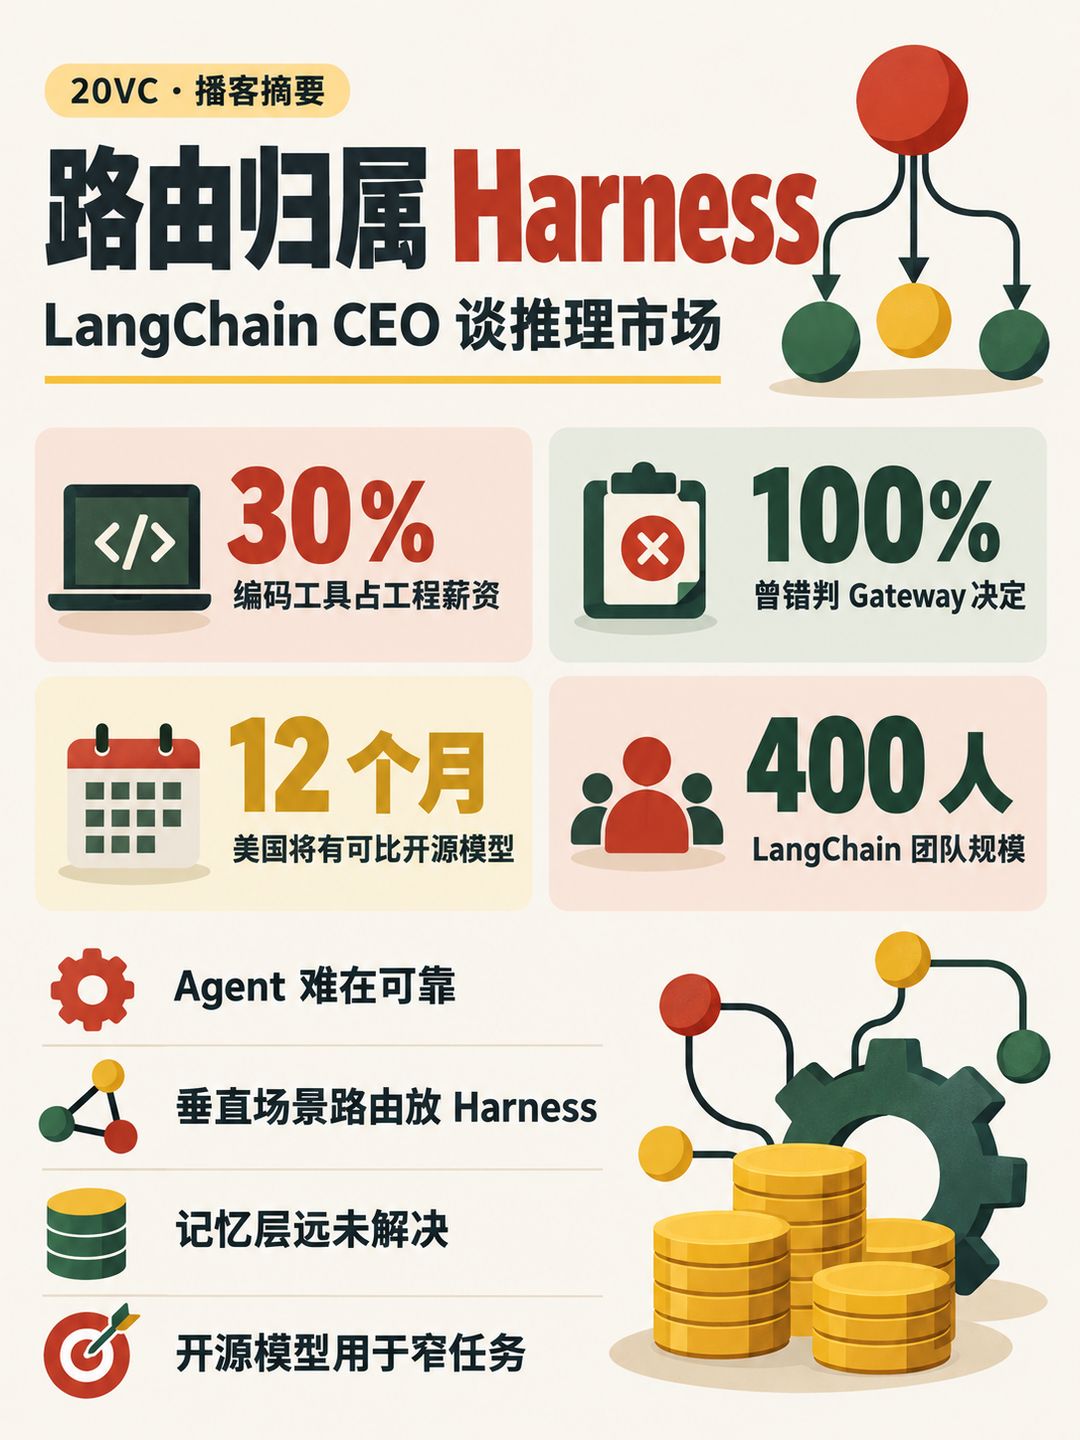
- Agent 难在可靠:模型是非确定性黑箱,输入空间无限,Agent 又是多次模型调用串联,错误会层层级联。LangChain 的工作重点是用 Harness 把这些模型约束得更可靠。
- 路由归属 Harness:Harrison 认为垂直 Agent 的路由应放在 Harness 层,因为那里掌握 prompt cache、状态和提示策略。通用聊天和编码这类横向场景可以放在 Gateway。
- 编码成本三步法:公司编码工具花费约占工程薪资 30%,近两个月不升反降,token 用量却上升。做法是追踪用量到 LangSmith、设预算上限、自建云端编码 Agent open suite 并内置缓存与路由。
- 起步先做 Harness:做垂直 Agent 应先做上下文和 Harness 工程,有了用户再考虑后训练。他认为领域专家能写出 verifier 和 eval,价值会向他们集中,因此极度看好垂直 Agent。
- 记忆层远未解决:难点不在数据库,而在把观察提炼成有价值的记忆,这需要 LLM 做元反思,而模型目前不擅长。LangChain 推出过商业记忆产品,因过于通用、没找到 PMF 而砍掉。
- 推理需求被低估:他一年半前否决了做 Gateway,因为看不出能比 OpenRouter 多提供什么价值,现在认为那个决定「100% 错误」。他引用 Eric Vishria 的话,「everything just works」,Fireworks、AWS、Crusoe 都会有需求。
- 开源模型用于窄任务:企业用开源与后训练模型主要做路由、护栏、抽取、摘要等简单任务,核心 Agent 循环仍靠前沿模型。他预计 12 个月内美国会有可比的开源模型,也认为企业对中国开源模型的担忧基本站不住脚。
章节时间轴
- 1:38 Agent 为什么难做 — 非确定性黑箱、无限输入空间、多步调用造成级联错误,靠更强的模型和 Harness 改善。
- 5:30 为什么需要中立 Harness — 记忆和上下文不应绑定单一模型厂商,要能切换模型、防止锁定,并同时掌控模型、Harness 与上下文。
- 9:21 价值在验证与垂直 Agent — 价值归属能写 verifier 的领域专家,起步先做上下文与 Harness,再谈后训练。
- 12:28 后训练与专用模型 — 后训练目前多用于护栏、分类等简单子任务,核心循环是否值得后训练仍是开放问题。
- 13:59 模型路由:Gateway 还是 Harness — 垂直场景应在 Harness 做路由,通用聊天和编码可放 Gateway,路由并非商品。
- 20:08 评测与持续学习 — 学术 benchmark 已被刷穿,要看内部 eval 和 traces,持续学习是 Agent 外层的改进闭环。
- 24:45 数据与记忆层 — 上下文层更像「数据库外加一个 Agent」,记忆的难点在提炼,模型的元反思能力不足。
- 31:38 垂直消费 Agent 与 Agent 对 Agent — 应用暴露自己的 Agent,由用户的横向 Agent 调用,请求量和基础设施压力大增。
- 35:30 token 成本与企业关注点 — 前沿模型单价下降但需求暴涨,企业最关心准确性,其次是成本、延迟和安全。
- 38:35 自家编码花费与组织设计 — 三步控制成本,一次误用单周烧掉 4 万美元,并讨论小团队驱动大量 Agent 的前景。
- 44:44 开源模型与推理市场 — 对中国开源模型的担忧基本站不住脚,开源多用于窄任务,推理需求被严重低估。
- 49:22 投资判断与融资 — 不看好客服与机器人,看好推理与底层基础设施,并谈到 Benchmark、Sequoia 与融资博弈。
详细内容
Agent 难在哪里,Harness 为何重要
Harrison 认为 Agent 难做的根源是模型本身:它们是非确定性的黑箱,输入是自然语言,空间无限,用户在聊天框里可以输入任何东西。两个相似的输入可能得到完全不同的答案,小改动也会改变输出。Agent 又不是单次调用,而是一串模型调用加工具交互,小黑箱嵌进大系统,错误会级联放大。
三四年前和今天相比,Agent 好了很多,原因有二:模型变强,以及人们学会了用系统去「驾驭」模型,也就是 Harness。LangChain 聚焦的正是第二点。他在节目收尾的快问快答里也说,对 Agent 最被低估的一点就是它仍然「真的非常难」。
他还谈到公司的业务如何随模型进步而变化:必须不断「删掉」产品的一部分。他提到 Cursor 把「delete the product」当作运营原则,半年前必须做的事现在可能不用做了。早期 LangChain 让模型生成 JSON DSL 再解析来调用工具,大家都知道是 hack,几个月后 OpenAI 推出原生 tool calling,团队很快判断这才是未来,并整体切换。
判断哪些是短期 hack、哪些是长期存在,是他给创始人的建议。模型永远不会知道你的专有数据,也无法自己拿到 API 输出,所以连接模型与外部世界的系统会一直存在。围绕思维链、规划、tool calling 的 hack 则会被模型或 API 吸收。对「不知道会不会被淘汰,要不要做」的问题,他的回答很直接:不然你要不做吗?
中立 Harness、拥有自己的智能
主持人问:模型厂商自己就在做很强的 Agent,为什么中立 Harness 不会被吃掉?Harrison 的回答围绕状态。Agent 在运行中积累记忆(短期、长期,来自与用户交互或从环境中学习),而让 Agent 越用越好,一部分在模型权重里,很大一部分在模型之外的上下文里。如果上下文与某家模型厂商的 Harness 绑定,就切换不了模型。
切换能力既是进攻也是防守。进攻是随时用上最新最好的模型,防守是避免被锁定后厂商涨价。他提出「拥有自己的智能」由模型、Harness、上下文三部分构成,要做成开放、可控的 Agent 架构。另一个理由是模型厂商训练的 Harness 偏向分布内的任务(多半是编码),当你做销售、研究、法律等非编码场景时,需要自己控制 Harness。
主持人追问:若价值来自验证,谁赢?Harrison 的答案是领域专家。能把「好」量化并写成 verifier 的人,将获得大部分价值,建 eval 是一项很难的工作。所以他极度看好垂直 Agent:领域专家可以组合 Harness 与模型,做出不同的垂直 Agent 体验。
实操建议是从 Harness 层起步:先做上下文工程,调整 Harness,有了用户之后再做后训练,因为上下文和 Harness 层的 ROI 高得多。他把控制的成本分成四层:只管上下文(最便宜)、调 Harness、后训练开源权重模型、从零训练模型(只有 Neolab 在做)。
后训练与开源模型
对 Harvey、Ramp 自建模型的说法,Harrison 认为它们大多是在后训练开放权重模型(包括中国模型),这没有问题。这类公司有人才、数据和使用量,已经把上下文和 Harness 榨干,下一步自然是后训练。
目前后训练最合理的场景是更简单的子任务:分类、抽取、摘要,以及护栏、路由、子 Agent 等。真正悬而未决的是驱动主循环的核心模型:每次新前沿模型发布,它跑核心循环更强,而 Harvey 等公司仍在尝试对核心循环做后训练,Harvey 最近一个月左右就有相关发布。如果自己做垂直应用,他的态度是「起步绝不做」,但五年后用量足够大时可能成为现实选项。
谈到开源与中国模型,他说有的企业担心,有的不在乎。他认为担心数据回流中国实验室「很荒谬」,只要通过 Fireworks 或自托管。另一类担心是训练数据导致回答不符合企业价值观,他认为大体没有根据,评测可以检验,个别领域可能确有细微差别。他预计未来 12 个月会有可比的美国开源模型,提到 Nvidia 对生态的投入,以及 Reflection 最近的模型发布,当时在部分 benchmark 上略落后于中国模型。
他对开源的整体判断是「中间立场」:使用量比一年半前预期的要高,但主要还是路由、护栏、抽取、摘要等窄任务,没有驱动核心 Agent 循环。如果有高用量场景且其中一些组件足够简单,做后训练的 ROI 很高。这与推特上两种极端观点都不同。
模型路由:Gateway 还是 Harness
这是 Harrison 称之为「最热也最有分歧」的话题。首先是路由放在哪一层:Harness 层路由写在代码里,Gateway 层只是一个 API 调用。Gateway 的好处是能直接接进任何 Harness(比如 Claude Code),无需改代码。但在 Harness 里你有更多状态:能知道 prompt cache 的情况、保持缓存温热、更容易按模型调整 prompt。他认为 Factory、Cognition 也持同样观点,并称赞 Factory 写的路由技术博客。
他区分了 router 与 gateway:OpenRouter 的大部分使用量更可能来自 gateway 功能,也就是一个 API key 访问多个模型,由用户事先指定模型,而智能路由的实际使用远比人们想的少。路由必须理解任务和 Harness,所以不会有一个同时适合法律、金融、编码的通用路由,它将非常领域化、Harness 特定化。
主持人追问「Gateway 一方的 bull case 是什么」。Harrison 给出两点:一是可移植,比如你想让用户继续用 Claude Code 却要把部分流量路由到 DeepSeek 等开源模型,你不控制 Harness,只能在 Gateway 做(这也是开源 Harness 的论据);二是大家隐含假设的领域只有两个,即编码和通用聊天,比如「你好吗」不需要用 Opus。两年到三年后,他的预测是垂直 Agent 的路由在 Harness 内,通用横向场景在 Gateway。
路由是不是商品?他认为不是,但构建很难,因为模型变化太快:一个新的 Opus 或 OpenAI 模型出来,在所有方面都更强,路由的价值就下降了。
评测、持续学习与记忆层
关于是否信任 evals,他的回答是有用但不能全信。学术 benchmark 基本被刷穿,新模型发布时几乎无信息量;针对自己领域的内部 eval 仍然有价值,但最重要的还是「看数据」,不要只信单一数字,这也是需要 traces 的原因。模型会以不同方式变好,旧的 eval 未必能捕捉,所以垂直 benchmark 也要持续演进。
价值在哪里?他认为在于让 Agent 在你的垂直领域更好的东西,可以体现在上下文(数据、记忆、特定 API 和工具)、Harness(路由等领域知识)或模型(最难控制但天花板最高)。迭代这三者靠 eval。洞察回流到不同层的方式也不同:回到模型靠后训练,回到记忆要用另一个 Agent 读 traces 提炼学习,回到 Harness 则让 Agent 去修改 Harness 代码。LangSmith 里的 Engine 就是读 traces 并更新代码的 Agent。
对持续学习,他认为它不改变 Agent 的核心内循环(LLM 循环调用工具),而是增加一个外循环:取 traces、得出学习、修改某处、测量是否改善、重复。无论更新的是上下文、Harness 代码还是模型权重,外循环大致相同,只是具体操作差别很大。
在数据层面,他认为「面向 Agent 的上下文层」更像「围绕数据库的 Agent」,而不只是数据库。ClickHouse 这类传统数据库依旧很好,但记忆最难的部分根本不在数据库:许多公司的记忆就是存在单个文件里,难的是把用户与软件或 Agent 的交互观察提炼成有价值的信息。这种对提示和 Agent 架构的元反思,LLM 仍然很弱,人类也未必擅长,所以没有人知道记忆系统该是什么样。
他预计两三年内几乎所有产品都会有记忆这一层,并以 Instinct 和 Muse(字幕写法)在个性化、主动性上的成功为例。LangChain 自己做过开源记忆工作,推出 alpha 后砍掉了商业记忆产品,原因是没找到 PMF:太通用了,而记忆这么早期,真正有效的方案都是领域或 Agent 特定的。他认为「负责记忆的 Agent」会是领域特定的,Harness 看起来与现在的 deep agents 类似,只是带有专门的指令、工具和子 Agent。
Agent 对 Agent 与模型进步
对消费端,他预期会同时存在横向和垂直 Agent,横向 Agent 去调用垂直 Agent。理由有两点:应用最了解用户在该领域的使用方式(Spotify 与 Strava 的交互方式完全不同),而且应用有大量 API,用一个自然语言 Agent 去封装它们,对横向 Agent 来说体验更好。
主持人举了自己让 Agent 每 5 分钟查一次演唱会门票、持续三天的例子,指出请求量会是人类的上千倍。Harrison 提到有用户因为让 Agent 高频拉取而被 Resi(字幕写法)封号,基础设施会承受更大压力,需要更突发、更能横向扩展的系统,但他坦言没有更具体的看法。未来平台会暴露自己的 Agent。广告和追加销售问题可以放进 Agent 的自然语言回复中,而且平台自家的垂直 Agent 访问底层系统,比第三方 Agent 更高效。
关于模型进步是否会放缓,他说不在实验室里很难判断。有些任务已经「足够好」会趋平(摘要、路由、编码正在接近),而像元学习这类模型目前不擅长的任务,对实验室冲击 RSI 很重要,进展甚至可能比以往更快。
成本、企业需求与组织设计
Token 成本方面,前沿模型的性价比在改善,但需求远快于降价:Agent 对 Agent、多 Agent 系统烧掉大量 token,编码成本尤其暴涨。LangChain 内部的三步法是:可见性(把所有编码 Agent 用量追踪到 LangSmith)、成本控制(设预算,用完可找 VP 工程提高额度,防止 Agent 陷入坏循环)、改造 Harness(自建云端编码 Agent open suite,他本人现在只用它写代码,通过 Slack 触发,内置 prompt caching 和路由)。
追踪到的现象是:花得多的人未必都有效。资深工程师花得多他完全信任,但也出现过因设置失误造成的暴涨,例如一个插件在每一轮把网页 DOM 快照传回,进入大循环,一周花掉约 4 万美元。他还提到模型提供方已让开发者能在运行中动态增减工具而不破坏缓存,这是成本优化的另一环。
LangChain 每年的开发者调研显示,两年来排第一的都是准确性,且是第二名的约两倍,然后是延迟与成本,安全稍后。大型企业近期成本上升到高于延迟,安全在大企业里更高,但仍低于准确性和成本。
编码支出占薪资约 30%(他强调是估算),两年后会怎样他无法回答,因为组织变化太快:可能出现团队更小、Agent 花费等于甚至十倍于人力薪资的情形,但也可能因为这些能驱动 Agent 的人薪酬更高,总花费不变。目前他们仍需要多种背景的人协作,沟通与评审开销仍然存在。主持人指出这个比例是 Anthropic 企业价值的关键,若降到 5% 则 2 万亿美元 IPO 估值偏高,若像 Mercor 那样到 300% 则被低估。Harrison 认同它支撑 Anthropic 的价值,并补充:到目前为止 Agent 只在软件工程里真正起效,其他企业职能将远超今天,这对 Anthropic 和 OpenAI 是非常正面的信号。
推理市场、投资判断与融资
Harrison 说,从创办 LangChain 至今,他最低估了两件事:推理的需求,以及编码 Agent 的需求,两者都比他两三年前想的大得多。他引用 Benchmark 的 Eric Vishria 的说法,「everything just works」,所以 Fireworks、AWS、Crusoe 都会有需求。回到快问快答,他把「是否做 Gateway」列为过去 12 个月改变看法最大的事:一年半前和董事会讨论时,他们看不到能比 OpenRouter 增加什么价值,现在认为这个决定 100% 错误。
投资方面,主持人说客服赛道「毫无吸引力」(20 家供应商、18 个月内每家融资超 1 亿美元,还有 Salesforce、Atlassian、Intercom 等巨头),并认为机器人距离 ChatGPT 时刻还很远,人形尤其受形态所限,资金和热度远超能力。Harrison 以乐观角度回答,倒推他会押注:推理;底层基础设施原语(Modal、Temporal、Supabase、Convex),因为会有更多软件被写出来;垂直 Agent,不预设具体行业,关键是有领域专长。他提到 Patrick Collison 的说法,下一个创业方向可能是 AI 渗透率低但领域知识深厚的「不性感」领域。
他看成功团队的三点共性:人才极强(如 Fireworks 的 Lin 团队写出了 PyTorch)、速度、品牌。LangChain 当年在 100 个框架涌现时靠品牌优势活下来;对一个有顶级技术团队、已证明能快速执行的突破性公司,他的态度是「不要看价格,直接投」。先发优势真实存在(Anthropic 与 Claude Code),但不保证成功,他举了曾是史上增长最快 GitHub 项目的 AutoGPT 为反例。
被问到为 Jev(字幕写法)90 亿美元的一轮写 bull case,他认为是它们开创了一类新的推理与模型品类,品类甚至以其命名,团队有执行力,但他承认并不熟悉这支团队。
在融资部分,他说 Benchmark 对他们像「第三位联合创始人」,当时只有他和 Ankush 两个人,如今公司约 400 人。Sequoia 的 Sonia 在 Benchmark 之后两三个月加入。他描述两者风格:Benchmark 更像公司核心的陪练,在公司建设和定位上帮助大;Sequoia 则像一台机器,帮助招聘(候选人推荐)、市场与发布并落实运营。他认为为这类一线基金接受折扣是值得的。
他不喜欢融资中的「博弈」(拿到一份 term sheet 再去告诉别人、在推特上晒收入曲线),主持人则更直接地批评这种姿态。Harrison 说自己不喜欢融资,IVP 的 Tom 那一轮 B 轮是他们认识两年半后水到渠成,所以博弈更少。在快问快答中,他选 Benchmark 首次路演为最喜欢的 VC 会面,称 Bill Gurley 最酷,自己当时太天真所以不紧张;在 OpenAI(1.5 万亿美元)与 Anthropic(2 万亿美元)之间他选 OpenAI,因为通向巨大退出估值的路径更多元;最难构建的技术是自研存 Agent traces 的数据库 Smith DB;他希望自己早知道今天 Harness 的样子,最期待 AI 在创意领域的应用,如 Suno。
金句
我们得把产品的大部分不断删掉。模型变好后,六个月前必须做的事现在不用做了。 —— Harrison Chase 3:12
如果价值来自验证,赢家是领域专家,也就是能把价值量化出来的人。 —— Harrison Chase 9:21
在垂直场景里,路由必须放在 Harness 层,你要知道任务是什么、Harness 长什么样。 —— Harrison Chase 16:19
记忆最难的部分根本不是数据库,而是把观察提炼成值得放进上下文层的信息。 —— Harrison Chase 25:30
这个市场太大了,什么都能赚钱。对推理的需求太多了。 —— Harrison Chase 48:36
我曾经和董事会讨论要不要做 Gateway,我们看不出比 OpenRouter 多了什么价值,那绝对是错误的决定。 —— Harrison Chase 60:52
提到的书·产品·人物
- LangChain / LangSmith / Engine / Deep Agents / open suite / Smith DB(产品):Harrison 的公司及其产品,分别是 Agent 框架、可观测与评测、读取 traces 更新代码的 Agent、Agent Harness、内部云端编码 Agent、自研 traces 数据库。
- Cursor(公司):被引用的「删除产品」运营原则,也是借品牌势能成功的例子。
- OpenRouter / Vercel(公司):Gateway 的代表,Harrison 认为其使用量更多来自模型接入而非智能路由。
- Factory、Cognition(公司):同样主张在 Harness 内做路由,Factory 的路由技术博客被称赞。
- Claude Code / Codex / Anthropic / OpenAI(产品与公司):先发优势与追赶的例子,也是 Agent 编码支出估值讨论的核心。
- Harvey、Ramp、Reflection、Nvidia(公司):后训练或开源模型的例子。
- ClickHouse、Elastic(公司):传统数据库,用于对比面向 Agent 的上下文层。
- Instinct、Muse(产品,字幕写法):被称为在记忆与个性化上做得出色的产品。
- Fireworks、Crusoe、Nebius、Base10、AWS(公司):推理市场的玩家,主持人是 Fireworks 的投资人。
- Modal、Temporal、Supabase、Convex(公司):Harrison 看好的底层基础设施。
- Benchmark(Miles、Eric Vishria、Bill Gurley)、Sequoia(Sonia)、IVP(Tom)(投资机构与人物):LangChain 的投资方与人物。
- AutoGPT(产品):先发但未能持续成功的反例。
- Mercor、Resi、Spotify、Strava、Suno(公司):分别用于编码支出占比、Agent 流量封号、垂直应用、创意 AI 的例子。
- Patrick Collison、Mike Cannon-Brookes、Jason Lemkin(人物):分别被引用关于创业方向、Harvey 与 Ramp 自建模型的说法、对中国开源模型的看法。
适合谁听
正在做 Agent 或垂直 AI 产品、关心模型路由与编码成本,或想了解 AI 基础设施投资判断的创始人与投资人。