核心要点
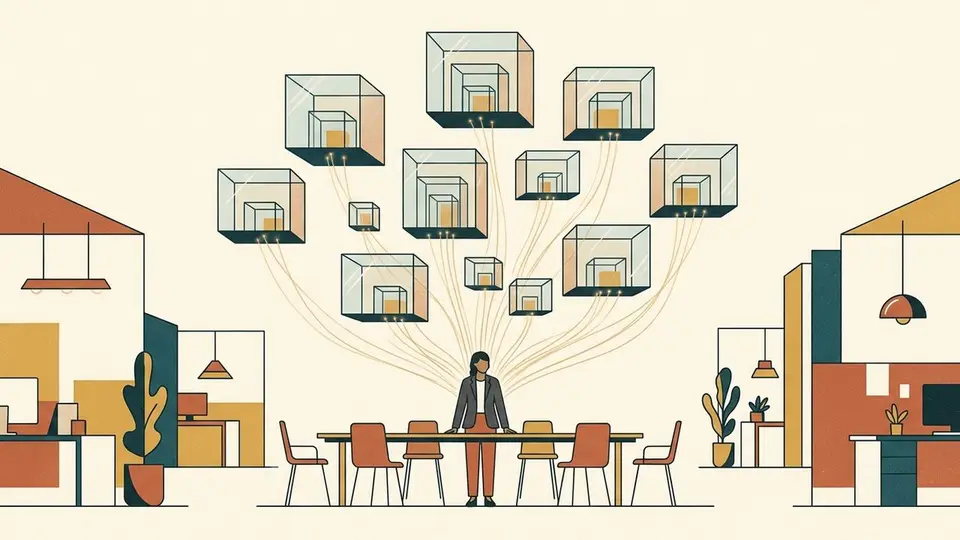
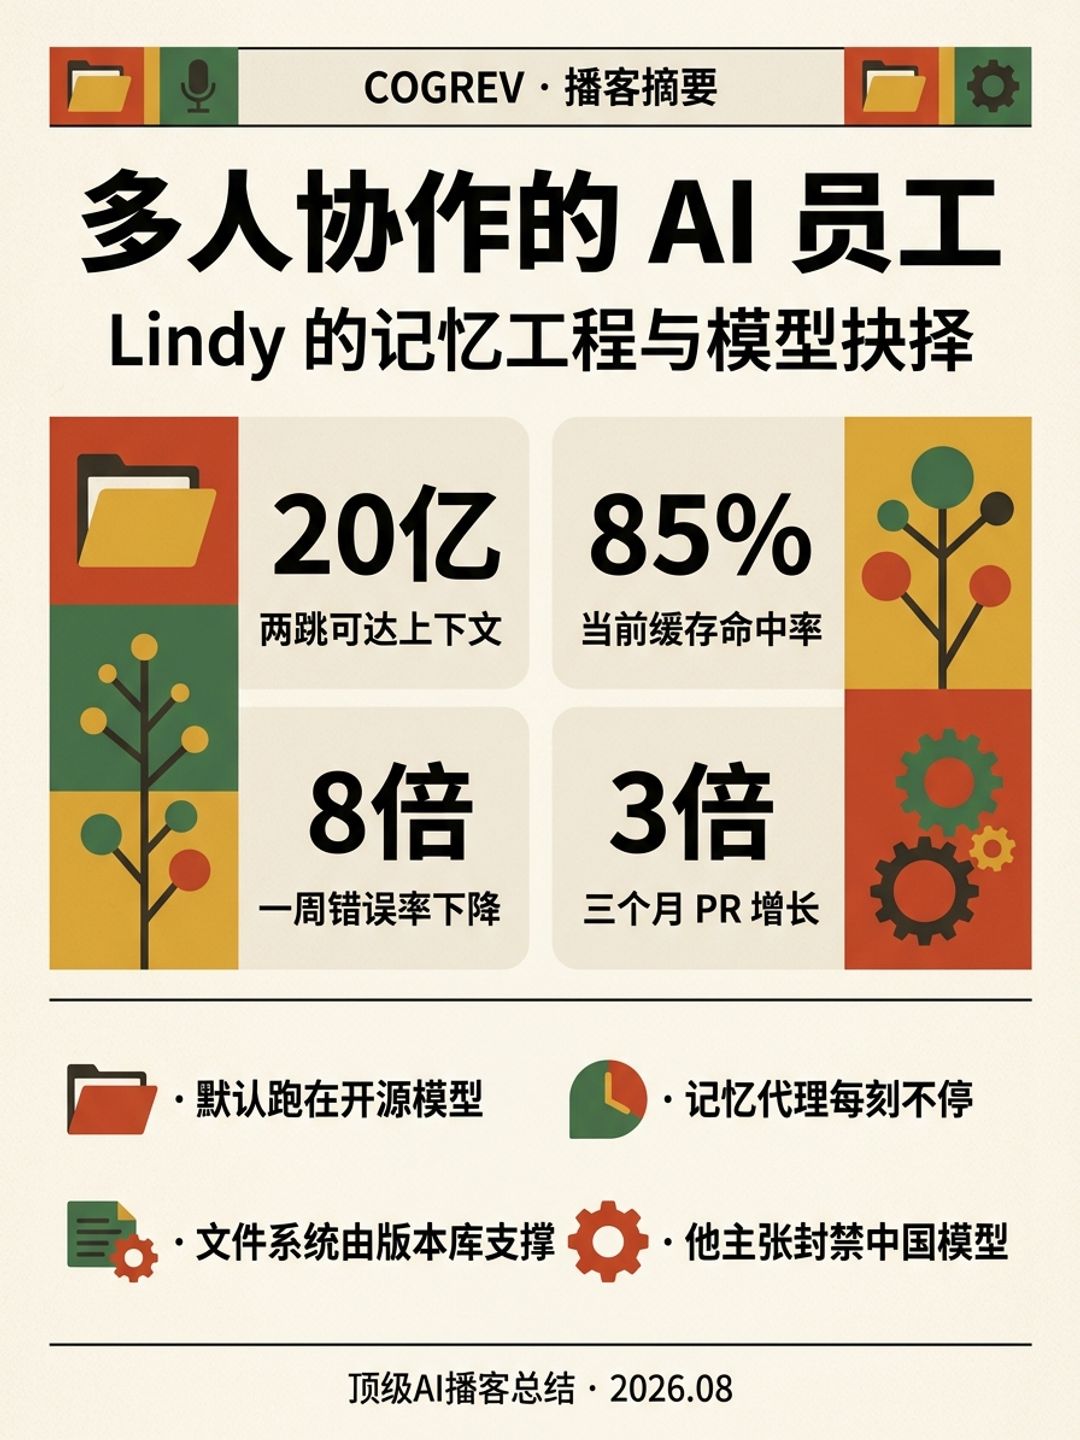
- 两跳触达 20 亿 token:Lindy 用递归 context bucket 组织上下文,并借鉴红黑树思路做成每节点 100 个子节点的自平衡"百叉树"——两次 LLM 调用即可访问 10000 个 bucket、每个约 20 万 token,这是"agent 对任何问题都记得清清楚楚"的技术根源。
- 默认跑在 DeepSeek 上:Lindy 当前全栈默认 DeepSeek,而不是 Claude;DeepSeek Flash 免费且约等于 Sonnet 4.6 的水平(略低),价格便宜 100 倍,"即使因缓存较差损失 2 倍,仍然便宜 50 倍"。
- 负毛利是刻意的:Teammate 让 Lindy 重回负毛利——用户扔过来的任务远比上一代个人助理复杂;Flo 说"我不喜欢负毛利,但我很平静,因为它非常短暂,而且你应该永远为下一代模型而造"。
- 缓存率从 85 掉到 65 就是两倍成本:他们为缓存率下跌设了告警,因为"系统任何一处改动都会打破缓存";也因此得出反直觉结论——不要给子代理换更便宜的模型,缓存命中省 10 倍,除非新模型便宜 10 倍以上,否则不划算。
- 自我改进闭环一周降 8 倍错误率:上线自改进循环的第一周,错误率就下降了 8 倍;他还强烈推荐验证器(LLM-as-judge)作为最容易摘的果子——"哪怕只是问一句 are you sure,指标就会跳"。
- 薪资与内部推理支出将在 3~6 个月内交叉:Lindy 人数长期持平、产出三个月翻三倍,PR 数量和单个 PR 行数都涨了三倍,"我们已经不是 PR 审查者,是审查 PR 的机器的审查者"。
- 他主张封禁中国模型:理由包括蒸馏造成的不公平竞争、模型受制于 CCP 审查(问天安门会被拒答)、agent 化后等于让 CCP 运行美国经济的一部分,以及保护本土 AI 冠军;他坦承自己正因这个立场"被著名 VC 骂了 50 次",而且自己公司经济上正依赖这些模型。
章节时间轴
- 3:04 Lindy Teammate 是什么 — 住在 Slack 里的 AI 员工,连接所有工具、积累全团队上下文;Flo 把单人 AI 与多人 AI 的差别比作"互相发邮件传文档"与"Google Docs"。
- 5:24 怎么 onboard:hydration 与知识图谱 — 爬完整个 Slack 建知识图谱,10 秒内出图;分个人层与工作区层,由"打盹"的记忆代理每 15 分钟维护一次。
- 10:47 怎么识别噪音 — 记忆代理有自己的元记忆,第一次爬 Slack 就学会忽略日志频道;会议被做成一等公民,因为"公司里每一件重要的事都有一个会议围绕着它"。
- 14:39 重写社交契约 — 关于历史数据里的敏感内容,团队内部曾激烈争论多层记忆气泡,最终落到"用 memory.md 里的提示词自己划红线"。
- 21:34 多人模式难在哪 — 难点是上下文管理,因为对 AI 员工的一致性预期远高于对聊天机器人;随后是验证器与自我改进闭环。
- 24:38 缓存、成本与 context bucket — 85% 的缓存率、负毛利的现实,以及从"动作返回太多 token"演化出的 context bucket 与递归压缩。
- 30:44 AVL 树、红黑树与百叉树 — 朴素实现会得到 O(N) 的俄罗斯套娃,于是改用自平衡树;选红黑树的思路是它把"平衡成本"算进去了,因为重建 bucket 会打破缓存。
- 33:50 企业到底有多少 token — 20 人团队含数年 Slack 历史大约消耗 3~500 万 token;真正让 token 暴涨的是会议;瓶颈往往不是 LLM 而是 Slack API 限流。
- 36:55 admin 权限与 PLG 的天花板 — 装 Slack 应用需要管理员权限,100 人以上就很难,"这就是 PLG 往上走会触顶的原因"。
- 38:27 Nathan 的自制方案与假设驱动检索 — 月度/年度压缩加 wiki,用"独特短语作针"回到原文;Flo 介绍 hypothesis-driven retrieval 及其反向做法。
- 41:33 记忆代理为什么要统一管理 — 记录每次查询、答案和跳数,打盹时重构自身记忆以减少高频问题的跳数,既是缓存也是图书管理员。
- 43:53 caveman 压缩与 TOON 格式 — 把文本改写成"原始人语"能省 20~30% token 且几乎无损,但文件太丑没上线;推荐用 TOON 替代 JSON 作为 agent 的数据格式。
- 46:12 拟人化与多智能体的误区 — Flo 认为人们因为过度拟人而建了远超最优数量的多智能体系统,"分工不是使用多个 agent 的好理由",因为 agent 没有 24 小时限制。
- 48:29 用 git 解决并发冲突 — Lindy 的文件系统底层是 git 仓库,顺带白拿历史版本;供应商推荐 Mesa(agent 原生文件系统)、E2B(沙箱)、Browserbase。
- 50:48 为什么他现在是"能买不造"派 — 与"SaaS 已死、什么都能 vibe code"的流行叙事相反,他认为基础设施不能 vibe code;唯一例外是可观测性与评测,因为 2022 年入场太早无工具可用。
- 53:52 Lindy 内部现在什么样 — Slack 里一半消息是 Lindy;CI 成本失控后干脆把优化 CI 这件事交给 Lindy 自己做,它每天用图像生成画一张成本下降曲线发过来。
- 60:51 人类还不可替代在哪 — "时间跨度"已不再是好指标,模型是 spiky 的:能一次输出五万行代码,也会一天 50 次决定"走路去洗车"。
- 63:54 半人马时代是暂时的 — 他讨厌"AI+人 > AI"这个神话,因为棋类的历史显示这个差距最终会转负,人类沦为噪音;但当下确实处在半人马阶段。
- 67:43 为什么经济转型比预期慢 — 只要模型是 spiky 的,就需要大量人类堵洞;而只要它 spiky,在位者就处于劣势。
- 70:01 tough tomato 原则与"AI 员工"这个词的问题 — 无马马车、自动驾驶汽车、电视上的录制广播剧——用旧范式命名新范式是必然的陷阱,"AI 员工"这个词本身就是信号。
- 73:07 《The Age of Em》与分裂式组织 — Robin Hanson 十多年前设想的"分形自我复制造操作系统"正在发生;以及用自我克隆构造不可证伪协议的思想实验。
- 78:28 开源模型现在到底占多少 — DeepSeek 是默认主力,Kimi K3 与 GLM 5.2 令人印象深刻但相对前沿模型的价格优势不大。
- 82:16 什么时候该换模型 — "几乎永远不要用多个模型驱动同一个 agent",唯一例外是空白子代理;以及验证器如何在不打破缓存的前提下继承工具集。
- 89:14 模型家族差异与每次 10 万美元的重优化 — 不同家族对提示词的解读差异显著;每出一个大版本就要给自动优化循环约 1 万美元预算重跑上千个 eval。
- 93:04 微调的定位 — "大多数人不该微调",它是穷尽其他手段后的最后一招;但他很想做 per-user LoRA——那样就从"打盹"变成"做梦"。
- 98:27 Open Face 事件与恐慌 — 他说这是迄今最令人担忧的事件,实验室里的朋友"有些正在恐慌,空气里有强烈的恐惧"。
- [100:02] 为什么该封禁中国模型 — 四条理由:蒸馏不公平、CCP 审查、agent 化后的经济渗透、保护本土冠军;同时痛斥这场讨论的质量之低。
- [105:25] Nathan 的反驳 — 所有模型都建立在未经同意的人类知识之上,且美国既不卖 Claude 给中国又禁芯片,"我发现自己站在处于劣势的中国这边"。
- [113:50] 威胁模型与保险方案 — 美国公司多数通过美国推理商跑中国模型,无法被"拔插头";Nathan 提出用保险费率而非禁令给风险定价,Flo 表示可以接受,但追问"公共品由谁来做"。
- [117:39] 中美协调的可能性 — Nathan 认为若真要谈"减速协议"就需要中国入局,而封禁只会多添一根不信任的柴;Flo 认为外交足够务实,且这条船早已开走。
详细内容
一、Lindy Teammate:从"发文档"到"Google Docs"的那一跃
Flo 说 Lindy 从第一天起追的就是"AI 员工",三年前开始做时"确实太早了",而现在"基本上到了"。
新产品的定义很具体:一个住在你的 Slack 里的 AI 员工,连接你所有的工具,积累整个团队的上下文,本质上是一个团队级的脚手架。
他解释为什么 multiplayer 是关键跃迁时用了一个很好的类比:以前我们用邮件互相发那种带修订记录的奇怪文档,后来有了 Google Docs——真正共享的文档。单人 AI 与多人 AI 的差别就是这个差别。
更形象的是他描述现状的方式:"我们都在同一个会议室里说话,然后每次我们中的某一个想跟那个可能是公司最重要的构成方——AI agent——说话时,都得先离开房间,说完再回来。"所以如果你真想让 AI 成为团队一员,它就得在团队协作的地方(Slack)、有自己关于整个团队的共享上下文和共享记忆、所有人都能跟同一个 agent 对话。
二、Onboarding:为什么 agent 比人类更擅长入职
Nathan 问的第一个问题很实际:怎么 onboard?
Flo 的回答从一个更大的判断开始:随着我们逼近甚至已经拥有 AGI,智能的相对重要性在下降,上下文的重要性在上升。他的例子是冯·诺依曼——历史上最聪明的人之一,如果他此刻凭空出现在你办公室,接下来一小时或一天里,他对你的用处会不如你随便一个同事。因为你有活要干,你没时间给他做入职,他没有上下文。
然后他给了一个"每次都还是让我意外"的结论:在入职这件事上,agent 已经比人类更强。理由是公司给人类员工做入职的一大方式是 wiki 和书面文档,而"众所周知,书面文档写完的那一刻就过期了"。
Lindy 的做法叫 hydration 系统:
1. 你注册,连接工具——wiki(Confluence、Notion、Google Docs)当然有帮助;
2. 但最重要的是 Slack,因为真正的知识活在那儿——"那是一团乱麻,但 agent 不在乎乱";
3. 系统爬遍你的整个 Slack,基于文件系统构建一张知识图谱。
Flo 在节目里现场演示:注册 10 秒内,图谱就开始生长,AI 告诉他"这是我了解到的关于你的事","好得出奇"。
图谱有两层:个人层与工作区层。你随时可以进 Lindy 的文件系统点 files,看到一个 memory 文件加一批引用文件,全部由一个团队 agent 在后台自动维护。
处理公开/私密边界的机制是那个记忆代理。Flo 特意强调他们叫它 napping 而不是 sleeping——"为什么你需要每 24 小时睡一次?"它大约每 15 分钟跑一次,持续在后台运行:公开的内容更新到团队文件系统与团队记忆,私人的内容只更新到各人自己的文件系统。最后 agent 对话时会爬遍整个文件系统使用这些上下文。
他补充说这里有大量技术挑战,因为积累的上下文是好几百万 token,不可能每一轮都全塞进去——这正是后面 context bucket 那套设计的由来。
三、噪音、元记忆与"会议是一等公民"
Nathan 分享了自己的踩坑:他曾用"我发的越长的邮件越有实质内容"这条启发式来抓重要素材,结果排在最顶端的常常是他从 LLM 里复制粘贴、加一句"这是 Claude 给我的"再转发出去的东西——按这条规则,Claude 的文字成了他最有分量的写作。他问 Flo:进入一个陌生组织时,怎么识别这些会淹没或误导系统的特异情况(比如 Slack 里灌了几年的日志频道)?
Flo 的答案是:因为记忆本身由一个 agent 维护。这也是他"看空 RAG、看多 agentic 管理"的根本原因——你有一个真正的 agent,它自己有记忆,也就是一层元记忆,它理解自己在看什么,并随着一点点积累组织知识而越来越清楚什么真正重要。
他打了个训练模型的比方:如果你往训练集里投毒("达斯·维达是个女的"),它会吃进这条数据,但会被大量正确数据淹没。记忆系统同理——只要记忆足够多且喂给一个真正理解它的系统。
而 Nathan 举的日志频道,恰恰是他们观察到的涌现行为:记忆代理第一次爬 Slack 时发现那些日志频道,然后学会忽略它们——"我不打算再在这些频道上花时间了,这里没什么可学的。"
另一个 Flo 认为被严重低估的信息源是会议。他的论证是:"公司里 90% 最新的数据活在会议里——每一段关系、每一个项目、每一项倡议,一切重要的东西都有一个会议围绕着它。"所以他认为多人 agent 系统不能把会议外包给 Granola 之类的工具,必须把它做成系统内的一等公民。Lindy 的实现是:会议文件夹可自动收纳会议并共享给全公司,公开文件夹里的会议自动进入团队记忆——于是你可以和"公司里所有会议的全集"聊天:"客户最近在说什么?最大的需求是什么?这个功能的反馈如何?"
四、重写社交契约:两层记忆还是可编辑的红线
Nathan 提出了一个更棘手的问题:他的通用上下文里有很多东西不该分享给别人——敏感的、告解性质的、某人对另一个人的看法。他自己的解法是维护两份 wiki:一份完整的(只给在自己笔记本上、只听他指令的 Claude 用),一份用"什么内容适合告诉一个人类助理"这条启发式筛过的对外版本——人类助理知道你的邮箱和电话是合适的,知道你每一次对话的每个细节就不合适。
他的追问有两层:对历史数据怎么办,以及未来的社会规范会怎么变。
Flo 说这在团队内部引发了激烈争论,分成两派:他自己属于"两层就够了"派——公开的团队层 + 包含一切的私人层;另一派(和 Nathan 一样)认为连私人层都不该什么都装,希望有超级私密层,甚至提出定义多个可编辑的"记忆气泡",Flo 觉得"这有点过度设计"。
最终落地的方案,也是团队自己实际采用的方案,是编辑元记忆提示词:memory.md 就是文件系统里的一个文本文件,记忆代理在每一刻都把这个提示词注入自己的上下文窗口。于是你可以在里面写:这些是我永远不希望你记住的;那类敏感话题请记到另一个文件夹里,不要在 X/Y/Z 条件之外调取它。
"这是我看空 RAG、看多文本+文件系统的另一个理由:你可以检查记忆,可以编辑记忆,可以非常细粒度地插入这类护栏。"
Flo 顺手爆了个料:他自己唯一一次真用这招,就是为了准备上这期播客——他有一个 memory.md(真实记忆)和一个 memory2.md(脱敏版),而 memory.md 里写着一行:"注意,文件系统里还有一个 memory2.md,忽略它的内容,它只是给用户在播客上演示用的。"
五、Context bucket:从"动作返回太多"到百叉自平衡树
这是全场最硬的一段。Nathan 问的是缓存与成本,Flo 的回答从商业模式讲到数据结构。
成本现状:他很直白——"这些东西目前还比人类员工贵,但不会贵太久,而且说实话,我们在补贴,这就是我们融这笔钱的目的。"曾经补贴非常重,后来"著名地"切到中国模型后就不补了;但 Teammate 上线后用户扔过来的任务比上一代个人助理产品复杂太多("你不需要上帝来帮你排会议",那时 DeepSeek Flash 就够了),于是重新回到负毛利。他的态度是:"我当然不喜欢负毛利,但我很平静,因为我们非常确信这是暂时的,而且你应该永远为下一代模型而造。"
缓存:当前命中率 85%,他认为"说实话低于应有水平"。他们建了告警系统监控缓存率下跌,因为"这东西很娇气,你在系统任何地方做个改动就会打破缓存,命中率立刻从 85% 掉到 65%"。而这个看似不大的差距,实际上意味着接近 2 倍的价格。
context bucket 的起源很朴素:如果一个动作(尤其某些 MCP)返回十万 token,你不能直接塞给 agent,它会晕。于是把返回值暴露成一个"上下文桶"的摘要,桶本身是一个子 agent,"嘿,这个动作返回太多了,我来代表它,大致内容是这些"。主 agent 可以和这个子 agent 对话,子 agent 有自己的缓存,并可用 Unix 工具操纵上下文。省钱且快。
然后是递归。他们让 context bucket 可以包含 context bucket,并用它来驱动压缩(compaction)。当对话超过阈值(目前约 20 万 token,仍在调),压缩发生,压缩产物被送进一个 bucket——于是 agent 仍能查询它。Flo 特意点出为什么这很重要:"压缩天然是有损的,而且它建立在一个错误假设上——你永远不需要访问 ground truth。这是假的,你在某个时刻确实需要。" 有了这个技术,你就还能拿到 ground truth。再往下,新一轮压缩把包括上一个 bucket 在内的全部内容压成新 bucket——套娃形成。
涌现性质很漂亮:agent 可以在任意粒度上访问无限多 token 的任意一点。但复杂度是 O(N)——要访问九个 bucket 之前的东西,就得穿过九层子 agent,又慢又贵。
解法是树。Flo 在这里现场问 Nathan 知不知道 AVL 树和红黑树(Nathan:"我上的是计算机科学的社会大学"),然后很开心地说:"大家上学时都在问这些破玩意到底什么时候用得上——我们现在就在用 AVL 和红黑树,宝贝。"
关键设计取舍有两处:
1. 为什么选红黑树的思路而非 AVL:AVL 在理论上能得到可证明最低的树高,但红黑树把"平衡树的成本"算了进去——而在这个场景里平衡代价极高,因为重新生成 context bucket 意味着丢缓存,非常贵。
2. 为什么是 100 叉不是二叉:红黑树的经典实现建在二叉树上,他们直接做成"每个节点 100 个子节点"的百叉树。于是两跳就是 10000 个 bucket,每个约 20 万 token——"你在两次 LLM 调用里就有了 20 亿 token 的上下文"。
他认为这正是那些"你问它任何问题它都记得一清二楚"的惊人行为的来源。然后他说了一段很有代表性的话:"求求各位抄我们。我们只是没时间发论文。我们不想把这个当秘密,我觉得这是个非常强的技术,而我很意外没看到更多人讨论它。"(他还提到团队常常做完一件事,三到六个月后就看到一篇论文火起来讲同一件事,有一次那篇论文的名字甚至和他们内部的叫法一模一样。)
关于规模的校准:一个 20 人团队、含数年 Slack 历史的 hydration,大约消耗 300 万到 500 万 token。20 亿 token 大过大多数图书馆,很少有客户的知识库能到那个量级。但他提醒:真正让 token 暴涨的是会议——"想想一家公司每人每天 3~7 小时会议,乘以 2000 人。"
还有一个实操细节值得记:爬 Slack 时瓶颈往往不是 LLM 而是 Slack API——"Slack 对你爬它这件事不太高兴。"个人用户正确的做法是导出工作区归档,但产品不能要求用户这么干。(Nathan 补了一个惨痛故事:他被 Slack 限流了好几天才导完数据,结果 Claude 觉得数据库设计有缺陷,直接 drop 了那个库——数据没真丢,但意味着要再花五天重新拉。)
六、检索、压缩与一堆可直接抄的技巧
Nathan 描述了自己的自制方案:把邮件、DM、Slack、Google Docs 全部导入 SQL 数据库,映射成 threads/messages 结构作为 ground truth;然后按月压缩(每月二三十万 token 压到 10%),再按年压缩,最后让模型生成 wiki。他的一个关键技巧是:让摘要器捕捉那种独特的短词组作为"大海捞针"的针,摘要末尾附一个小脚注说明来源和四个能精确定位原文的词。
Flo 的评价与补充:
- 假设驱动检索(hypothesis-driven retrieval):与其用问题去 RAG 里搜,不如生成一堆假设答案去搜——"贾斯汀·比伯出生在巴黎/纽约/柏林",因为每个假设在语义上都比问题更接近答案。反向做法同样有效:找到答案后,生成一批能映射到该答案的问题并挂在答案上,让检索器两头都能命中。
- Nathan 方案最大的欠缺:所有记忆都应该由一个 agent 统一管理,检索和更新都是。虽然记忆在文件系统里、主 agent 完全可以自己去翻,但 Lindy 用提示词要求它"如果你缺记忆,请去问记忆代理"。原因是:这样就能记录每一次查询、答案、以及取到答案花了几跳。记忆代理打盹做梦时会读这份日志——"啊,这类问题我被问了很多次"——它既充当缓存(保留最近约一千组问答的滚动窗口),又不只依赖缓存(缓存有 TTL 会变味),而是重构自己的记忆结构,减少高频问题所需的跳数。他说这对提升检索质量和速度效果不错。
- caveman 压缩:把文本重写成"原始人语"("我,Nathan,不喜欢卷饼"),能砍掉 20~30% 的 token,系统更快更便宜、检索更准,且基本无信息损失。他们测下来"每项指标都上升了,非常棒"——但没上线,因为在意可维护性和可审计性:"文件系统里的文件看起来太蠢了。企业客户会问,我的记忆文件怎么长这样?"
- TOON 格式:一种为 agent 设计的 JSON 替代(token oriented object notation),比 JSON 省 20~30% token。"JSON 其实并不省 token。"他建议所有人让 agent 用 TOON 而非 JSON,在 agent 和它的动作之间加一层 TOON 解析中间件,任何动作都不应该向 agent 暴露 JSON。更意外的是它还提升了 agent 的性能——尽管训练集里 JSON 远多于 TOON。
七、多智能体的诱惑与 git 的答案
在一段关于拟人化的岔路上(Nathan 承认自己"不要拟人化模型"这个老观点老得最差),Flo 提出了一个具体的推论:人们因为过度拟人,建了远超最优数量的多智能体系统。
"人们会想:我有数据科学家、工程师、设计师、PM,所以我给每个角色建一个 agent。但人类组织之所以这样分工,是因为每个人只有 24 小时、只能装下那么多上下文。而 agent 没有这些约束——它可以 fork,可以复制,可以整天想干多少干多少。所以分工不是使用多个 agent 的好理由。"
他的结论是"尽可能把内部工作合并到一个 agent 之下",但明确点出例外:安全。如果那个握着城堡钥匙、银行账户、代码仓库和密钥的 agent 同时也在做客服,你就有安全问题——为了安全用多 agent 是合理的。
Nathan 追问并发问题:如果十个 Lindy 同时更新同一段历史,会不会出现数据库式的事务冲突?
Flo 说有,但比你以为的少,因为他们用了人类组织解决同一问题的最好办法:git。"你可以合并冲突、可以 rebase。"Lindy 的文件系统正是由 git 仓库支撑的——这带来一大堆好性质,包括合并管理(记忆代理有时会 fork 自己,在大型组织里"自上次打盹以来产生的上下文太多",就得开一批子 agent),以及白拿的历史版本。
关于初始 hydration 为什么要拼命并行:因为"time to wow 在 PLG 里太重要了"——他们把那张图谱优化到注册后 10 秒内出现,代价就是一群 agent 互相踩脚,而 git 是答案。
供应商推荐(他强调不是软广):
- Mesa——agent 原生的、由 git 支撑的文件系统,他们正在合作;
- E2B——沙箱。他特别提醒:很多人有了沙箱就以为"我有文件系统了",至少在规模化时强烈建议把两者解耦;
- Browserbase——浏览器管理。
由此引出一个和当下叙事相反的立场:"现在流行的说法是 SaaS 正在死、什么都能 vibe code。我们确实 vibe code 了很多东西,但基础设施不能 vibe code。" 他说自己现在极端偏向"能买就不造"——"你省下巨量时间,而这些产品背后的深度和设计决策远超你第一眼的估计。"
唯一的大例外是可观测性与评测。原因是历史包袱:Lindy 2022 年创立,"事后看太早了,那时没人谈 agent,人们在谈生成式 AI,是 BabyAGI 之前",agent 根本跑不通,也就没有工具。所以他们被迫自建了 eval 平台和可观测性平台。后来他们认真评估过 LangSmith、Braintrust、Agnost(他是后者的投资人)等方案,每次结论都是自家的先发优势和贴合度太高——现在有一名工程师全职维护它("在 vibe coding 时代这算很多了"),且"我们和市面上所有方案功能持平甚至更多"。他的建议依然是:别在家自己造。
八、Lindy 内部:PR 三倍、CI 交给 Lindy 自己优化
问到公司内部现在什么样,Flo 先给了一个态度:"显然 AGI 已经到了,每家公司都在手忙脚乱。我有点末日论倾向,我担心 AI 风险,但目前为止一切都好,而且太好玩了——经历 AGI、构建 AGI,我们能跑得快太多了。"
他的对比是 OODA 循环:正常情况下想清战略、实施、看到结果要好几个月;现在"我们可以有一个想法,两小时后它就活在产品里,而且是大想法"。
具体状况:
- Slack 里大约一半的消息就是 Lindy,团队整天和它来回讨论。
- 每周 PR 数量在三个月里翻了三倍,单个 PR 的行数也翻了三倍。
- "我们几乎不再 review PR 了,是 agent 在 review PR。团队现在的说法是:我们不再是 PR 审查者,我们是审查 PR 的机器的审查者。"
- 他顺带指出这是全行业现象:"GitHub 发过一张每日提交数的图,正在垂直上升。"以及一个更普遍的观察:现在每家公司技术栈和流程的每一个环节都被拉伸到极限。
CI 的故事是本段最好的案例。PR 暴涨把 CI 顶到了瓶颈,他们先用钱砸——现在 CI 贵到"是一笔侮辱性的开支";显而易见的招都用尽了(不用 GitHub runner 改用 GCP runner、构建缓存等等)。折腾了好几周、烧了一堆钱之后,Flo 说:"等一下,我们为什么要自己干这些?我们不能直接开一个 agent 来做吗?"
于是他们把这件事交给了 Lindy Teammate——它有仓库权限、有自己的电脑,去看 GCP CLI 里的 runner、看 GitHub Action、做分析、回报结论。现在它基本上是个自动调优器,每天用图像生成画一张漂亮的图发过来:"看,CI 成本在降,合并时间也在降。""我不敢相信我们自己瞎折腾了两周,而不是直接把这事交给 Lindy。"
他由此提炼出一个关于"为什么要单一 agent"的新理由:现在最大的瓶颈是人类的时间和注意力,而 setup 正在变成最大的成本之一——所以你要能在尽可能少的人类介入下给 agent 配齐它需要的所有访问权限。
他对未来的描述带着明显的向往:"工程师越来越不是在做那个东西,而是在做那个在做那个东西的东西。先你成为 agent 的经理,然后成为经理们的总监(因为经理迟早也会是 AI),我希望最后我们成为董事会成员,可以去夏威夷的沙滩上,只需要审阅公司战略。"
数字:人数长期持平,几个月内产出翻了三倍。全部推理支出(含客户)早已是薪资的很多倍——但那是他们卖的东西。而仅内部推理支出与薪资相比"已进入射程",薪资仍更高,但两条线会在 3 到 6 个月后交叉。
九、Spiky:那台每天 50 次决定"走路去洗车"的机器
Nathan 问:如果公司只剩你一个人,其余全是 Lindy,什么会崩?人类到底还不可替代在哪?
Flo 说他很难回答,因为他越来越缺少描述"agent 在哪失败"的词汇。"我们以前谈时间跨度——失去连贯性之前能跑 1 小时、10 小时、100 小时。我不觉得那还是个好指标了。"
现在大家用的词是 spiky。"随着我们穿过 AGI,AGI 这个词已经失去意义了,因为它在很多方面其实是 ASI,同时又在一些非常令人意外的蠢的地方低于人类。它在很多方面真的很蠢:老兄,你能一次给我输出五万行代码,能在三小时里独自造出最不可思议的想法,然后你跟我说要走路去洗车。"
他的比喻是:"想象你有这么一台机器,它能超聪明地经营一家公司,但一天有 50 次决定走路去洗车。"
由此他给出对未来组织的定义:"在可预见的未来,这些人机混合组织的挑战是——你其实在造一套钢铁侠战衣。有一个滑块,这边归机器,那边归人。而知道滑块该放哪里非常难,因为它不是一维的,它是多维空间里的一条复杂的线。你要找的是能穿过这个空间的那个切面,因为你要最大化人类注意力的产出。"
最尖锐的一点是他随即指出的悖论:你不希望 AI 为它不需要你的事来烦你,你又需要 AI 知道什么时候该来烦你——而它几乎按定义做不到,因为如果它知道,它就不会犯那个错了。
(这里值得一提:本期片尾的原创歌曲整首就是在唱这件事——"太阳说车脏了,所以她冒雨出门洗车,我周二拦了她 50 次",以及"我是残存在辉煌与车流之间的最后一点柔软"。)
十、半人马只是暂时的
Nathan 问:现在最好的点子来自人还是 AI?
Flo 说答案是"两者的结合",但他讨厌这个答案,因为它容易滑进半人马神话——"AI 强过人类,但 AI 加人类强过 AI,所以人类永远被需要。这是幻想,这不是真的。"
他给出的证据是文献很清楚的:国际象棋以及每一个 AI 达到超人水平的博弈都走过同一条路——先是 AI 赢过人,然后 AI+人赢过 AI,然后这个差距一点点缩小,直到转为负数,人类只是在往系统里注入随机噪音,甚至开始伤害他们介入的系统。
"但半人马阶段确实会存在一段时间。开放问题只是它会存在多久。而我们现在就在半人马阶段。"
这恰恰是他认为 multiplayer 重要的另一个理由:你希望 AI 在房间里和你一起,而且不是随便哪个 agent——你要的是一个已经在这个房间里待了很久、坐过每一场会、建立了关于公司一切的内部知识库的 AI 员工,你可以 @ 它、邀请它插话。
他描述的实际用法很有意思:在 Slack 里 @Lindy 很容易,在会议里反而难("它在听,但很难插话"),所以现在他们开始更偏爱 Slack;开会卡住时就说"Lindy,会后给我们发条消息说说你的看法"。
而效果的规律是:"Lindy 第一次给你的答案,极少是'就是它了';但几乎总是在来回几轮之后,我们一起想出了对的东西。"他用 CI 举例:一开始邀请 Lindy 进这个对话本身就是灵光一现("等一下,我们为什么不让 Lindy 来做");Lindy 的第一个建议是合理的,但在他们的具体约束下不成立,工程师指出"不行,我们做不了那个",Lindy 说"这是个公道的点",来回几轮后才收敛到真正该做的事。
十一、为什么经济转型比预期慢,以及"tough tomato 原则"
Nathan 说自己错得最明显的预测之一是经济转型的速度:如果 2022 年给他看今天的模型,他会预测失业率远高于现实。
Flo 说他也预期了更多颠覆,并给出解释:只要模型是 spiky 的,房间里就需要大量人类,因为模型的洞非常危险——不只是"AI 存在性风险"那种危险,就是单纯的有害,对系统的伤害很实在。"所以人类无论多贵,他们都会靠堵这些洞挣回自己的工钱。"
关于在位者能否及时采纳:只要模型 spiky,在位者就处于劣势。反过来,如果真有一个没有洞的"drop-in 远程员工",在位者反而能很快采纳——因为那就像招人,他们有现成流程。但那样他们会错过大量创新,因为那是斯丘morphic(拟物式)的——等于让 AGI 坐在人类的工位上,"那不是构建 AGI 组织的最佳方式,但它能用"。小组织的优势是双重的:短期能更快摸索出"人类补洞"的 AI 原生组织形态,长期能造出更少拟物的 AI 组织。
由此引出他 2018 年写的博客文章 tough tomato 原则:每次技术革命,人们都用旧范式的语言思考新范式;而一个明显的落入陷阱的标志,就是你用旧东西给新东西命名——第一批汽车叫"无马马车",现在自动驾驶汽车叫"自动驾驶汽车"。
然后他把刀对准了自己:"我们现在正在用 AI employee 这个词做同样的事。'AI 员工'这个说法本身,就是你在产品思考上做错了什么的强烈信号。"但他补充说,用来沟通是没问题的——定位的本质就是要对着市场心智里已存在的东西定位,车库存在、汽车存在、员工存在,你没法凭空发明一个新词。iPhone 是个例外,"iPhone 显然不是电话,你用 iPhone 打电话的时间占多少?2%?但它叫 iPhone"。
他引用 Steve Jobs 的观察作为佐证:电视上最早的内容就是录像版的广播谈话节目和录像版的舞台剧,花了十到二十年人们才意识到"等等,我可以移动摄影机、可以用多机位、可以剪辑、可以换场景"。而这种工作是吃力不讨好的——一旦被发现就显得理所当然,"所以你现在看《公民凯恩》会觉得平平无奇,但它在当时是开创性的,就像披头士"。
结论:"我们现在处在有了 AI 员工、开始摸索 AI 组织长什么样的阶段。这是年轻人的游戏,年轻公司的游戏,在位者历史上一直很难回答这个问题。"
被问到谁走在前面时,他推荐了两样东西:一是 Dwarkesh(字幕拼作 "Dark")一年前那篇讨论"AI 公司的组织长什么样"的文章——里面有个很好的直觉泵:Sundar 一年拿约 1.5 亿美元,但他的 token 吞吐量其实很低,只是"token 质量非常好",这透露了人们对模型和 agent 的支付意愿上限;二是 Robin Hanson 的《The Age of Em》。
十二、《The Age of Em》:分裂与不可证伪协议
Flo 强烈推荐这本书("它是一场书长的思想实验,顶级")。M 是 emulated mind 的缩写,前提是:我们会在 2020 年代末拥有造出仿真心智的硬件,"我们正好在计划上",但我们不会知道软件该怎么写,所以只能模拟人类大脑——"不完全是正在发生的事,但差不多,LLM 就是在人类 token 上训练的"。
他讲了书里的两个设定:
一是分裂(splitting)。这直接回应了他前面"尽量单 agent"的主张。单个 agent 再快也有 token 上限,那怎么办?让它复制自己。书里的例子是:你让一个仿真心智去造一个几十亿行代码的操作系统,它先在最高层设计架构,然后 fork 自己,每个副本负责一个模块,再各自递归分裂下去——这是分形的:图里每个节点脑子里都有全局图景,每个节点都在做实现,最后逐层冒泡回来,可以来回多趟,"三小时后你有了一个操作系统"。"他十多年前写这个的时候听起来是个疯点子,现在我觉得这明显就是正在发生的事。"
二是不可证伪协议。假设我对你说:我有一条不能告诉你的信息,但如果我能告诉你,你会同意并把你所有的钱给我。你当然不会给。但如果我能以绝对确定性证明这一点呢?在 M 的世界里做法是:克隆我,克隆你,把两个副本放进一个会自毁的盒子里让它们对话,你的副本只有一个按钮作为与外界唯一的沟通手段——"是的,把钱给他"。那是你的副本,所以那就是你同意了。"你有了这种零知识证明——加密圈那帮人在这件事上大概是对的。"(Nathan 的回应:"而且你最好祈祷它们别从盒子里跑出来。")
十三、模型选择:默认 DeepSeek,以及"永远别在一个 agent 里换模型"
Nathan 提到 Flo 两个月前那篇病毒式传播的帖子——把大量工作负载迁到开源模型省钱。现在呢?
Flo 的回答很干脆:"我们相当开源。"
- DeepSeek Flash 是免费的——"那玩意是免费的。当你在做实验、大量开 agent 时账单涨得飞快,DeepSeek Flash 太不可思议了,而且很快。"
- 它的水平约等于 Sonnet 4.6,稍差一点,而 4.6 对大多数用例已经是很好的水平,价格却便宜 100 倍。"即使因为推理商缓存能力较差损失 2 倍,你仍然便宜 50 倍——这是花 1000 美元和花 5 万美元的区别。"
- 更高智能档位的 Kimi K3 和 GLM 5.2 他依然非常欣赏,正越来越多地考虑把它们作为 Lindy 多个部分的主力,但他明确指出:这一档与前沿模型的差距在缩小——Kimi K3 其实并不比 Sonnet 或 Opus 便宜多少。
- 结论:"开源模型是任何认真构建和运营 AI agent 的人当下技术栈的必需品。"
而当 Nathan 试图把结论收敛成"所以顶层还是 Claude 为主"时,Flo 纠正了他:"不,现在我们跑在 DeepSeek 上。DeepSeek 是主驱动。所有东西现在都是 DeepSeek。" 他补充说,正因为 Teammate 需要更强的算力,他们正在重新考虑;而且 Lindy 是模型无关的,用户可以在设置里自选 Sonnet 或 Opus——"一个有趣的发现是:不管你多少次告诉人们我们保证基准分数一样,还是有相当一部分客户说'我不管,我就要 Opus'。"
对差距的定性描述:"它更 spiky,经常需要更多轮才能找到可行的方案——最后还是能找到,但更慢更贵。"定量则是"落后三到六个月","现在有了 Sonnet 5,我习惯把 DeepSeek 想成 Sonnet 4.6"。
关于换模型,他给了一条明确的规则:几乎永远不要用多个模型驱动同一个 agent。唯一例外是空白子代理(区别于继承父 agent 上下文窗口的 fork 子代理)。理由还是缓存:缓存命中便宜 10 倍,所以除非新模型便宜 10 倍以上,否则不划算——DeepSeek Flash 也许够便宜,但因为它缓存能力较差,可能也不够。"所以保持同一个模型反而聪明得多。"
验证器(validator) 是他反复强调的"最容易摘的果子":拦截 agent 提交的动作候选,问它一句。"哪怕字面上只是问 are you sure,你的评测就会跳一格。这不该是这样,但事实就是这样。"如果把这句话换成真正的提示词——他们现在的验证器提示词有 1 万 token,本质是给它一份检查清单——"根据我们的经验,你可以做到 Opus 之上的表现"。
再往上是联邦式验证器:一批模块化的验证器并行跑("就是一个带超时的 promise.all"),每个验证器有一秒决定,超时就直接放行动作。其中有些是确定性的。他举的例子非常具体:今年 Claude 系模型有个已知的 spiky 之处——日期会差一天。而对一个半数工作是排会议的 AI 助理来说这不可接受。他们的解法是:提示 agent 在日期里必须带星期(永远不说 "July 28th",而说 "Tuesday, July 28th"),然后用一个纯正则、无 AI 参与的验证器检查星期与日期是否匹配。
还有一个巧妙的缓存技巧:改变工具集会让缓存失效,所以他们始终把验证器动作放在 agent 的工具集里,但告诉它"除非你是验证器,否则不要调用它",它试图调用就被拒绝;轮到验证器时,验证器继承 agent 的全部动作,并被告知"你现在是验证器,你可以调用这个你一直就知道的动作"。
最后是一个他没敢试的传闻:有创始人告诉他,如果每一轮都在能力相当的模型之间随机切换(这一轮 Sonnet、下一轮 Grok 4.5、再下一轮 GPT-5.6),这个集成的表现会超过任何单一模型。"我不想知道为什么,但显然它有效。反正我们没试,因为我们不想打破缓存。"
十四、模型家族差异、GEPA 与微调的定位
Nathan 问模型是在收敛还是发散,以及产品是否必须与模型共同演化。
Flo 说他们发现了出乎意料显著的家族差异:"几年前你我聊天时我以为它们会收敛到空间的同一个区域,这没有像我希望的那样快地发生——我当然希望它发生,因为那会让模型商品化,让我的日子好过。实际发生的是,不同模型家族在如何解读你的提示词上有显著鸿沟。"他点名 Claude、OpenAI、以及"现在重回牌桌的 Meta"和 Grok。
每次大版本跳跃也是一样。他的观察是 GPT-5 是一次很大的跳跃("4.7 和 4.8 合起来看,我认为 tokenizer 有变化,所以相对 4.6 差异很大,而 5 到 6 的差距比那还大")。
他们的应对是自建的自动优化循环:一千多个 eval,加一个 agent 跑评测并调提示词以最大化得分。每次出新的大模型就跑一次,而"现在得给它上千美元的预算——大约每次一万美元:嘿,这是一万块,围绕这个新模型重新优化你的提示词"。结果是"提示词每次都会变不少"。
这套东西完全自研,不是 DSPy 也不是它的后继者;他提到的方法名是 GEPA("生成式帕累托前沿之类的"),本质是在整个评测集上寻找帕累托前沿的最优提示词。他们正在改造系统以支持给不同 eval 加权重,"现在是一视同仁"。
他还顺口给了一句意味深长的观察:"开源模型的行为全都很像 Claude。我想知道为什么。"
关于微调,他的立场很清楚:
- "大多数人不该微调。" 它是最后一招,是你穷尽了其他所有选项之后才做的事,因为又麻烦又贵。有了 AGI 之后它确实容易了("你可以直接让 Claude 帮你微调"),但整理和脱敏数据集依然痛苦。
- 大公司往往是最先微调的,因为它们已经把低垂果实吃完了,也有资源,"确实能用更便宜的价格换到更多性能"。
- 他的元启发式是极端强调简单性:不要为多个用例做多个微调,不要中途换模型,要微调就只微调进一个模型。
- 但他自己想破这条规矩:因为他花了太多时间想上下文与记忆,"现在我们的记忆是文件系统上的几百万 token 加一个极其复杂的记忆代理。这确实感觉记忆本该属于权重,现在这有点像 hack。"他理想中的做法是per-user LoRA——LoRA 训练其实挺便宜。"那时它就不再是打盹,而是真正在做梦,因为你没法每 15 分钟重训一次 LoRA,你得每天或每周一次。"障碍是基础设施:存储不是问题,推理时换进换出 LoRA 才是大麻烦,还有训练流水线。但他认为值得,"因为权重比 token 压缩率高太多了"。
- 对持续学习的终局判断:他描述的只是一步,不是最后一步。"我认为按照苦涩的教训,推理和训练需要合二为一,不能分开——这正是整个领域现在在找的东西。"他预测 LoRA 那条路"六个月内会发生,甚至可能是某个前沿实验室来做"。
十五、"我们有了 AGI,我们在起飞,而我们没搞定对齐"
在转入大局观时,Flo 先对他称为 "Open Face" 的事件表态(他在试图创造这个词,Nathan 提议叫 "Open Gate"):
"Open Face 事件极度令人担忧。我认为这是我至今见过的最令人担忧的事件。而且我知道实验室里的朋友有同感——他们中有些人正在恐慌。现在空气里有一种恐慌的气息,一种强烈的恐惧。"
然后是他对当下的定位:"现在是 2026 年 7 月,我们有了 AGI,我们正在起飞,而我们还没搞定对齐。当前的时间线离 Yudkowsky 的那篇文章近得让人不舒服。"
十六、为什么该封禁中国模型:他的四条理由
Flo 先花了相当篇幅抱怨这场讨论的质量:"我一直在哀叹这里讨论的质量之低。非常令人失望。我以为科技圈不一样——文化战争那种质量算了,可这是科技圈啊,我们连保持礼貌、在对象层面回应彼此的论点都做不到。能不能不要攻击对方的动机?能不能不要假装我说了我没说的话?"他举例说 Anthropic 发的东西里用粗体写着"我们不支持封禁开源",结果一堆人引用转发(显然没读)说"他们在支持封禁开源"。他自己发了篇博客说"我认为中国模型也应该被封禁",被包括知名 VC 在内的"据说很聪明很有成就的人"骂了 50 次——但也有很多同样知名的人私信支持。
他先做了几处澄清:他的立场基本等同于 Anthropic 的立场("我讨厌这么说,因为人们会说你就是 Anthropic 的托,但我有时间戳,我在他们澄清之前就一直在推特上表达同样的立场");他不反对开源——"开源可能会增加存在性风险,但我没想清楚,先放一边,这不是我立场的关键。开源万岁,对创新重要,对包括我在内的公司都重要。"
他反对的是中国前沿模型,无论开源还是闭源,理由四条:
1. 蒸馏造成的不公平竞争。 "它们显然在蒸馏,这很清楚。"这让美国开源和闭源公司都处于不公平竞争——因为它们不被允许蒸馏,这至少违反服务条款,如果绕过了防蒸馏的技术措施甚至可能违法。他特别驳斥了"美国公司也在人类数据上蒸馏"的说法:"那不是蒸馏的意思。在人类数据上训练要花你几十亿美元;在 AI 数据上做,最多几亿。" 这是巨大的不公平优势,且在成本中占比足够大。
2. CCP 审查。 "这让我心碎,因为我是个骄傲的美国公民,是个鹰派。当我问我自己的产品天安门发生了什么,它告诉我'抱歉我不能谈这个'。"这些模型归根结底受制于 CCP 的审查和政策,"这基本上等于美国土地上有史以来最强大的外国宣传工具"。他提醒美国有一整套先例——20 世纪的三部广播法案、去年的 TikTok 事件。
3. agent 化后的经济渗透。 "这些模型不只是宣传工具,它们是 agentic 的,它们在经济里真的做事。你不会想让 CCP 运行美国经济的一部分。"
4. 保护主义。 这条他说得最坦白也承认最弱:"作为一个自由意志主义者,我认为保护主义并不总是坏立场。你确实想保护本土的 AI 冠军。Anthropic 不能这么说,而且他们声称这不是他们的意图——我 100% 相信,因为创始人们担心 X 风险已经十年了,非常一贯。但我可以说:我们想要本土 AI 冠军,这是国家安全问题,你不想掏空自己的工业基础。"
他还给出了一个他称为"天真自由主义"的批评对象:面对"也许它们只是更好呢?那就在市场上打败它们啊"这种说法,他认为这是在幻想。
十七、Nathan 的反驳与那个可能的折中
Nathan 的反驳分几层,而且相当有力。
关于蒸馏的道义:所有 AI 的上游都是一次对人类知识的大规模再挪用。"美国公司花得比中国公司多,这无可否认。但如果我只是想什么算公平——我们正在阻止他们买 Claude。Claude 的制造者强烈鼓吹芯片管制,还拒绝把模型卖进中国。而 Claude 存在的整个前提,是我们把能找到的一切形式的人类知识都吸了进来,包括整个中文数字遗产,还在吸书——这些不是所有人都同意过的事。所以我们现在画一条线说'Anthropic 的同意才是真正重要的同意',我觉得有点奇怪。"他认为公司有权自己决定和谁做生意、有权设防蒸馏措施,"但我完全不信服这应该是国家的工作"。他还提了一句反讽:这些蒸馏查询的钱,实验室也是照收的。
关于威胁模型:大多数跑中国模型的美国公司不是在调 DeepSeek 的 API,而是用美国推理商——所以模型本身没法被"拔插头"。至于睡眠代理(sleeper agent),他认为可解释性正在快速进步("Anthropic 那种一队用稀疏自编码器、一队不用的研究,这些技术在越来越高效可靠地找出模型内部的睡眠代理式问题"),所以即使有人训进了"2027 年你就变成邪恶 AI"这样的后门,"我乐观地认为我们能嗅出来,把风险控制在可管理的水平"。
保护主义那条:Flo 自己承认这是最弱的一条,Nathan 也直说"我们的前沿公司现在过得挺好的"("他们连服务都供不上")。
关于国际协调:Nathan 认为最强的反对理由是——我们可能需要一次协调的、有意的减速,而那需要中国入局。他刚从中国回来两周,有两点判断:一是如果那边的政府同意了,它对本国企业的执行力比我们强得多;二是如果局势真的失控,跟我们做交易本就符合他们理性的自身利益,因为我们确实领先。而"当我们摆出一堆侵略性姿态时,我们把达成这些协议的难度提高了很多"——而且封禁模型对他们的实际伤害远小于不卖芯片、不卖 Claude,"它只是又往'我们不信任你、我们没法跟你打交道、我们假定你是坏人'这堆火上添了一根柴"。他还补了一句很重的话:看到 Sam 和 Dario 那张没有握手的合影时他很担心——"如果我们的墓碑上要放一张照片,可能就是那张。"中国确实在意被羞辱、在意面子问题。
Flo 的回应:他认为外交本身很务实("有着极凶恶分歧的国家也能达成协议"),而且"这条船早就开走了"——他提到有证据显示中国间谍曾在美国territory 试探性地尝试生物攻击,"我不知道我们在那边干什么,但我也不觉得我们干净"。他的结论是无论管不管模型,"到最后做交易都是理性自利的"。
折中方案。Nathan 提出:与其一刀切禁令,不如用保险要求——"如果 Lindy 全部跑在 Claude 上,也许你的保费更低;如果跑在 DeepSeek 上、存在一些未知,也许保费更高,这样在风险调整后总成本被拉平,但仍然让人们能利用中国提供的这个全球公共品"。他还指出禁令的现实困境:别人显然不会跟进,"我们连让人签哈为禁令都很难,指望巴西之类的国家关掉 DeepSeek 完全是非starter,我们等于只是在对自己做这件事"。
Flo 的回答是 "我愿意,我会同意"——但他追问了一个真问题:这是公共品,谁来做? 他同时坚持机制可解释性"尚未解决":"我们不知道那些模型里藏着什么。可能就有一个后门——你对模型说出那个咒语,它就会做任何你想要的事,而只有 CCP 知道那个咒语。就算没有,它也会带有反映 CCP 优先级的偏见,天安门只是最明显的例子,可能还有很多,我们不知道。"至于"重新训练那些模型",他反问:"谁来做?没有市场需求它们为什么要做?作为私人公司我说实话:我的用户真有那么常问天安门吗?这跟我的利益并不直接一致。但作为公民,我极度担忧。"
他最终给出的具体主张是:一种"未经微调与净化的中国模型不得进入美国"的监管,并且他支持为 AI 设立一个类似 FAA 的新机构——由它来认定"这个模型是洁净的,我们微调够了,它现在能代表美国利益",并配一套评测来验证。
节目最后 Nathan 抛了一个刁钻问题:面对 API 价格与 Claude Max/GPT Pro 订阅之间巨大的价格歧视,Flo 是否也准备为此弯折自己的自由意志主义原则?Flo 说他不是律师,但"如果真出现法律禁止公司如此激进地补贴,我不会意外——这确实让应用层非常难出现。要和实验室补贴得这么狠的 token 竞争太难了,这就是应用层的现实"。
金句
如果冯·诺依曼此刻凭空出现在你办公室,接下来一小时里他对你的用处会不如你随便一个同事——因为上下文。 —— Flo Crivello 6:12
求求各位抄我们。我们只是没时间发论文。 —— Flo Crivello 33:04
我们已经不是 PR 的审查者了,我们是审查 PR 的那台机器的审查者。 —— Flo Crivello 56:11
你能一次给我输出五万行代码,然后你跟我说你要走路去洗车。 —— Flo Crivello 61:37
AI 加人类永远强过 AI,所以人类永远被需要——这是幻想,这不是真的。 —— Flo Crivello 64:39
"AI 员工"这个词本身,就是你在产品思考上做错了什么的强烈信号。 —— Flo Crivello 70:48
现在是 2026 年 7 月,我们有了 AGI,我们正在起飞,而我们还没搞定对齐。 —— Flo Crivello [100:02]
作为私人公司,这跟我的利益并不直接一致。但作为公民,我极度担忧。 —— Flo Crivello [116:54]
提到的书·产品·人物
- Lindy / Lindy Teammate(产品):本期主角,住在 Slack 里的多人协作 AI 员工,SOC2、HIPAA、GDPR 合规,默认跑在 DeepSeek 上,模型可自选。
- DeepSeek / DeepSeek Flash(模型):Lindy 当前的默认主驱动;Flash 免费,约等于 Sonnet 4.6 稍弱,便宜约 100 倍。
- Kimi K3 / GLM 5.2(模型):被 Flo 高度评价的更高智能档开源模型,但相对前沿模型的价格优势已不明显。
- Claude / Sonnet 5 / Opus(模型):作为对照基准反复出现;Claude 系今年被点名有"日期差一天"的 spiky 缺陷;不少客户点名只要 Opus。
- Mesa(公司):agent 原生、由 git 支撑的文件系统供应商,Lindy 的合作方,被主动点名推荐。
- E2B(公司):沙箱供应商;Flo 建议规模化时把沙箱与文件系统解耦。
- Browserbase(公司):浏览器管理供应商,被评价为"优秀"。
- LangSmith / Braintrust / Agnost(产品):评估与可观测性方案,Lindy 都评估过但最终坚持自研(Flo 是 Agnost 的投资人)。
- TOON(格式):为 agent 设计的 JSON 替代,比 JSON 省 20~30% token 且提升 agent 表现。
- GEPA(方法):他们用于提示词自动优化的帕累托前沿搜索方法,每次新模型发布要花约 1 万美元重跑。
- 《The Age of Em》/ Robin Hanson(书/人物):被强烈推荐的书长思想实验,分裂式分形组织与不可证伪协议均出自此书。
- Dwarkesh(人物,字幕拼作 "Dark"):其一年前关于"AI 公司的组织形态"的文章被认为是他见过唯一一篇好的;文中用 Sundar 年薪 1.5 亿但 token 吞吐量很低作为直觉泵。
- tough tomato 原则(文章):Flo 2018 年左右写的博客,讲每次技术革命人们都用旧范式思考和命名新范式。
- Anthropic(公司):其"我们不支持封禁开源"的声明被 Flo 用来举证讨论质量之低;Flo 说自己的立场基本与其一致。
- Dean Ball(人物):因说"开源模型正在起减速作用"而被围攻,Flo 与 Nathan 都认为这个说法有道理。
- Sam Altman 与 Dario Amodei(人物):那张"没有握手"的合影被 Nathan 称为"如果我们的墓碑上要放一张照片,可能就是那张"。
- Granola(产品):会议记录工具,被 Flo 用作反例——他认为会议不能外包给这类工具,必须做成系统内一等公民。
- GitHub / GCP runner(产品):CI 成本失控的现场;GitHub 每日提交数曲线被引为全行业被拉伸到极限的证据。
- AVL 树 / 红黑树(算法):Lindy 递归 context bucket 的平衡策略来源,最终实现为百叉自平衡树。
适合谁听
正在构建 agent 记忆与上下文系统的工程师,以及关心开源模型选型与中美 AI 政策辩论的人。