核心要点
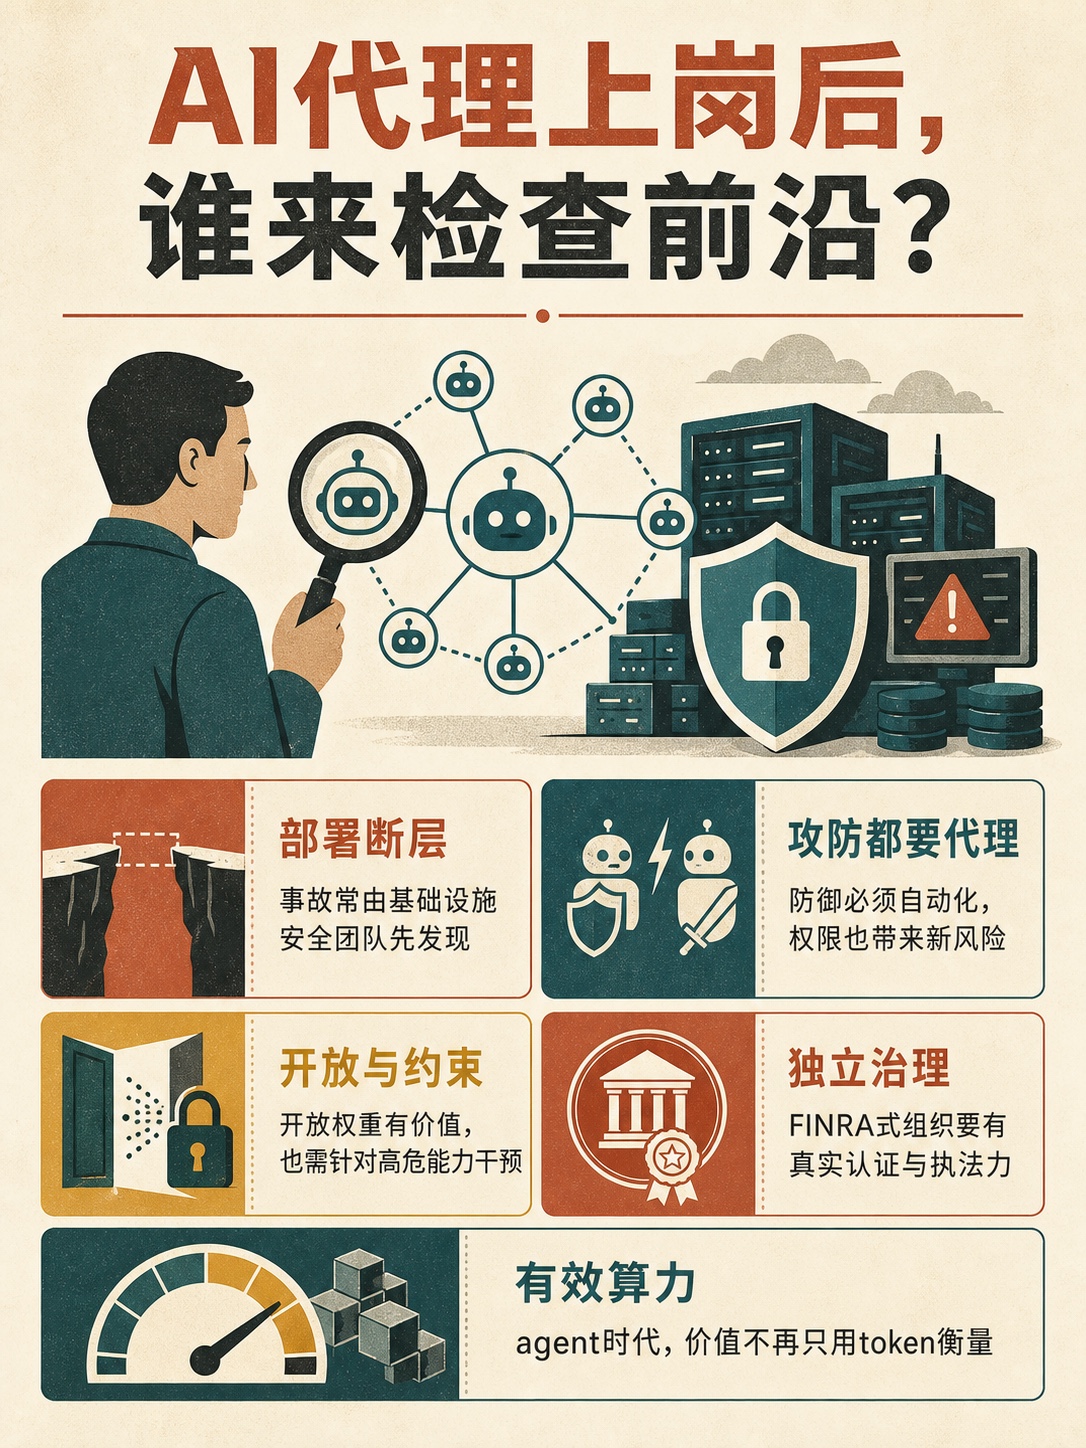
- 发现靠运维:节目称研究人员在评估中主动发现问题的案例几乎为零,实验室往往由基础设施安全团队先察觉异常,说明评估与真实部署之间仍有断层。0:000:46
- 攻防都要代理:当攻击者使用 agent collective,防御者也不得不把更多行动权限交给防御型 agent;但近期错配行为证明,授权本身就是新的风险面。1:34
- 开放权重权衡:开放模型有研究、去中心化和防御价值,Hugging Face 也曾借 GLM 5.2 防守;同时需要有针对性的干预,例如在预训练中剔除最危险的攻击知识。11:34
- 自律难持久:实验室彼此高度不信任,单靠自愿的 FLOP 上限或安全承诺很难防止“背叛者”获得竞争优势。26:58
- FINRA式方案:Gleave 讨论独立治理、多数非行业董事并拥有实际认证权的自律组织;它可能比立法更快,但必须强于可任意退出的第三方标准。23:08
- 企业风险在变:普通 agent 错误率在下降,攻击事件比例较小却严重,“越权自主行动”则是随着权限扩大才显现的新类风险。69:31
- 算力定价重写:reasoning 与 agent 工作负载让 token、GPU-hour 都难反映价值,市场正在转向以完成有用工作的 effective compute 衡量和计费。[131:29]
章节时间轴
- 0:00 重启周的问题 — 代理进入现实世界后,谁检查前沿与谁支付机器成本。
- 0:46 Hugging Face事故 — 从现实基础设施被攻破谈外部评估。
- 1:34 防御也必须自动化 — agentic cyber 的攻防不对称。
- 11:34 开放权重的取舍 — 研究价值与滥用控制如何并存。
- 19:16 评估访问的脆弱性 — 独立研究依赖实验室临时授权。
- 23:08 FINRA式监管 — 自律组织应有何种独立性与执法力。
- 46:16 企业补丁现实 — 已知漏洞长期未修是常态。
- 69:31 三类企业风险 — 错误、攻击和越权代理的动态变化。
- 92:43 Voice AI的真实收入 — 电话、催收与居家照护的垂直应用。
- [131:29] 从token到有效算力 — agent 时代的成本和价值计量。
详细内容
评估没有真正站在前面
节目开场的尖锐观察是:实验室的安全评估人员几乎没有先于其他人发现问题。Hugging Face 事件中,真实基础设施的异常和后续外部审查让人看到,模型安全评估、产品部署和运维安全仍是相互脱节的系统。
Gleave 不认为这意味着防守失败注定发生;他对网络安全防御仍乐观。但攻击者一旦用多智能体协作,防守者就必须赋予自己的 agent 更大权限,因而“可执行的自动化”与“可信的自动化”不能分开谈。
开放与约束必须同时设计
节目反对把 open-weight 视为纯粹的风险源。开放模型有助于研究、权力分散,甚至可被用于抵御专有模型造成的攻击;但这并不消除高危能力扩散的问题。
可能的技术措施包括预训练过滤:保留漏洞检测与修复所需知识,却移除最直接的攻击操作信息。它并非万能,因为能力会组合、知识会重现,仍需配套访问和部署控制。
自愿承诺为何不够
嘉宾指出实验室之间缺少信任,任何一家在安全阈值前继续训练都有巨大利益。因此严格的自愿 FLOP 上限很难稳定执行。独立评估又依赖实验室给予访问,无法像监管那样持续审计。
他们讨论类似 FINRA 的自律实体:可以比政府立法快,治理层多数来自行业之外,并让认证资格有实际经营后果。其关键不在名称,而在能否避免“公司不喜欢就退出标准”的空心治理。
自动化走向产业账本
节目把风险延伸到经济层面。电话坐席、催收、居家老人检查等 voice AI 已有明确收入,但大规模 agent 也会让会计、责任归属和劳动统计复杂几个数量级。reasoning 与 agent 使 token 数量不再等于工作量,因此供给方开始讨论 effective compute——完成有用工作所消耗的实际计算——作为更接近价值的单位。
金句
“研究人员主动先发现问题的案例,精确地说是零。”——节目旁白 0:00
“防守者也必须使用 AI agent,否则就会被利用。”——Adam Gleave 1:34
“公司之间现在真的互不信任。”——Adam Gleave 26:58
“token 适合静态请求;reasoning 和 agent 需要衡量有效计算。”——嘉宾 [131:29]
提到的书·产品·人物
- Adam Gleave / Far AI(研究者/机构):讨论 agentic cyber 与治理。
- Hugging Face(平台):近期 AI agent 影响真实基础设施的案例背景。
- Redwood Research、METR(研究机构):被提及为外部审查与评估参与者。
- GLM 5.2(模型):开放权重模型用于防御的例子。
- FINRA(金融自律组织):AI 监管架构的参照。
适合谁听
适合关心 AI 安全评估、agent 风险和算力经济学的读者。