核心要点
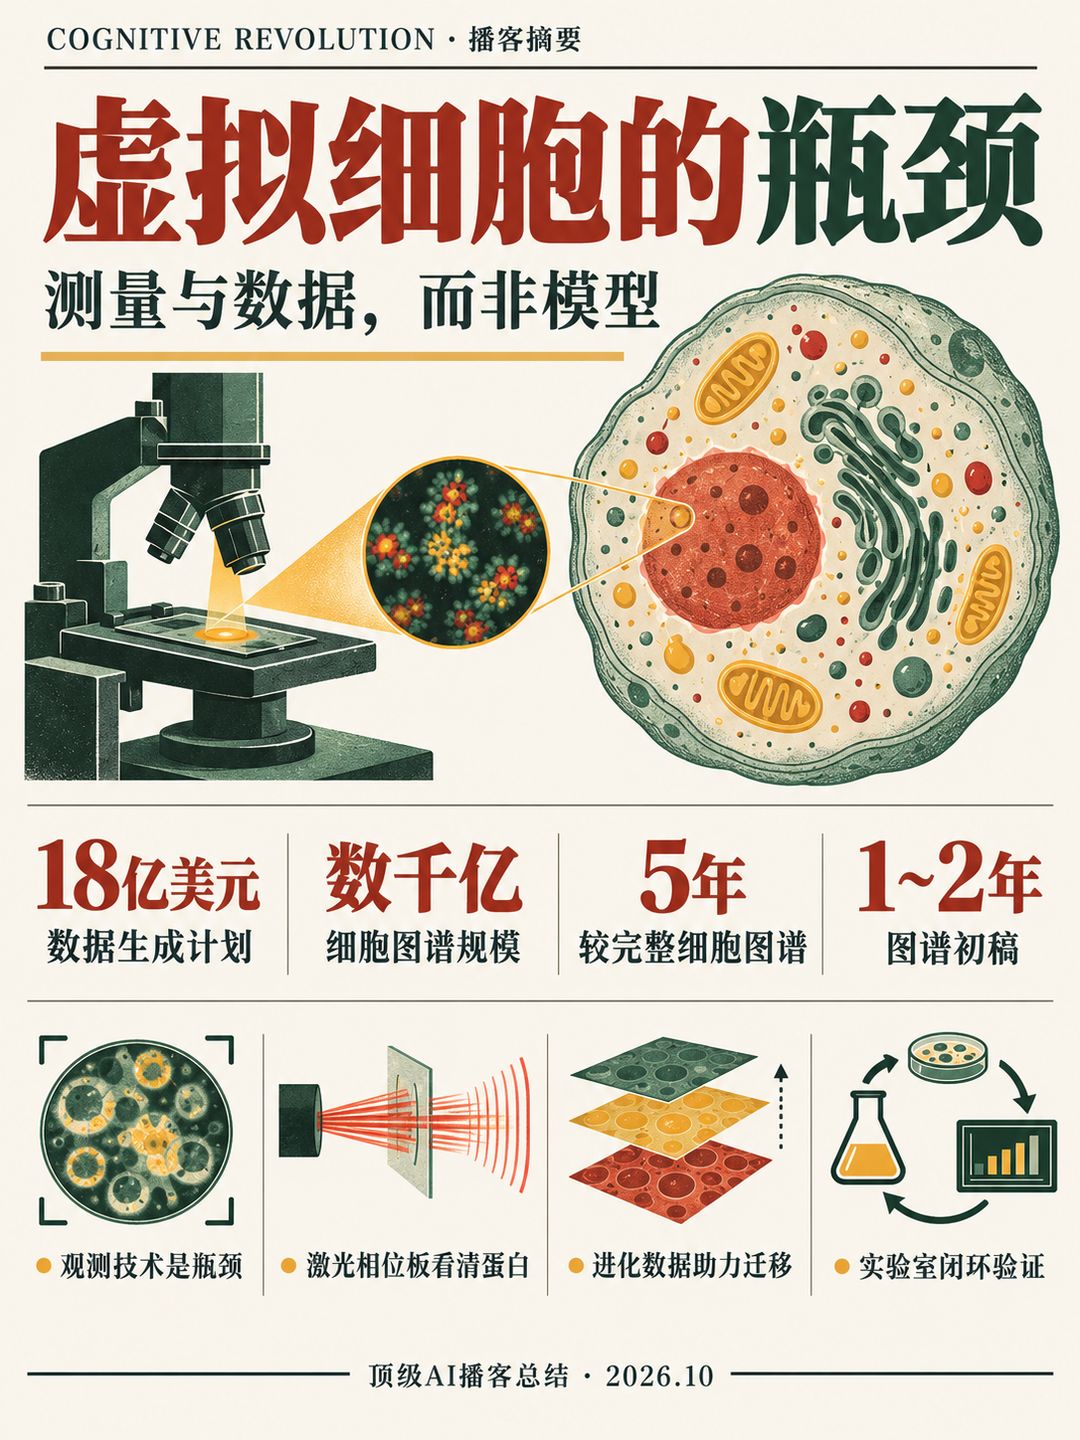
- 观测瓶颈:Rives 认为今天所谓的「虚拟细胞」远不能充当实验生物学的 oracle,根本原因是测量技术有限,现有数据无法呈现细胞精细的因果结构,模型、数据规模与观测工具三者必须同步突破。
- 18亿美元:Biohub 联合美国能源部、NIH、Google DeepMind、Isomorphic 与 Meta,把 Virtual Biology Initiative 扩大为数据生成计划,目标是绘制覆盖数千亿细胞、链接分子与成像的空间细胞图谱。
- 世界模型:Rives 判断五年内可实现的是信息论意义上的细胞模型,先学习「当前状态加输入,预测下一状态分布」的概率性转移函数,远期才是真正的「生命的世界模型」。
- 激光相位板:由 Berkeley 的 Holger Müller 构想、Biohub 多年投入,用最强驻波激光为电子显微镜提供相位衬度,使冷冻电子断层扫描能看清细胞内单个蛋白及大分子的相互作用。
- 进化迁移:ESM 与 AlphaFold 并非只用人类蛋白训练,而是学习整个进化史;Rives 称只训练人类蛋白得不到准确模型,因为脊椎动物共享转录因子等部件,只是程序被重新接线。
- 实验室 RLVR:生物学可以做 RLVR,但验证必须在实验室完成,需构建让 AI 提问、做实验、学习并提出更好实验的闭环;生物是经验科学,验证远慢于数学与代码。
- 五年时间表:Rives 预计一两年内出现健康与疾病细胞图谱初稿,五年内有较完整版本,随后可回答「如何把病理状态逆转回健康状态」;他不看好仅靠电子病历,担心只学到相关性。
章节时间轴
- 0:45 治愈所有疾病意味着什么 — Rives 自称务实,目标是没有癌症、传染病与慢性退行性疾病的世界,而非永生,并希望从「吃药」走向可编程药物。
- 6:08 药物开发框架与信息论视角 — 经典范式是找分子层面的病因再设计干预;Rives 补充把生命视为程序,疾病是程序的一部分。
- 9:15 虚拟细胞为什么还不行 — 细胞极其复杂,Transformer 缺乏多尺度结构,更根本的是观测与测量不足。
- 13:53 未来模型长什么样 — 无限数据下架构不重要,但细胞生物学离此很远,归纳偏置仍关键,目标是「生命的世界模型」。
- 16:57 细胞作为信息处理机器 — 五年内可达信息论层面的细胞模型,先学习概率性的状态转移函数。
- 23:09 18 亿美元虚拟生物学计划 — 与 DOE、NIH、DeepMind、Isomorphic、Meta 合作,扩展空间生物学与成像图谱到数千亿细胞。
- 26:13 激光相位板与测量哲学 — 为电镜加相位衬度,冷冻电子断层扫描看清蛋白;测量技术推动科学范式转变。
- 30:00 跨尺度与斑马鱼成像 — 细胞要放在组织语境中建模,Biohub 用斑马鱼追踪胚胎每个细胞与免疫细胞。
- 37:45 模型生物与进化迁移 — 小鼠并非完美代理,ESM 经验表明跨进化训练对理解人类至关重要。
- 42:24 生物学的预训练与 RLVR — 预训练加激发两阶段同样适用,但验证需在实验室闭环完成。
- 46:15 时间尺度、图谱与病历数据 — 一两年出初稿、五年较完整,Rives 更关注因果基础而非健康记录。
- 52:25 语言与生物潜空间是否融合 — 尚无定论,重要的生物学知识不在文本里,蛋白模型已学到无名概念。
- 56:59 百万 Bryan Johnson 与个人健康 — 持续监测数据有价值但非 Biohub 重心,Rives 自己只戴睡眠手表。
详细内容
愿景:从吃药到读写生命程序
Rives 对「治愈所有疾病」的解释很克制:他不谈永生,而是设想一个没有癌症、传染病、慢性与退行性疾病的世界。他强调自己是「practical person」,关注现实时间框架内可能实现的目标。
在方法论上,他承认经典药物开发框架依然成立:先在分子层面找病因,再寻找并设计干预,AI 正在为其中每个环节带来新潜力。但他更看重信息论视角,即把生命视为一套由基因组编码的程序,思考如何读取、进而改写这些程序。
在这个框架里,疾病是程序的一部分,往往以相当规则的方式展开。因此 Biohub 想做的是可编程生物学的工具和模型,既深入分子层面,也放大到细胞在组织中的语境。Rives 同时提到,希望突破目前以药丸和分子为主的治疗范式,走向更可编程的药物。
虚拟细胞为何不够好
Nathan 提出的假设是:现有数据质量不够,缺少模型需要学习的信号。Rives 大体同意,但先拆出三个要素:模型范式、规模化数据生成、观测与测量工具。他指出 Transformer 并没有多尺度结构,难以表示从原子到细胞再到组织的不同层级。
然而他认为更根本的是可观测性:细胞的很多部分我们根本测不到,有些地方大规模生成数据极其困难。科学史上许多进展都来自新的测量技术,因此三者必须同时进步。基于这一点,他明确表示,目前被称为虚拟细胞的模型,还不符合那种能有意义地模拟细胞、充当实验生物学 oracle 的定义。
Nathan 追问是否有足够好的数据后今天的技术就够用。Rives 回答,在无限数据与算力的极限下,所有模型都只是函数逼近器,架构会无关紧要;但蛋白质因为有大规模基因测序,才更接近这个极限,细胞生物学远没有。距离极限越远,归纳偏置越重要。
信息论的细胞模型与世界模型
Rives 设想的终极模型可以把细胞状态投射到原子分辨率结构,也能在程序层面建模,并让发育与组织内相互作用自然展开,这就是「生命的世界模型」。他承认离此尚远。
近期可行的是信息论层面的细胞模型。他的逻辑是:基因组编码了运行生命的程序,细胞是信息处理机器,而当下的自监督预训练能从输入输出的统计模式中捕获驱动关系的潜变量。若生成足够多的转录组、表观遗传、蛋白与成像数据,就可能揭示遗传信息与细胞响应程序之间的联系。
他认同 Nathan 的看法:第一件事是学习转移函数,把当前状态与输入映射到下一状态。这个函数是概率性的而非确定性的,细胞会转移到一个下游状态分布,因此问题很复杂,但他认为现在已有技术使之成为可能,并预计五年左右可达。
18 亿美元计划与测量技术
今年 4 月,Biohub 宣布 Virtual Biology Initiative,旨在建立数据集支撑虚拟生物学,起步目标是通用的细胞生物学模型。录制前两天,他们又宣布旗舰合作:美国能源部、NIH、Google DeepMind、Isomorphic 与 Meta 共同协调数据生成,并向全球科学界与其他资助者发出邀请。
具体上将大幅扩展情境图谱,例如空间生物学:在组织与邻近细胞背景下观察细胞,把分子测量与成像相连,规模达数千亿甚至更多细胞,目标是尽快产出能训练情境化信息论细胞模型的第一批数据集。
激光相位板是测量哲学的代表。它由 Holger Müller 数十年前设想,Biohub 数年前开始投入,本质是电子显微镜的相位衬度:最强的驻波激光与电子束干涉以偏移其相位。主要应用是冷冻电子断层扫描,在噪声极大的观测中分辨单个分子并理解其相互作用,从而打开活细胞动态结构生物学。Rives 的思路是增加每个细胞可测参数、扩大视野与细胞数、打开时间维度和分子维度。
跨尺度、模型生物与进化迁移
对于「一个细胞够不够」的问题,Rives 承认这是多尺度难题,单个点突变就能致病,且今天不可能把整个系统测到分子级别,因此要用信息原则桥接。他强调,所谓细胞模型不是孤立培养的细胞,完整模型必须包含其在活体系统中的语境。培养细胞虽是粗糙的代理,仍保留核心机器,但组织层面能学到更多。
Biohub 的成像研究所在不同复杂度层面都有布局:激光相位板提供原子分辨率但只看细胞一部分;还有观察细胞场、施加扰动并统计测量的技术;以及全生物体成像。斑马鱼是透明的,可追踪胚胎从一个细胞发育成完整个体的每个细胞,也能标记全部免疫细胞,跟踪其迁移与相互作用。
面对「小鼠有效、人类无效」的质疑,Rives 说模型生物仍奠定了分子生物学的基础,甚至酵母实验都揭示了人类相关机制,但它们也会造成两类错误:只在小鼠有效的疗法,以及因小鼠缺少代理而错过的人类机制。类器官是最新进展。更关键的是 AI 的作用:ESM 与 AlphaFold 并非只用人类蛋白训练,而是学习整个进化,只用人类蛋白根本得不到准确模型。脊椎动物共享转录因子与增强子、启动子的语言,只是程序被重新接线,所以应该构建能整合所有信息的预测模型,而不是追求完美的实验代理。
预训练、RLVR 与实验闭环
Nathan 问语言模型的预训练加后训练配方在生物学里会怎样。Rives 认为原理是共通的:自监督的表征学习是关键,这是 Hinton、LeCun、Bengio 等先驱的梦想,即无需预先编码全部变量,神经网络能自己学到,而 scaling laws 是最清晰的表达。蛋白质已经验证了这一点,细胞生物学也会如此,先从统计模式学习底层系统模型,再通过激发阶段提取与问题相关的部分。
他相信生物学也可能有 RLVR 与反馈,终点是「经验性 AI」:AI 提出问题、做实验、从实验中学习、改进理解、提出更好的实验,并反复循环以实现递归改进。但这需要不同的构建方式,模型必须能准确表示生物的多尺度复杂性,更大的挑战是生物学是经验科学。数学、编码和推理能快速做计算验证,生物学必须建立实验室内的验证系统。
在时间尺度问题上,Nathan 关心如何活到 120 岁。Rives 说这仍是攀登的很大一部分,但属于可用现有技术解决的规模化挑战:构建健康与疾病情境下的细胞图谱,了解疾病与健康的细胞层差异,并找出不同疾病的独特点与共同病因。他预计一两年内有初稿,五年内在协调努力下获得较全面的图谱,随后回答如何逆转病理状态。
健康记录、语言融合与个人实践
对电子健康记录,Rives 坦言没有深入思考。他担心如果没有正确的基础,学到的只是相关性:会有大量患者病史模型,却无法与底层因果生物学相连。他承认病历能带来可观进展,例如把已有药物匹配给合适的人,但认为那不触及产生阶跃式变化所需的基础,Biohub 专注于基础科学与技术层。
关于语言与生物模型是否融合到联合潜空间,Rives 说自己不确定。语言是推理的基底,也承载了人类数百年经验研究形成的生物学模型;但我们最想知道的生物学事实不在文本中,也无法从第一性原理推导,只能通过实验获得,因此预测性生物模型至关重要。融合初期会因缺少桥接数据而困难,但最终大概可行。
他还指出蛋白质语言模型会学到代表未知蛋白生物学的特征,这些是我们尚无词汇命名的新概念,地球上已测序数十亿个蛋白,多数功能未知。最后关于百万 Bryan Johnson 式的持续监测,他认为这类数据非常有价值且长期会发生,更多是技术层面的连续监测与更多分子参数的问题。至于个人健康,他说自己专注研究,几乎不想,只有一块追踪睡眠的手表。
金句
我认为现在被称为虚拟细胞的模型,还不符合那种能有意义地模拟细胞、并真正充当实验生物学 oracle 的定义。 —— Alex Rives 13:08
在无限数据与算力的极限下,所有模型架构大概都会变成一样,它们只是函数逼近器。 —— Alex Rives 14:38
我们现在处在大规模信息论的时代。 —— Alex Rives 17:44
如果你只用人类蛋白训练模型,是得不到准确预测模型的。 —— Alex Rives 40:51
程序被彻底重新接线,但它们是用同样的积木搭起来的。 —— Alex Rives 41:38
我们最想了解的生物学事实不在文本里,只能通过做实验才能得到。 —— Alex Rives 53:56
提到的书·产品·人物
- Biohub(机构):Chan Zuckerberg 支持的研究机构,使命是治愈或预防所有疾病,Rives 担任科学负责人。
- Virtual Biology Initiative(项目):今年 4 月发布,本周宣布 18 亿美元扩展计划,为虚拟细胞生成数据。
- Department of Energy / NIH / Google DeepMind / Isomorphic / Meta(机构):旗舰数据生成合作的伙伴。
- Evolutionary Scale / ESM(公司/模型):Rives 此前联合创办的公司及其蛋白质模型系列。
- AlphaFold(模型):被举例说明跨进化训练与物理归纳偏置的价值。
- laser phase plate(激光相位板)(技术):为电子显微镜提供相位衬度,用于冷冻电子断层扫描。
- Holger Müller(人物):Berkeley 研究者,数十年前构想了激光相位板。
- Hinton、Yann LeCun、Bengio(人物):被提及为自监督表征学习的深度学习先驱。
- zebrafish(斑马鱼)(模型生物):透明,可追踪每个细胞与免疫细胞。
- Bryan Johnson(人物):Nathan 用「百万个 Bryan Johnson」设想大规模持续监测数据。
- Parallel、OutSystems、Taskade/Tasklet(产品):本期赞助商广告。
适合谁听
关注 AI for Biology、虚拟细胞和生物基础模型,想弄清瓶颈究竟在数据还是模型的听众。