核心要点
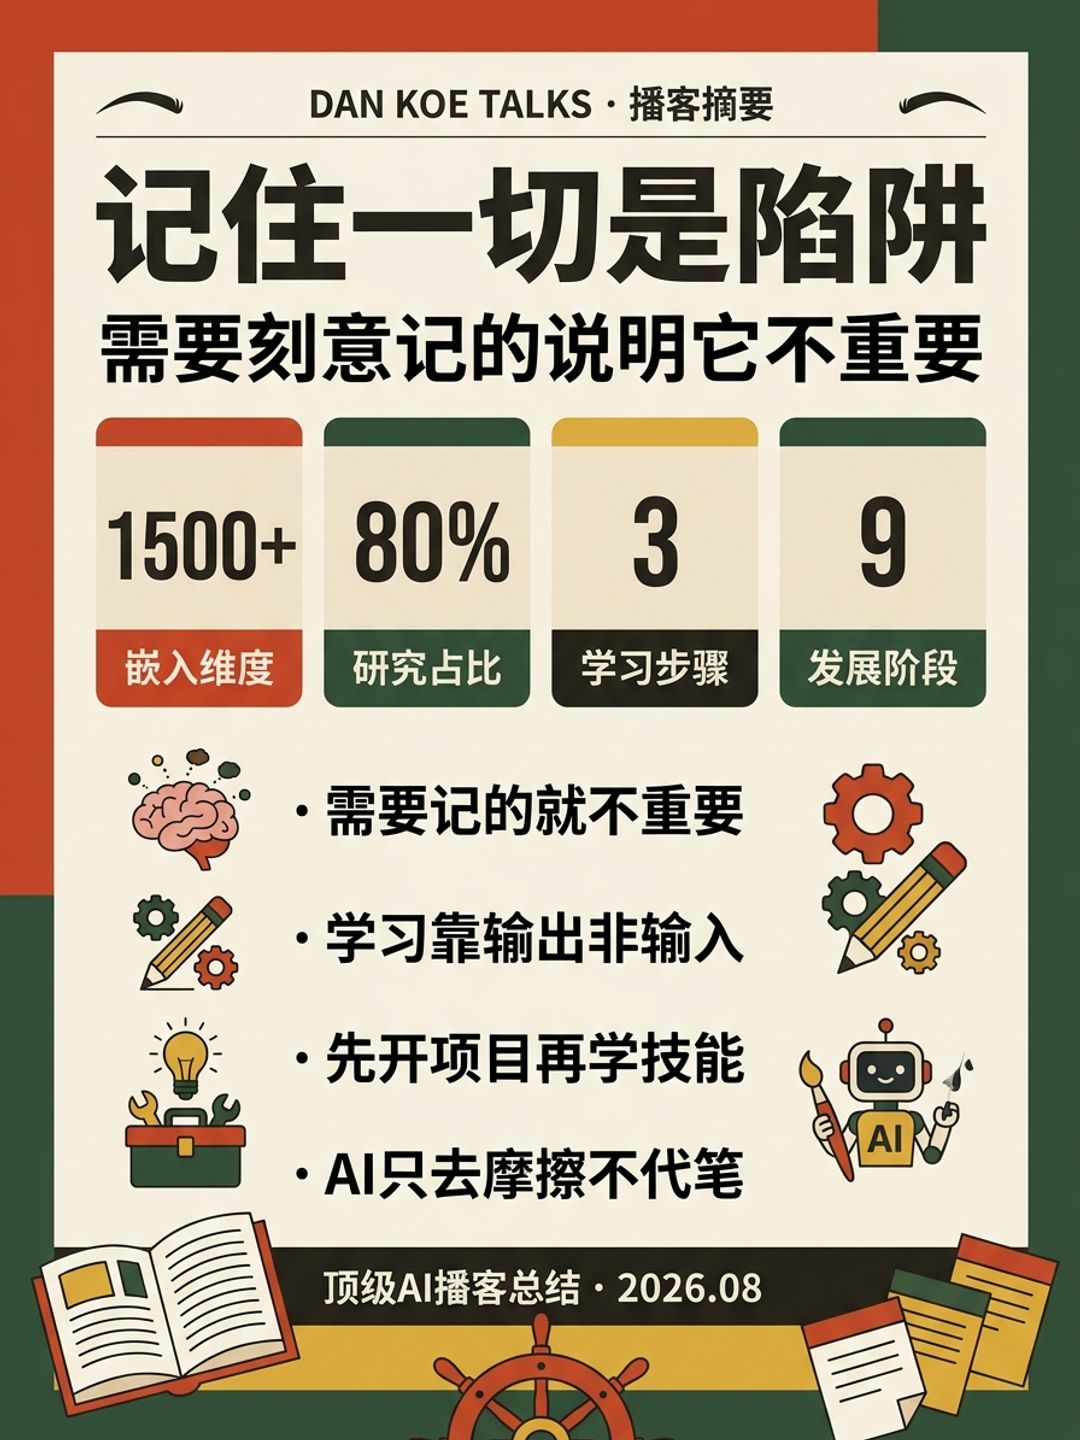
- 反记忆前提:节目第一句就是全篇的公理——「如果你需要刻意去记它,它就不重要;如果它重要,你自然会记住。」执着于背诵的深层动机是把博学当成一种无意识的身份符号,想在别人面前显得聪明。
- 学习是输出:多数人把学习当输入过程,靠间隔重复、抽认卡、囤课程来吸收材料;但真正的学习是输出过程,因为「输出会倒逼输入」,只有先做才会暴露知识缺口。
- 控制论闭环:cybernetics 源自希腊词 kubernetes,意为掌舵人。智能系统需要四件事——参考信号(目标)、传感器(感知现状)、比较器(算出差距即误差信号)、执行器(行动缩小误差),恒温器和胰腺分泌胰岛素都是这个结构。
- 目标即过滤器:目标产生误差信号,误差信号产生过滤器,过滤器产生相关性,相关性才产生记忆。被「上学-工作-65 岁退休」条件反射规训的人,大脑会主动屏蔽创业、做创作者、用好 AI 这类机会,因为它们不服务于既定目标。
- 先做项目再学:想学 After Effects 不该先看通用教程,而应先有一个想做的动画,再去找最接近那个成品的教程——教程里大部分内容会被你自动过滤掉,你只提取当下能用的技术,一次次叠加。学吉他同理:先选一首想弹的歌,再学第一个和弦。
- 第二大脑≠第二潜意识:Dan Koe 不否定第二大脑,只说它被误用了。Marcus Aurelius 的《沉思录》本质是私人 commonplace book,达·芬奇写满数千页笔记,Mark Twain、洛夫克拉夫特、杰斐逊、里根、Rick Rubin 都有各自版本——区别在于他们的素材是创作的燃料,而不是永不回看的收藏夹。
- AI 只用来去摩擦:他承认在自己那篇 Twitter 上阅读量最高的文章里,Susan Cook-Greuter 的自我发展九阶段那段是 AI 写的——因为那不是他的观点,他只想尽量忠实原意;但凡是自己的观点和信念,必须自己吃力地表达,因为那种「表达不出来的卡顿」本身就是学习缺口。
章节时间轴
- 0:00 开场:记不住不是失败 — 直接否定「记住你读的一切」这个流行命题,指出背诵的动机是想显得聪明,而聪明来自理解。
- 1:32 预告与 Eden 广告 — 预告后半段要拆「笔记系统、书签、第二大脑基本无用」,同时介绍自家产品 Eden 新增的阅读器与高亮库功能。
- 2:17 学习来自挣扎 — 引用自己的一条推文:直接开项目,别先看 20 个教程,让项目暴露你的知识缺口,在大脑最想记住答案的时刻去搜答案。
- 3:04 负反馈回路缺失 — 用健身目标与宿醉的例子说明:没有真正内生的目标,坏行为就不会被注册成负反馈,学习也就无从发生。
- 4:37 控制论与掌舵人 — 解释 cybernetics 的词源与四要素(参考信号、传感器、比较器、执行器),并用恒温器、胰岛素举例。
- 6:10 学习是输出,不是输入 — 提出「信息即心智的食物」,只吃不练会造成「知识肥胖」;刷自我提升内容和刷脑残内容本质一样,只是多了一层虚假进步感。
- 7:43 默认路径的过滤器 — 被社会设定目标的人会无意识修正误差以维持既定方向,从而看不见任何超出「65 岁退休」这个上限的机会。
- 10:01 构建自己的框架 — 关键动作是明确知道自己不想要什么,再与一个持续演化的理想图景对照,才能感知偏航。
- 10:47 步骤一:为一个有意义的目标着魔 — 直视「不改变的话人生会走向哪里」的画面,让那股情绪能量转向;他形容那种感觉像被某种神圣能量灌满。
- 13:05 步骤二:不要开始学,要开始项目 — 项目是一组结构化的目标与里程碑,并且最好公开发布以获取市场反馈;心智、身体、关系、财务都可以当项目来做。
- 13:52 步骤三:追求 specific knowledge — 引用 Naval 关于「找到你独一无二做得最好的事」的原话,并痛批新手因为怕第一条帖子扑街而迟迟不开始。
- 15:26 自我教育 vs 学校教育 — 学校教通用知识和岗位知识,不教如何导航自己的路;以 After Effects 和吉他为例给出「按需拆解教程」的具体方法。
- 20:47 第二大脑的问题 — 复盘自己从 Roam Research 到 Cortex 再到 Eden 的历程,指出第二大脑不是无用而是被误用,Notion 里整理人生并不会帮到你。
- 22:21 commonplace book 与第二潜意识 — 从《沉思录》到达·芬奇,历史上的创作者用笔记做创作燃料;引用 Seneca「采百花之粉,酿成自己的蜜」。
- 24:38 搭建数字 commonplace book:选工具 — 引用 Devon Ericson 关于 AI「比一袋湿锤子还笨,但擅长大数据集上的快速输入输出」的判断,并抨击 AI 阵营化的二元思维。
- 26:55 路线一:Claude + Obsidian — 给出完整步骤:在 Obsidian 库文件夹里开 Claude Code,建「保存想法」和「处理收件箱」两个 skill,再让 AI 帮你定义 taxonomy。
- 30:47 路线二:my mind / Eden 与嵌入 — 自动打标签、归类并嵌入「意义空间」,每条内容带 1500+ 个数字作为想法的 GPS 坐标,不靠关键词也能找到相关想法。
- 33:05 步骤二:捕捉能代表理想心智的想法 — AI 能生成一切时,策展比以往更重要;人们关注你不是为了内容,而是为了你的视角和世界观。
- 35:24 多读书,研究占创作者工作的 80% — 拒绝无脑刷,改为策展一批优质作者与思想者的清单,同时明确表态自己不站 AI 的任何一边。
- 36:10 步骤三:在创作中构建理想心智 — 有了捕捉与检索系统,还必须有项目来消化这些知识,否则闭环不成立。
- 37:42 写作流程一:选题=表现×兴奋 — 选题要落在「已被验证能跑」的题目和「你自己好奇想探索」的题目的交叉点上;本期标题正是这么来的。
- 39:14 写作流程二:brain dump→大纲→初稿 — 先倾倒所有可能的点子和素材,再按「问题-洞察-解决方案」的叙事框架排布,最后才写句子。
- 40:45 写作流程三:用 AI 去摩擦而非代笔 — 以自己引用 Susan Cook-Greuter 九阶段为例,划清「非我观点可以让 AI 写」与「我的观点必须自己写」的界线。
详细内容
一、为什么「记住一切」本身就是错的命题
Dan Koe 开场就把靶子立起来:YouTube 上「如何记住你读的每一本书」这类视频动辄上百万播放,是极其病毒化的选题,他甚至和屏幕上闪过的几位作者是朋友。但这些内容制造了一个有害的暗示——如果你没能留存书里的知识,你就是失败者,你的时间白花了。他反问:为什么你会想把一本书逐字背下来?
他自己给出答案:因为你想显得聪明。这是一种无意识的身份符号,你希望用表达能力和智力去打动别人。但他指出这里的因果搞反了——听起来聪明来自理解,而不是来自记忆,而理解需要一条完全不同的学习路径 0:00。
他把责任的一部分推给学校:学校考的是记忆能力,你熬几小时的夜,只为在选择题上填对答案,但人生根本不这么运作 0:47。他也承认所有人想要知识的动机是合理的——想做更好的决策,把自己推进一个更有利的处境,有更多钱和权力,不用为日常生存发愁。问题是记忆事实是通往那个结果最低效的方式。
节目的第一句话在 42:19 处被他自己再次引用,构成全篇的回环:如果你需要刻意去记它,它就不重要;如果它重要,你会记住。
二、控制论:学习为什么必须是输出
他用一条自己发过的推文概括方法论:学习来自挣扎,不来自记忆。开始项目,别先看 20 个教程,让项目暴露你的知识缺口,试着自己搞定,在你的大脑最可能记住答案的那一刻去搜索答案,然后发布项目,然后重复一辈子 2:17。
为什么大多数学习会失败?因为没有负反馈回路。他举了一个具体例子:如果你没有健身的目标——而且他强调必须是深层的、内生的目标,不是为了合群而定的新年愿望——那么一晚上的酗酒和派对根本不会在你的系统里注册成「问题」,因为它不影响任何东西;宿醉照样能去上班,因为你也不在乎自己上班干得好不好 3:04。反过来,如果你的目标是卧推破 PR 或者跑完一场马拉松,那么同样一晚的放纵就会立刻显形为误差。真正在意那个领域的人,迟早会自己意识到「我得停下来」——他说,这就叫学习 3:50。
于是他引出控制论。cybernetics 听起来像跟赛博格有关,实则来自希腊词 kubernetes,意为掌舵人。之所以用这个词,是因为舵手是反馈系统的完美意象:舵手不是把船指向某个方向就完事,他持续读取当前状态——风、浪、航向——再与预定航线比对,然后调整。也就是试错 4:37。
他把智能系统拆成四个部件:参考信号(目标,系统持有一个目标状态)、传感器(感知,系统读取当前状态)、比较器(目标与现状之间的差距,算出的差就是误差信号)、执行器(行为,系统采取行动缩小误差)5:23。他强调控制论更像一副观察现实的框架:恒温器在太冷时开暖气,因为它感知到了误差并做出修正——这是个不太智能的系统;你的胰腺在血糖升高时分泌胰岛素,也是同一个结构。你的身体本身就是由无数智能系统组成的一个系统 6:10。
这正好暴露了问题所在:多数人学新东西时只盯着「内容」,囤材料,用间隔重复、抽认卡、课程、「打好基础」去吸收,他们假定学习是输入过程。他特别澄清自己不是说这些东西不好——他自己经常买课,因为他喜欢学东西——但现实是,学习是输出过程,因为输出会倒逼输入 6:10。
他预告了一期未来节目的主题「intellectual obesity(知识肥胖)」,并把信息类比成食物:信息是心智的食物,吃得多又不运动、不输出能量,就不会把它转化成任何东西,心智同理。他直接点名一种自我安慰:「我刷的是自我提升内容,不是脑残内容,所以我比他们强」——他说这是完全相同的行为,一样是廉价多巴胺,甚至更糟,因为你还多得到了一种虚假的进步感 6:56。
三、目标如何决定你能看见什么
链条被他压缩成一句:目标产生误差信号,误差信号产生过滤器,过滤器产生相关性(也就是「有没有用」),相关性产生记忆。大多数人的心智里塞满了噪音和永远用不上的东西 7:43。
接着是全篇最锋利的一段社会批评。想象一个被「默认路径」深度规训的人:社会给他分配的目标是上学、找工作、65 岁退休,他只知道这些。这个目标在指挥他的学习和行为——他朝某个方向行动,出现误差,然后多数时候无意识地修正误差以维持那个被别人设定的方向。于是那个被分配的命运必然成真,哪怕这个人本身并不自觉,甚至一开始就不想要 7:43。
他说这里最 pernicious(他自己都调侃不确定这词用得对不对)的地方在于:走默认路径的人根本不会注意到机会——赚钱的机会、健康的机会、任何能把生活改善到「65 岁退休」这个上限之上的机会。创业、做创作者、做个人品牌、聪明地利用 AI,这些都不会进入他的视野,因为大脑在主动过滤掉它们,它们连注册和留存的机会都没有,因为你追求的目标并不需要它们作为输入 8:29。他的结论很重:这些人不掌控自己的人生,他们是别人理想的傀儡,而这是绝大多数人。
有意思的是他接着做了一个元层面的动作:如果这期视频正在你脑子里起作用,一个新目标正在形成,你的行为和学习就已经开始朝那个方向捕捉机会了——仅仅是意识到这可能是个问题,就已经在改变你的行为方向 9:15。他顺带承认这本身也是一种营销,但是建立在真实心理学而非 Instagram 上流行的表层心理学之上的、更好的那种营销。
方法上的核心指令是:有意识地构建你自己的框架,方式是清楚地知道你不想要什么,并把它与一个持续演化的、你想要的人生图景做对照。只有这样你才能感知到自己偏离了,注意到误差,修正方向,学习作为副产品自然发生 10:01。他重复了这句并说「这就是全部,这字面意义上就是成功」。具体做法:在脑中构建一个你极度不想成为的人的形象,然后朝反方向瞄准;那个反方向的形象是想象出来的,所以你要像雕塑一样,通过与「不想要的」和「当下所在」反复对照来打磨它,最终你会慢慢变成那个愿景 10:47。
四、三个步骤:着魔、开项目、追 specific knowledge
步骤一:为一个有意义的目标着魔。 方法是审视你当下的行动,看清如果不改变,人生会走向哪里——对大多数人来说那个画面并不好看。他要求听众暂停视频,真的坐在那个画面里,让它把你填满一种强烈的情绪,再把这股情绪能量转向更好的方向。他说自己人生改变的几个时刻正是这样:一种前所未见的「神圣能量」灌满全身,喉咙发紧,只想扑向目标——他称之为世界上最棒的感觉之一 11:34。他还提到极端投入一个目标会改变大脑、增强神经可塑性;关于「先别辞职、先有 Plan B」的常规建议他说那当然可行,但他个人在压力下才最能发挥,宁愿「烧掉船」,他也坦承这是很男性化的表达方式,偏女性取向的听众未必共鸣 12:19。
步骤二:不要开始学,要开始项目。 他的说法是「你想要的人生躺在一连串有意义的项目的终点」。项目就是一组结构化的目标与里程碑,是把目标变成可触可交付之物的方式,而且最好要发布——如果是产品就上线,如果是文章就发到社交媒体去拿市场反馈。心智要当作项目来对待,身体、关系、财务、任何领域和技能都是 13:05。项目的关键作用是给学习提供一个框架,把不重要的噪音过滤掉:任何不能直接推进项目的东西,至少现在不值得学,因为你反正也记不住 13:52。
步骤三:追求 specific knowledge。 他直接播了 Naval 的原话:每个人都该弄清自己独一无二做得最好、且与自己根本上契合的那件事,它给你真实性,给你 specific knowledge,给你竞争优势,让你不可替代——而有时你不做就不知道那是什么 13:52。Dan Koe 就着最后半句补刀:新手总卡在「我该做什么」,答案是随便做点什么,你是通过做来学会该做什么的。这是个悖论,所以他们理解不了。他拿发帖举例并直接开火:你怕第一条帖子扑街?你难道以为第一条帖子会大爆、你会突然走红?当然会烂,当然会糟糕,当然会让你难堪——那恰恰就是全部的意义所在。他自嘲说自己不是暴力的人,但真想给对方一巴掌然后说「兄弟,发就完了」14:40。
学校教的是通用知识或岗位所需的知识,不教你如何导航自己的路;它把你收窄到一个学科里,本质上并不为「自主导向的工作」——创业,或者单纯做你想做的事——做准备。自我教育则是学习实现自我生成目标所必需的东西,而不是囤积通用知识来营造「我在学习」的错觉 15:26。
五、After Effects 与吉他:按需拆教程的具体操作
他用两个例子把方法落地。第一个是 Adobe After Effects——一个极其复杂的动画软件,打开就是一堆毫无意义的按钮。常见反应是先去看一个「After Effects 入门教程」,但看完你还是回到原点,界面里什么都找不到,接着陷入「我得把这软件里外学透才能创作」的循环,而这完全不成立 16:13。
正确做法是先要有一个想造的东西、一个脑中的画面。他以自己过去在 Instagram 上做的极简线条动画为例:他会去找一个专门教这种动画、或至少高度相似的教程,这样才能把学到的东西立刻应用。关键洞察是——教程里大部分内容对你没用,但你会自动过滤,只注意到你真正能拿去用的部分;然后一遍遍重复,直到你叠够了足够多的技术。不是掌握 After Effects、Photoshop、Canva 或 Eden 侧边栏里的每一个工具,而是叠够能做出你要的那个结果的技术 19:16。
第二个例子更直白:学吉他。你会先去研究乐理吗?大概不会。你选一首想弹的歌,试着弹,发现不知道弹什么,于是学第一个和弦,再第二个、第三个;过程中你会自然捡起别的东西——「这听起来不对,我得调音,我得加变调夹」——一点点攒起小技巧,直到能弹完一首,然后下一首,然后再下一首;到某个时刻你觉得也许可以试着写一首很简单的自己的歌;再过几年,你什么都能干了,你是大师了 20:01。他说这就是学习的全貌,「对所有想要要点总结的人:去做事。看看这对你有没有帮助。」
中间他插入了一段情绪很重的行业批评:他极其反感那些「教你 5 秒内爆火」或「这个 App 会让你爆火」的产品与内容。原因是注意力和心理学的细节必须靠大量实践和市场反馈来积累模式识别,才能成为真正的专家 16:58。他还给出一个值得注意的区分——代码相对客观,AI 能写出能跑的代码,因为「能不能跑」就是价值判据;但内容、写作、创意、艺术是主观的,价值随文化、市场成熟度、某个点子被跑烂的程度而变化 17:43。所以哪怕 Claude 告诉你某条内容会爆,也不作数。他说做 Eden 时完全可以昧着良心给用户一套「大概率让你爆一次」的系统赚一大笔,但那对用户毫无用处——他要做的是一个能被持续使用的好工具 18:29。
六、第二大脑的病理学:从 Roam 到 commonplace book
后半段转向笔记系统。他描述的场景很多人熟悉:疯狂捕捉想法、写笔记、按收藏和书签,然后再也不看。那些东西显然是有价值的——你保存它是有理由的——但你从没把它应用到生活里。他不认为你会应用成千上万条笔记,但那里确实躺着大量金子,问题是怎么管理 20:47。
他有相当长的亲身履历:第二大脑之路始于 Roam Research,它彻底改变了他写 newsletter 的方式——他建起了一个高浓度想法的知识库,写作时可以直接调用,因为研究早已完成,他的笔记本质上是「预备性研究」21:35。几年前他做了 Cortex,本意不是第二大脑软件,但因为要把他的写作流程产品化,就必须内置笔记、连接和标签,结果就长成了那个样子。他说 Cortex 最终失败了——又立刻修正说也不算失败,而是很痛苦地演化成了今天的 Eden,这也是他这段时间很少发内容的原因 21:35。
结论是:第二大脑不是没用,是被误用了。它们很强大,只是人们不会用。「在 Notion 里把你整个人生组织起来」帮不了你多少,因为你收藏、你记笔记,然后它们再也不见天日——你以为自己在学习,其实是在浪费时间,而那段时间本可以真的用来学习、与现实交互、试错 22:21。
他把这件事放回历史里:在第二大脑被包装成一个营销概念之前,人们有的是 commonplace book。Marcus Aurelius 的《沉思录》本质上就是一本私人 commonplace book——写给自己的笔记和消化过的哲学,从未打算出版。Leonardo da Vinci 写满了数千页笔记本,装着素描、观察、疑问和借来的想法。Mark Twain、H.P. Lovecraft、Thomas Jefferson、Ronald Reagan、Rick Rubin 等等都有各自的版本 22:21。
关键差别在于:这些创作者的想法集合是他们创造物的燃料。他甚至说得更狠——如果没有某种形式的 commonplace book,他们的发明、写作和音乐不会是今天这个样子,你甚至可能根本不知道这些人是谁;随即他自己收了一下,说数字版 commonplace book 不是成功的绝对必要条件,但确实很有帮助 23:06。
于是他提出替换命名:与其叫第二大脑,不如叫第二潜意识。因为当你创作时,潜意识会吐出与之相关的想法,提升作品质量,但它的处理能力有限,有时干脆罢工,把你晾在创作瓶颈里。第二大脑系统缺的恰恰是——没有可应用的项目,也不会在恰当的时机吐出想法 23:06。他引用了 Seneca 的比喻:像蜜蜂一样从许多花上采粉,再消化成自己的蜜——这是 Seneca 版的「像艺术家一样偷」,他还开玩笑说不知道《Steal Like an Artist》的作者是不是从 Seneca 那儿偷来的。这也是写作障碍的解药:你之所以没题材,是因为你没有可调用的想法库。他坦承本期视频里说的每一件事,都来自他此前保存过的文章、视频、社交帖、随手想法和高亮 23:53。
七、两条落地路线:Claude+Obsidian,或嵌入型工具
选工具(步骤一)。 他引用 Devon Ericson 的话给 AI 定位:别对 AI 有多聪明这件事大惊小怪,它比一袋湿透的锤子还笨;要利用的是它在大数据集上做快速输入输出、处理简单任务的能力 24:38。接着他花了一段抨击 AI 议题的阵营化:那些说「你只要用一次 AI,你做的一切就废了」的人(他提到了 Hank Green 那场风波),以及 100% 挺 AI 的人,在他看来同样愚蠢——他说看到一些他本以为思考有层次的人在「AI 宗教」里选边站,挺让人难过的 25:24。
他指出现有笔记软件的共同缺陷:大多需要手动维护,有些加了个 AI 聊天框(他承认这有用),但缺的是最有用的那个应用——让你的想法不至于消失在虚空里,因为你的创作依赖于在恰当时机把它们重新浮现出来的能力 25:24。目标很朴素:能把想法丢进去,然后在写作、创作或做项目时找到它。
路线一:Claude + Obsidian。 他给了完整步骤 26:55:
1. 下载 Obsidian 和 Claude;
2. 打开 Claude Code 或 Claude Cowork,把 Obsidian Vault 所在的本地文件夹选为工作目录(因为 Obsidian 本质上就是本地文件夹);
3. 建一个「保存想法」skill:让 Claude 创建一个 skill,把你丢进去的想法、链接或帖子在 inbox 文件夹里生成一条带清晰标题的笔记;
4. 建一个「处理收件箱」skill:让 Claude 创建一个 skill,遍历 inbox,打标签、移动到正确的文件夹,并向库内其他相关笔记添加反向链接;
5. 让 Claude 帮你定义 taxonomy,这样它知道该用哪些标签和分类——这一步你要过目并批准,之后可以持续迭代。
他补了一条方法论:跟 AI 打交道最好的方式就是直接问它「我该怎么创建一个 skill/一个好的 prompt」,而不是问基础问题;它未必每次都给最好的答案,但没关系,因为你本来就不该指望一次成功——和 AI 协作最接近试错过程本身,你必须一遍遍打磨。如果你甘于将就平庸,产出的就是平庸,而反 AI 的人以为世上只存在这种平庸 27:42。他还顺带损了一句:很多人只是把「收集 Notion 模板」的执念换成了「收集 Claude skills」的执念,并说他想做一个 AI 使用的钟形曲线 meme——左边的笨蛋是「你就直接告诉它要干嘛」,中间是各种花哨 skill,右边高手还是「直接告诉它要干嘛」;但要成为右边那个人,你得知道自己要干嘛,而多数人不知道 26:10。
路线二:嵌入型工具(my mind / Eden)。 差别在于你添加的每一样东西都会被自动分类、打标签并嵌入。这意味着你能搜索和找到想法,而不消耗你的 Claude 额度;想用 AI 访问第二大脑,直接把 Eden 接到 MCP,不必折腾 31:33。他解释了自动标签与分类的意义:这类应用能告诉你「附近有什么」,能给出新奇的关联,因为每条内容都被嵌入成 1500 多个数字,像想法的 GPS 坐标,不需要关键词匹配就能找到相关想法 31:33。
他也给了「为什么不自己造」的现实理由:你大概不想维护一个向量数据库、嵌入 API、索引脚本、笔记变更后的重新嵌入、文件改名后的索引同步、以及避免为未变内容重复付费的缓存 32:20。他说很多人开口就是「我自己做个 App」,但真相是:生活里非常简单的东西可以自己做、自己维护(本地小应用完全可以),但像 Eden 里那种爆款内容检索(outlier search)功能,你不会花自己一两万美元去存储和维护数据库、持续抓取和索引创作者内容——你可以零星爬几个创作者,仅此而已 33:05。
八、捕捉什么、以及把知识变成作品
步骤二:捕捉那些最能代表你理想心智的想法。 他给的理由是:当 AI 能创造一切时,策展(curation)比以往任何时候都重要。你需要一个能激发灵感的、被策展过的想法空间,它是社交媒体信息瀑布的反面 33:05。
对创作者而言,这件事关乎生存逻辑:人们不再为你的「内容」关注你——有 Google,有 AI,一点就有海量信息。人们关注你,是为了你的视角、你的观点、你的诠释、你的个性、你的故事。而这些全都是你世界观的下游,也就是你用来理解世界的那些想法 33:52。他举自己为例:当他聊到实在的本质时,脑子会跳到历史、integral theory、spiral dynamics 等概念,因为他判定这些是理解那类对话最有用的透镜,其他听过的想法相形之下都站不住 33:52。
他在这里插了一段对「你就是你的赛道(you are the niche)」的辩护。最近有些内容反驳说「不,你不是赛道」,但他认为那是误解——「你是赛道」不等于成天发关于你你你的内容,而是说你在公开场合把你的心智摆出来供人探索。你的心智不只是性格特质和人生故事,而是那些互相勾连成网的想法,它们决定了你表达方式的独特性。所以第二大脑(或第二潜意识)用对了,就是这张网的外化,是你与公开作品之间的一个中间层 34:38。
因此该捕捉的是:构成你世界观的东西,或者足够强大、终将构成你世界观的东西——你听一期播客,突然觉得「哇这个想法真好,我喜欢」,那就是你该保存的 35:24。具体做法他列了几条:多读书;让好奇心引路;拒绝无脑刷;策展一批致力于产出好想法的作者和思想者名单;给研究留出时间——因为对写作者和创作者来说,研究是 80% 的工作 35:24。
他在这里再次明确立场:注意我没有选边——我没说你碰了 AI 就脑死亡,因为事实不是这样;但我也没说你不该读书或该把创造力外包出去。即使有 AI,它也只是工具,别在脑子里过度夸大它;那些通往好心智和好人生的事你还是得做。如果 AI 正在从中扣走这些东西,那就在那个具体场景里停用它,或者改变使用方式 36:10。
步骤三:通过创作来构建你的理想心智。 他强调必须闭环:我们已经有了捕捉与检索知识的系统,但还需要一个能把它应用上去的项目,否则知识就浪费了;而且没有理由去学,我们也就无法捕捉到 specific knowledge,因为大脑得不到那个「判断哪些想法重要到值得保存」的框架 36:56。他坦率地承认目标本身是双重的:我们想变聪明,想记住学到的东西,可能有点虚荣地想让自己听起来能言善辩——但也因为我们的人生结果确实取决于我们的决策,而聪明程度和表达自身价值的能力确实对结果有正面贡献。
九、写作工作流:表现×兴奋,以及 AI 的边界
他说自己不能替你决定创作什么——可以是一张图、一个设计、一个 Photoshop 项目——但他能给出自己的写作流程,最近正好帮到一个苦于「所有想法塞不进一篇文章」的人。以写一篇 Substack 文章为例(也适用于 YouTube 脚本或 X 长文);他顺带说了句观察:人们正在转向长内容,因为受够了无脑短视频 37:42。
第一步:选题=表现 × 兴奋。 「表现」指已被验证能跑的题目,找法是平时保存爆款社交帖,或用能找爆款内容、研究创作者高赞帖的工具。他强调这不是社交媒体带来的新东西,而是一直如此:你以为你喜欢的音乐人是靠随便发点声音出名的,还是有结构、会考虑受众和市场如何反应?很多艺术家跳过了商业那部分,声称不在乎市场怎么想,这正是他们成为「饥饿艺术家」的原因 38:28。他明确表态:策展灵感、保存跑赢过的帖子,是为了知道市场上什么有效,然后把原则应用到自己的写作里——这不牺牲你的声音,因为它仍要过你的品味这道过滤器。
「兴奋」指你出于好奇想探索的题目。你的工作是把「你想写但大概率不会火」的题目,与「已被验证能火」的题目配对,这样你既写了想写的,又提高了传播的可能性 39:14。
他现场把这套逻辑用在了本期节目上:这期视频的标题里之所以有「how to remember everything you read」,正是因为过去有几百个用这个标题的视频火过。那这期和它们是同一个视频吗?不是,恰恰相反——因为他说的是「别这么干」38:28。
第二步:brain dump → 大纲 → 初稿。 你不能一上来就写初稿;写作者不会打开空白页然后指望所有想法线性地各就各位。先做 brain dump:写下所有可能归入这个主题的想法,同时翻你的笔记、想法和链接一并加进去。这一步他用 Eden 的 board:翻库、搜库、向 AI 聊天要某类想法,然后把这些全部丢进一个专门的 board,写作时所有研究材料都在那儿可以随时打开对照 39:14。有了原料再加结构做大纲:把 brain dump 里的想法塞进一个通用的叙事框架,通常落在「问题—洞察—解决方案」三段里——新建一个文档(想用纸也行),按「什么属于问题」「主要洞察是什么(通常就是你真正想聊的那个兴奋点)」「解决方案或步骤是什么、你到底要人们做什么」来归类 40:00。到写初稿时,你面前有空白稿、brain dump、全部研究、以及大纲,剩下的只是把它们综合成句子 40:45。
第三步:用 AI 去摩擦,而不是替你写。 他澄清「别让 AI 替你写」的确切含义是:别用 AI 来表达你的观点和信念。他讲了一件被人指出的事:有人问他「你那篇文章不是用 AI 写的吗?」答案是——是的。在他那篇 Twitter 上阅读量最高的文章里,有一段就是 1 到 9 的要点罗列,是对 Susan Cook-Greuter 自我发展九阶段的简短描述。那不是他的想法;任何别的写作者要描述这九个阶段,一样会去 Google 查。所以他确实让 AI 生成了那段,因为那不是他的观点、不是他的信念,他不想搞错,他要的是尽可能贴近 Cook-Greuter 原版的表述——他认为这不减损文章的价值 41:32。
反过来,他坚持自己真正在乎的那些想法必须自己写,因为他理解「亲自把它表达出来」如何改进他的心智和能力;他不愿浪费力气去重写九阶段是什么,因为那正是学校里为了背诵而做的事——而本片第一句话就是:需要刻意记的就不重要,重要的你自然会记住 42:19。同时他坚决主张:在艰难地表达自己的想法这件事上是有价值的,因为那个卡壳会制造一个缺口,而你可以去学习并填上它 42:19。
那么「去摩擦」具体指什么?把 AI 当作你在学技能过程中的课程、导师或编辑来用,因为 AI 擅长扫描大量信息、把你需要的部分捞出来 42:19。落到写文章上:不知道文章怎么结构化,就要一份「你的想法可以套进去的结构清单」——这本来也是课程会给你的东西;不知道下一段写什么,就要几个可能的走向,然后选一个或者一个都不选;有不懂的就去研究,就像过去的写作者用更低效的方式在互联网上翻找信息一样 43:05。
他也不回避幻觉问题:AI 当然有时会出错。但接着呢?难道所有人都把它当法律接受,而不去质疑?他认为这和在 Instagram 上看到一个其实根本不懂的「人类专家」发表观点、观众照单全收是一回事——反 AI 的人的脑子正是这么坏掉的;为了平衡,他补了一句:100% 挺 AI 的人也蠢得像块石头 43:05。最后的落点是信任与责任:我就是相信你有脑子,最终决定发什么、写什么的人是你;如果成品不能代表你想要的价值观、想法和信念,那就打磨到能代表为止,或者干脆别发 43:51。
金句
如果你需要刻意去记它,它就不重要;如果它重要,你会记住它。 —— Dan Koe 0:00
学习来自挣扎,不来自记忆。开始项目。不,别先看 20 个教程。让它暴露你的知识缺口。 —— Dan Koe 2:17
他们假定学习是一个输入过程。但现实是,学习是一个输出过程,因为输出会倒逼输入。 —— Dan Koe 6:10
目标产生误差信号,误差信号产生过滤器,过滤器产生相关性,相关性产生记忆。 —— Dan Koe 7:43
与其把它当成第二大脑,我更愿意把它想成第二潜意识。 —— Dan Koe 23:06
人们不再因为你的内容而关注你,他们关注的是你的视角、你的诠释、你的故事。 —— Dan Koe 33:52
当 AI 能创造任何东西时,策展比以往任何时候都更重要。 —— Dan Koe 33:05
提到的书·产品·人物
- Naval Ravikant(人物):节目中直接播放了他关于 specific knowledge 的原声——找到你独一无二做得最好、且与你根本上契合的事,它带来真实性、竞争优势和不可替代性 13:52。
- Marcus Aurelius《Meditations(沉思录)》(书/人物):被举为 commonplace book 的典范——写给自己的笔记和消化过的哲学,本无意出版 22:21。
- Leonardo da Vinci(人物):写满数千页笔记本,装满素描、观察、疑问和借来的想法 22:21。
- Mark Twain / H.P. Lovecraft / Thomas Jefferson / Ronald Reagan / Rick Rubin(人物):都被列为拥有某种 commonplace book 变体的成功创作者 22:21。
- Seneca(人物):其「从许多花上采粉、消化成自己的蜜」的比喻被引为「像艺术家一样偷」的古典版本 23:53。
- 《Steal Like an Artist》(书):Dan Koe 调侃其作者是否从 Seneca 那里「偷」了这个比喻 23:53。
- Susan Cook-Greuter(人物):自我发展九阶段的提出者;Dan Koe 承认自己那篇 Twitter 上阅读量最高的文章里,九阶段的要点段落是用 AI 生成的,因为那不是他的观点 41:32。
- Devon Ericson(人物):被引用的一段对 AI 的定位——「别对 AI 有多聪明大惊小怪,它比一袋湿透的锤子还笨;要利用的是它在大数据集上快速输入输出的能力」24:38。
- Hank Green(人物):作为 AI 议题阵营化风波的例子被一笔带过 24:38。
- Eden(产品):Dan Koe 自己的创作者工具,节目中多次出现——新增阅读器与高亮库、可导入 Kindle/X/Snipd 高亮、自动整理、outlier 爆款检索、跨平台排期发布、可接 Claude MCP,并附带 Creator Bootcamp(含在 Eden Pro 内)1:32 43:51。
- Cortex(产品):Dan Koe 几年前做的写作软件,本意不是第二大脑但演化成了那样,最终痛苦地转型为今天的 Eden 21:35。
- Roam Research(产品):他第二大脑之路的起点,彻底改变了他写 newsletter 的方式 20:47。
- Obsidian + Claude Code / Claude Cowork(产品):搭建数字 commonplace book 的路线一,配合「保存想法」和「处理收件箱」两个 skill 使用 26:55。
- my mind(产品):与 Eden 同类的自动分类、打标签、嵌入型知识库工具 26:55。
- Notion(产品):被当作反面例子——在里面组织整个人生并不会真的帮到你 22:21。
- Adobe After Effects / Photoshop / Canva(产品):作为「按需拆解教程、叠加技术」学习法的例子出现 15:26 19:16。
- Substack / X(Twitter)/ YouTube / Instagram(产品):作为发布与研究场景反复出现,其中 Substack 长文被指出正在回潮 37:42。
- integral theory / spiral dynamics(概念):Dan Koe 用来理解「实在的本质」类话题的首选透镜 33:52。
- cybernetics(控制论)(概念):全片的理论骨架,源自希腊词 kubernetes(掌舵人)4:37。
适合谁听
想摆脱「囤资料却学不会」循环的写作者、创作者和自学者,尤其是正在纠结要不要搭第二大脑、以及该如何在创作中使用 AI 的人。