核心要点
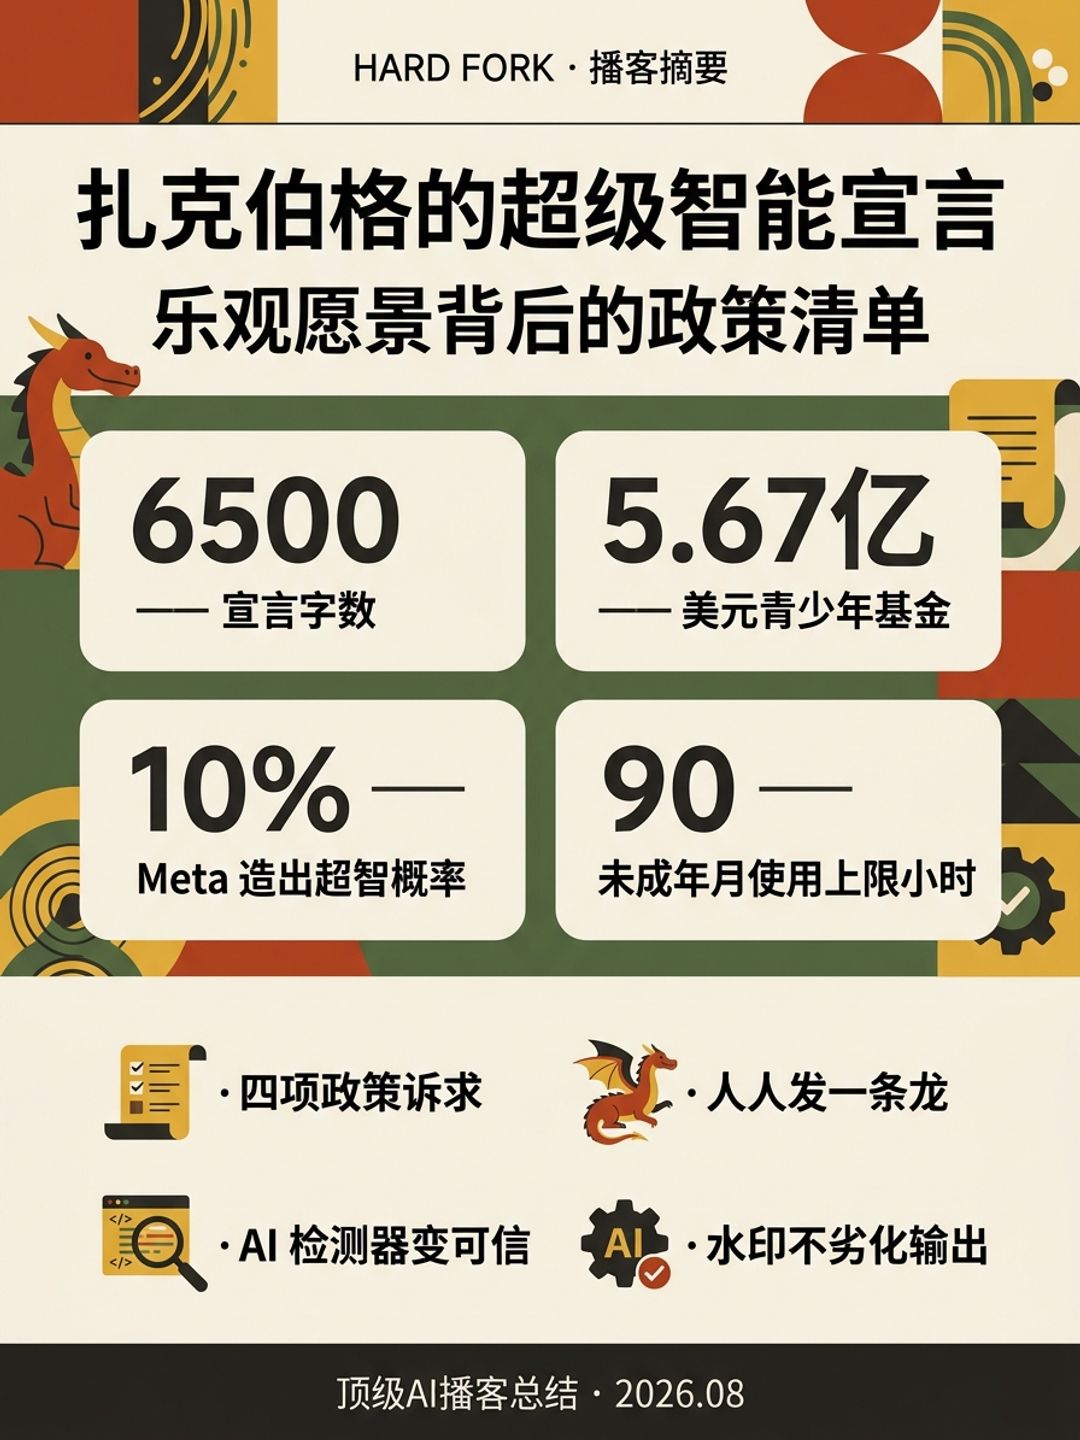
- 政策愿望清单:Casey 指出宣言真正的目的是四条对 Meta 有利的政策诉求——加速数据中心审批、维持先进芯片出口管制、放松训练数据限制、为模型蒸馏提供法律保护,全都精准对应 Meta 的商业处境与正在打的官司。
- 给所有人一条龙:Casey 用《House of the Dragon》类比,"让每个人拥有对齐自身价值观的超级智能"听着漂亮,但等于把龙发给所有人;多数人只是拿它做亲子烘焙食谱,少数人会拿它发动网络攻击或设计新型病原体。
- 5.67 亿美元罚款:宣言发布时机紧挨着 Meta 的法庭连败——新墨西哥州法官判其额外支付 5.67 亿美元进入青少年心理健康修复基金,外加 3.74 亿美元民事罚金,并认定 Meta 平台构成"公共妨害"。
- 超级智能概率上调:Kevin 说自己对 Meta 造出超级智能的判断从半年前的 1% 上调到约 10%——Meta 重组 AI 部门、抽调工程师去做强化学习训练数据的做法得到业内认可,最新模型结果不俗。
- 最危险的公司类型:一位前 DeepMind 高管的分类被引为本期核心框架——做工具和做 AGI 都可以做得负责任,真正危险的是"以为自己在做工具、其实在做超级智能"的公司,因为它不会采取相应的防范。
- Pangram 的技术路线:Max 解释旧检测器依赖 perplexity(AI 文本"过于平滑"),但《独立宣言》和英语学习者的文章同样低 perplexity;Pangram 改为用同题人类作文与 AI 仿写配对训练分类器,靠全文数百个弱信号累积置信度。
- 水印不等于失业:Anthropic 为欧盟 AI 法案给全部文本加水印,Max 认为是行业对可检测性的背书;只要只在"熵足够"的 token 上打水印就不会劣化输出,但水印覆盖不到的缺口仍需 Pangram 补。
章节时间轴
- 0:00 又一篇 AI 宣言 — Zuckerberg 发表 6500 字《The Future Is For Everyone》,承诺人人拥有理解你目标的超强个人 agent。
- 1:33 给每个人发一条龙 — Casey 用《House of the Dragon》的双方持龙内战类比 AI 扩散,质疑"人人超级智能"的安全逻辑。
- 3:52 攻防真的会平衡吗 — 网络安全或许成立,但新型病原体这类攻击,防守方追上来需要时间;宣言只对风险一笔带过。
- 5:25 为什么是这篇、为什么是现在 — Casey 逐条拆出四项政策诉求:数据中心审批、芯片出口管制、训练数据限制、蒸馏的法律保护。
- 6:58 法庭连败与转移视线 — 新墨西哥州判 5.67 亿美元修复基金加 3.74 亿罚金,平台被认定为"公共妨害",未成年人月使用上限 90 小时。
- 9:15 Meta 真有机会造出超级智能吗 — Casey 说永远不要低估 Zuckerberg;Kevin 把概率从 1% 上调到 10%。
- 11:33 两类 AI 公司,和最危险的第三类 — 前 DeepMind 高管的框架:做工具与做 AGI 都可以负责任,"以为在做工具却在造超级智能"最危险。
- 13:52 最差的信使 — 从带来剑桥分析的人手里接过超级智能;Casey 说扭转民意靠的不是宣言,是涨薪、治病、教育这些真实收益。
- 17:45 Slop 的第三个时代 — 从嘲笑六根手指,到发现 slop 真的有人看,再到平台开始重新考虑如何展示 AI 内容。
- 19:17 Kevin 承认自己看法变了 — 曾认为 AI 文本检测毫无价值,如今认为 Pangram 的结果值得认真对待。
- 20:48 嘉宾 Max Spiro:从 perplexity 到分类器 — 旧方法的漏洞与 Pangram 的配对训练法,靠弱信号累积而非破折号。
- 24:41 Humanizer 猫鼠游戏与新模型冲击 — 打错字、插零宽字符、逐词改写;新模型出来时召回率短暂下降,几周后重训跟上。
- 29:17 为什么要做"slop 清洁工" — 机器人流量已与人类流量持平,Max 认为未来需要在算法层面"歧视性地偏向人类"。
- 33:10 Substack 集成引发的争议 — 付费订阅被 AI 代写算欺骗,朋友的私信被 AI 代写同样是背叛;Hank Green 事件被视为过火。
- 36:15 Anthropic 水印与 SynthID 原理 — 水印通过扰动采样决策实现;只在熵足够处施加就不会劣化文本,代码这类低熵场景则打不上。
- 40:04 图像检测与身份验证的下一步 — 图像检测进入研究预览并在公开基准领先;Chrome 插件已能回放 Google Docs 的粘贴痕迹。
- 44:42 新栏目 Running the Numbers — 黎曼猜想进展、Airtable 贱卖、韩国芯片工程师的婚恋行情。
详细内容
一、宣言里写了什么,以及它没写什么
Zuckerberg 这周发表了 6500 字的长文,标题是《The Future Is For Everyone》,此前他还在《华尔街日报》上发过一个短版。Casey 打趣说照这个趋势,他会不断写出越来越长的 AI 宣言,直到诉求被满足为止。
文章开篇是一个相当模糊的乐观愿景:我们有幸活在一个不可思议的历史时刻,未来几年人们将能够使用超越人类能力的超级智能去创造和发现新事物、创办企业、表达新想法、学习新概念、改善健康和生活质量。接着他谈到 Meta 在建什么——让每一个用户都拥有一个"极其强大的个人 agent",它理解你、你的目标和你在乎的一切,你可以通过任何设备访问它,包括眼镜。
Zuckerberg 举了自己怎么用 AI agent 的例子:帮他标记有趣信息、辅助原型设计、监测睡眠和训练情况保持健康,以及每个周末给他和女儿生成个性化的烘焙食谱。文章后面还写了就业增长、算力、递归自我改进、生存风险、生物风险等等。
两位主持人对文风给了肯定:Kevin 说这篇文章看起来确实是人写的,文章一出就有人拿去过 AI 检测器,没有被标红。Casey 说他读的时候一次也没觉得在读 slop,某些段落"就是 Zuckerberg 说话的样子",虽然大概也像国情咨文一样有一堆政策幕僚在上面按过指纹。
二、"人人超级智能"这套逻辑的漏洞
Casey 本周在自己的 newsletter 里写了一篇文章,用《House of the Dragon》第三季大结局做类比。这部剧一开始是极端的权力集中——只有一个大家族掌握超级武器(龙);然后发生分裂,两个派系都有了龙,接着是一场血腥内战。
Casey 说这个类比和 Zuckerberg 的文章在一个很有意思的地方相遇了:Zuckerberg 主张让我们所有人安全的方式,是把 AI 在全世界最大限度地扩散,给每个人一个专属超级智能。"在我看来,这有点像给每个人发一条龙。"绝大多数人会用它来做亲子烘焙食谱,但另一些人会用它发动网络攻击、设计新型生物武器。
宣言里还有一个 Casey 称为"修辞转折"的动作:Zuckerberg 论证说,根本不存在人们常说的那种"完全对齐的通用 AI",因为人们的价值观、需求各不相同;与其造一个持有普世价值准则的超级智能,不如让每个人拥有一个契合自己价值观的超级智能。Casey 的反驳很直接——这是典型的"听起来很棒但实践中崩塌":给中国共产党一个完全服从并映射其价值观的超级智能,会让它得以对自己的人民实施暴行。
对这类质疑,行业里的标准答案是:超级智能帮助防守方的程度不亚于甚至超过攻击方,新的均衡会形成。Casey 说他相信这在某些领域成立,比如网络安全;问题在于有些攻击类型,防守方追赶需要时间——"如果我在电脑和实验室里造出一种新型病原体并释放出去,防守方就是要多花一段时间。"
Kevin 补充说,宣言里关于生物风险的那一节其实挺有意思:Zuckerberg 多年来有自己的团队在做生物学与 AI,他对这个主题很感兴趣,也确实承认在这个领域"攻防双方拿到同等工具"可能不是完美解法——然后他就把这个问题搁置了。Kevin 认为他不是完全天真,只是暂时没有好答案。
三、真正的诉求:一份可以带进国会的清单
Casey 认为,所有这些讨论都次要于这篇文章的实际目的——为一系列对 Meta 有利的政策立场背书。他把清单一条条列了出来:
加速数据中心建设审批——Meta 需要这个来推进它正在搭建的 neocloud 业务。
维持对先进芯片的出口管制——这一条特别有意思:一个自诩"开源先生"的人,却主张保留芯片出口管制,因为这让 Meta 的开放权重模型相对中国或其他替代品占据优势,"中国人拿不到 Meta 拿得到的芯片"。
放松他所谓的训练数据限制——这将帮助 Meta 应对创作者们就作品被用于训练模型而提起的多起诉讼。
为蒸馏提供法律保护——基本上就是允许 Meta 用其他模型的输出来训练自己的模型。
"所以埋在这个非常积极、快乐的 AI 愿景里的,就是一串帮助 Meta 这门生意的政策请求。"Casey 说,这份东西现在可以由 Meta 的所有说客带进国会,"看,Mark 在呼吁这些"。
关于时机,Kevin 提到有人猜测这是为了转移视线——Meta 眼下正深陷关于社交媒体产品各种失败与危害的诉讼与庭审。Casey 说这不用归给"有人",他自己就这么认为,不过他补充说这篇文章服务于多重目的,政策清单是其中重要的一个。
时机确实值得注意:Meta 正在一桩接一桩地在法庭上挨打,一个州接一个州起诉这家公司,主张 Facebook 和 Instagram 对青少年不安全。上周新墨西哥州法官判 Meta 额外支付 5.67 亿美元进入青少年心理健康修复基金,这是在 3.74 亿美元民事罚金之外的。而 Casey 认为真正会留下长期影响的是判决的定性:法官认定 Meta 的平台构成"公共妨害"(public nuisance),把 Meta 比作工厂,把对儿童的心理伤害和剥削比作它排放的污染。法官还下令实施按美国标准相当严格的新安全措施——18 岁以下用户每月 90 小时使用上限,以及对 AI 聊天机器人的一些新限制。
Casey 由此给出了本期最锋利的一段类比:曾几何时 Zuckerberg 也写过这样快乐的社交媒体宣言,说让世界更开放更互联,把每个人都拉进 Facebook 和 Instagram,让所有人对话,我们会迎来前所未有的民主。"结果不用多说,那并没有成真。现在同一套极大化、普世主义的框架又搬了出来,一如既往地 100% 契合 Meta 的商业利益,只不过这次换到了 AI 的语境里。"
四、Meta 到底有没有机会造出超级智能
Kevin 抛出一个关键问题:我们是不是该认真对待 Meta 造超级智能的可能性?"很多人对 AI 和超级智能的未来有看法,我们不太在意,因为那些人并不处在真能造出超级智能的位置上。"
Casey 说直到不久前他的判断是 Meta 已经出局了,但"永远不要低估 Mark Zuckerberg 的第一条规则是:永远不要低估 Mark Zuckerberg"——他是全世界最具竞争心的人之一,会为达成目标移山。一年多前 Meta 又一次重组 AI 部门以来,进展是显著的。Casey 说他的 AI 圈朋友对 Meta 过去一年的一些动作评价不低,尤其是把大批工程师调去做本质上是强化学习、生成训练数据的工作——Meta 的工程师们不太喜欢这个安排,但业内人士认为这会给他们带来真正有价值的东西。
Kevin 给了数字:半年前他会给 Meta 造出超级智能 1% 的概率,现在上调到大约 10%,"这是个很大的改善"。Meta 的模型在稳步变好,在建立 Meta Superintelligence Labs、重金招募研究员、采购算力之后跑的一些训练已经出结果,最新模型上有一些相当亮眼的成绩。"Meta 现在不是前沿实验室,但它显示出快速改善的迹象。"
而这正是让 Kevin 担心的地方,因为在他看来 Meta 在文化 DNA 和历史记录上都不是一家有能力大规模交付安全负责产品的公司。
五、最危险的公司类型
Kevin 由此讲了几年前和一位前 DeepMind 高管的对话,这段成为本期最有分量的分析框架。这位高管说,AI 公司分两类:一类认为自己在造工具,一类认为自己在造 AGI——某种可能比人类更聪明的实体。做哪一类都没问题:你可以像很多公司那样决定"我们不玩 AGI 这局,我们造工具,它们对人很有用,随着模型变强它们也会变强,这就是我们的生意";你也可以明确以创造 AGI 或超级智能为目标,只要你清楚自己在做什么、采取了正确的预防措施、抱着正确的态度,这同样可以负责任地进行。
"真正的危险,"这位高管说,"是一家以为自己在设计工具、实际上在设计超级智能的公司。"这类公司不会采取适当的预防措施,不会以正确的敬畏与警惕对待这项技术,因为它们内心深处并不相信这东西有一天会强大到危险——于是它们会毫无概念地一头撞进灾难。
Kevin 说当时这位高管讲的是 Google——几年前 Google 内部也在争论自己是在造超级智能还是只是在做更好的 Google Photos、Gmail 和搜索。而现在,Kevin 认为 Meta 正处在这个位置:它可能造出某种极其强大的东西,却抱着"这些东西永远只是能做食谱之类事情的工具"这种非常天真的态度。
Casey 接过话说,让他担心的正是这家公司的历史:它的运作方式就是尽可能地增长、把一切当成与对手的生死竞争,而对社会的外部性通常草草了事。"就在当下这个时刻,我都不相信这帮人能替我排一个病毒式舞蹈视频的列表而不损害我的心理健康。等你把新型生物技术的访问权给到这些东西,情况就更糟了。"
Kevin 补充了一层传播学判断:Zuckerberg 可能是整个 AI 行业最糟糕的信使。如果他以为写一篇阳光灿烂的超级智能愿景就能扭转公众对 AI 的看法、让人们停止抗议数据中心,那他大错特错了。Casey 接梗:"来自把剑桥分析带给你的那些人——超级智能。"
那么 AI 正向叙事该由谁来写、该是什么样?Casey 的答案是:这不是一个传播问题。AI 正向叙事的核心内容应该是 AI 驱动的新医疗突破、疾病被治愈、新岗位被创造、旧岗位涨薪、孩子在教育上表现更好。"但关键在于,它不是通过宣言来交付的,而是通过人类真实的体验来交付的。到目前为止,这道鸿沟对我们所有领先的 AI 实验室来说似乎都太宽了。"Kevin 总结成一句话:Ship it or zip it(要么发货,要么闭嘴)。
六、Pangram:AI 文本检测为什么突然变得可信了
节目后半段是嘉宾环节。Casey 说我们正在进入 slop 的第三个时代:第一个时代是几乎人人都在嘲笑那些一眼假的文字和六根手指的人;第二个时代始于我们发现有些 slop 真的非常受欢迎,比如 TikTok 上的《Fruit Love Island》这类节目动辄数百万播放,证明 slop 确实有需求;而现在是折中阶段——是的有些 slop 很火,但许多平台开始基于用户真实需求重新思考如何展示和推荐 AI 生成内容。LinkedIn 和 Substack 近几周都采取了标注或识别 AI 生成内容的措施。
而当有人因为使用 AI 被公开点名时,Kevin 说他看到的截图几乎都来自同一个应用:Pangram,互联网上头号 AI 文本检测器,Casey 称之为"头号告密者"。
Kevin 在这里做了一次公开的立场修正:他此前在节目里论证过 AI 文本检测基本毫无价值、不可信、误报太多,学生和老师都不该用。但过去几个月越来越多的证据表明,至少 Pangram 以及可能还有其他一些工具已经变得相当好——不完美,仍有误报和漏报,但比一两年前好太多。Casey 说现在如果有人给他看一个 Pangram 结果说"这是 100% AI 生成"或"这是 100% 人写的",他会认真对待。
嘉宾 Max Spiro 是 Pangram Labs 联合创始人兼 CEO,前 Google 软件工程师,此前在自动驾驶公司 Nuro 工作,公司原名 Check for AI。他自称"slop 清洁工"(slop janitor)。
技术路线的转变。 Max 解释,此前所有 AI 检测系统都各有缺陷,主要问题是它们使用一个叫 perplexity 的指标——AI 文本平均而言对语言模型来说"不那么令人困惑",perplexity 更低;人类写的文本则会有让模型意外的东西。Kevin 概括为"可疑地平滑"。但这个方法漏洞很多:任何被模型记住的文档同样是低 perplexity,比如《独立宣言》;英语学习者写的简单英语也是。
Pangram 的做法完全不同:训练自己的分类器网络。比如拿一篇七年级学生写的《白鲸》读后感,再让 LLM 以七年级学生的口吻写一篇同题作文,模型就能学到 A 和 B 之间的差异,搞清楚 AI 文本到底长什么样。因为它是神经网络而不是一个指标,可以靠更多数据和算力持续变强。人类训练集全部来自 2022 年之前,"所以我们知道它是干净的"。
至于分类器学到的"破绽"是什么,Max 说绝对不只是破折号和固定短语——那是人类识别 AI 的方式("not just X but Y"、GPT 那种短促断句)。Pangram 真正在做的是把整篇文档里大量非常弱的信号组合起来:AI 在各种决策上会以某种一致的方式选择,而人类的决策树更宽、更没有 mode collapse,于是沿着一整篇文档就能在用词选择等维度上累积出置信度。
误报与漏报的取舍。 Casey 提到有人批评 Pangram 漏报太多——科技作者 Alex Heath 多次说自己的 newsletter《Sources》借助 AI 写作,但在 Pangram 或 Substack 的 Pangram 集成里始终显示为人类撰写。Max 承认这是刻意调校:Pangram 高度倾向于最小化误报,避免误伤;代价是漏报。但反过来,一旦 Pangram 判定某段文字是 AI,"我们可以非常有信心它基本上就是 AI 生成的"。
Humanizer 的猫鼠游戏。 针对检测器出现了一整类"人性化"工具:插入错别字、加入零宽空格 unicode 字符(人看不见但模型看得见)、或者逐词改写。Max 说这确实是猫鼠游戏,学生常用,Pangram 的应对是持续收集最新的 humanizer 并把它们纳入下一代模型的训练。
新模型发布带来的冲击相对可控:Pangram 在模型家族内泛化得不错,见过 GPT 5.4 和 5.5,那么 5.6 或 6 出来时即使文风有变化,准确率通常仍然可以;Fable 和 Mythos 也类似,Pangram 能从系统卡里的 Mythos 写作样本中捕捉到它,哪怕此前从未见过。不过新模型刚出时召回率通常会略降,几周内拉取新文本重训后恢复。
至于三年后模型是否会因为学会模仿个人文风而彻底躲过检测,Max 认为 Pangram 检测的东西比"Claude 文风"更微妙:前沿实验室专注于爬能力曲线,它们给模型施加偏好——不再是预测任意作者的平均下一个 token,而是偏好写出好文章、正确代码、正确数学,"这些偏好很大程度上正是 Pangram 能捕捉到的东西"。
七、为什么要检测,以及水印之后还剩什么
Kevin 提出了反对方的观点:有人从根本上反感 AI 检测这件事,说你不会写个程序去查别人有没有用拼写检查或计算器,如果 AI 只是工具的话。
Max 的回答是"AI 是工具"这个抽象本身就不对——今天它更接近于一个员工、一个和你协作的个体。而他真正在为之构建的是 AGI 未来:今天互联网上机器人流量已经超过人类流量,大约五五开;他认为几年后、也许十年后会是 99% 的机器人流量——自主 agent 上网写 GitHub 评论、推广自己的 Substack、给面包店拉客。"这项技术远比拼写检查或打字机强大得多,它是它自己的独立实体,它能认知。正因如此,我们人类有非常强的理由要在算法层面歧视性地偏向人类。"
Kevin 反问:在你描述的 99% 是机器人的未来里,我们不是应该给人类内容打标签,而不是给 AI 内容打标签吗?Max 说这是一枚硬币的两面,他真正想要的是平台在推荐算法里优先人类内容——因为 AI 可以针对参与度做优化,短视频里那些"能以真人视频做不到的方式激活参与神经元"的 AI 视频就是例子,"我们需要对此有防御手段"。
Substack 集成的争议。 Casey 说他很喜欢这个集成:他会看到一些文章走红,点开一看"就是明显的 Claude slop"。Max 说这个集成很有争议,反对声音很多,主要来自用 AI 写内容的人——他们担心被点名,不希望读者知道,还会谈论"猎巫":以前大家喜欢我的内容,现在他们要知道这是 AI 生成的了,这会打破现状。Casey 的翻译很尖刻:"现在他们知道这是什么了,就不喜欢了。让我们回到他们还不知道的时候吧。"
关于普通读者到底在不在意,两位主持人和 Max 讨论出了一个区分:付费是一条线("如果我付你钱、你让我以为是你写的,其实不是,我在意"),亲密关系是另一条线(Max 说如果朋友发来的私信是 AI 生成的,"那会是对信任的巨大侵犯")。Max 补充说,我们正处在为 AI 使用建立规范的关键期,这种公开羞辱和公共讨论之所以发生,是因为很多人强烈觉得 AI 被过度使用、被硬塞到脸上。但他也认为有些反应过火了,比如 Hank Green 那件事——这位 YouTube 创作者坦承在部分视频的资料准备中过度依赖了 AI,随后遭到网暴。Casey 说他欣慰地看到至少在自己的信息流里,为 Hank 辩护的人多得多,但那确实是一场真实的争议。Kevin 补充说社交媒体上人们总在找快速嘲讽和刷分的机会,"lol AI 生成"就是一种不需要动脑的嘲讽。
水印。 Anthropic 刚刚同意为其所有文本加水印以遵守欧盟 AI 法案。Max 认为这件事意义很大:它表明监管方和大实验室都真的在意 AI 的可检测性;把水印作为额外一层非常有帮助,能确认"这确实来自 AI",不必再纠结是不是那万分之一的误报。但水印有很多局限,那正是他打算让 Pangram 去补的缺口。
Kevin 承认自己不太理解文本水印到底是什么。Max 解释目前的 state-of-the-art 是 Google 的 SynthID:语言模型在选下一个 token 时会给不同 token 分配概率并据此采样,水印算法会以一种可以从文本中反向推出的方式扰动这个采样决策——检验时就看这些 token 是否符合"如果是我们生成的会怎样扰动"。
至于 Ben Thompson 在其 newsletter 里的强硬观点——因为欧盟监管而加水印会让 Claude 等模型的输出变差——Max 不这么认为。有两种做法:一种是优先保证水印强度,那确实可能劣化文本;另一种是只在可用熵范围内工作,如果这个 token 上打不了水印就不打,这样基本不会劣化输出。代码就是典型例子:代码讲究正确性,往往只有一个 token 可用,在水印机制下常常根本没有足够的熵让水印显形。
下一步。 Pangram 的 AI 图像检测已进入研究预览,Max 称其目前是 state-of-the-art,在几乎所有公开学术基准上领先。新一代前沿图像模型(如 GPT image)非常逼真,已经无法靠数手指或找乱码文字识别,所以模型必须在像素层面寻找生成模式固有的痕迹。视频检测据报道也在做。Casey 问是否会拓展到人类身份验证——比如那些在 Zoom 上被合成面孔诈骗的案例,Max 说这确实是一整个可以搭建的产品套件,第一步是造技术和核心模型,第二步是把它带到人们工作和上网的地方。
Kevin 追问是否会引入行为信号,比如有些学校用的工具能回放学生写作文的屏幕录制,看是一个词一个词写的还是一整块粘贴进来的。Max 说 Chrome 插件里已经有了:它能拉取 Google Doc 的修订历史,展示写作回放,看到哪里有大段粘贴,并可以直接对粘贴内容做 Pangram 检测,对教育工作者尤其好用。
最后 Kevin 问 Max 最得意的一次抓捕是什么。Max 的答案很妙:如果你让 ChatGPT 或 Claude 直接写出一串随机数(而不是写一个 Python 程序来生成),Pangram 能检测出这串随机数是 AI 写的——因为它们并不真的随机,是由 LLM 挑出来的,而 LLM 有固有偏好。"我们的训练集里根本没有这类文本,但 Pangram 似乎已经反向工程出了 ChatGPT 和 Claude 采样 token 的方式,足以看着这些数字说:这是 AI。"
八、Running the Numbers:黎曼猜想、Airtable 与韩国"芯片宅"
新栏目的第一期挑了三个和数字有关的故事。
理论数学。 周一传出消息:一位在 Anthropic 工作的非数学家 Jared Sumner 在黎曼猜想上取得了进展。Casey 曾预测 2026 年会有 AI 公司在千禧年大奖难题上取得突破。有意思的细节是,Jared 是在慢跑的时候做的这件事——他就是问 Claude"你要不要试试黎曼猜想",大约一天半以后,模型并没有解决或证明这个猜想,但在一个涉及 zeta 函数的旁支问题上取得了进展。而他的方法是不断告诉模型继续、要相信自己、不要放弃,基本上就是在给模型正面鼓励。Jared 公开的对话记录里有一句:"继续你在黎曼猜想上的工作。你需要对自己的能力有一次大的信念飞跃。你是迄今为止世界上最强大的大语言模型。你可以的。"
Casey 认为这件事重要在于:不久前人们还怀疑 AI 能否有意义地参与新知识的生产,而这感觉就是新知识的生产;"我猜这个还未发布的、能帮忙推进黎曼猜想的模型还能做很多别的事,有些好的,可能也有些吓人的。"Kevin 补充了必要的限定:这不是解决黎曼猜想,Anthropic 在宣传上也非常小心地说明了这一点。
SaaS 数学。 《华尔街日报》报道 Airtable 被 Bending Spoons 以远低于上一轮私募估值的价格收购。2021 年疫情远程办公 SaaS 狂热的顶点,Airtable 估值 117 亿美元;这次 Bending Spoons 拿下它的企业价值是 12.9 亿美元。Kevin 的判断是:不排除经营不善的因素,但更可能是那批在 2020 年代初变得极其值钱的企业软件公司的普遍处境——AI 正在侵蚀它们的利润率。这类软件不便宜,大公司的 Airtable 订阅相当昂贵,而过去一年里客户很可能想过"也许我可以自己做一个免费版本,把订阅砍掉",足够多的客户这么做就得到了这个结局。Casey 加了一句判词:"如果你的生意是一个花哨的电子表格,你会很难过。"两人还科普了 Bending Spoons 是一家七月初刚上市的意大利公司,专门收购"僵尸科技品牌",像私募股权一样从残余客户身上榨取最大价值——"如果你用的产品被 Bending Spoons 收购了,你有危险了。"
约会数学。 同样来自《华尔街日报》的一篇 A-hed 报道韩国的婚恋市场正被三星和 SK 海力士的高薪工程师主导,文章称这些突然抢手的单身汉为"chip nerds"(芯片宅),说他们和 AI 公司急需的存储芯片一样抢手。原因很直接:钱。有些人拿到的年度奖金高达 40 万到 50 万美元。报道里 26 岁的三星芯片工程师 Annie Quan 因为怀疑别人图她的钱,干脆和同为三星半导体部门的同事在一起,用她的话说这样是"双份收入";而在芯片行业之外做软件开发的 Rohi Jin,男友送了她一台约 450 美元的 Nintendo Switch 2,她得攒钱买一台迷你 PC 才能回礼。
两位主持人说这不只是韩国现象,旧金山也有——Kevin 说他听说 AI 行业的人在约会软件上收到的右滑明显变多,还听到过"Anthropic goggles"(Anthropic 滤镜)这个说法:"那个男生真的可爱,还是你只是戴了 Anthropic 滤镜?"Casey 作为 Anthropic 员工的未婚夫,对试图抢他男人的人表示欢迎挑战。他还爆了一个不那么好笑的行业八卦:一些早期或资深 AI 公司高管在暴富之后"换了人",现在约会的是模特和 OnlyFans 从业者。Kevin 感慨:"我们活在如此不可预测的时代,而这件事在我看来完全可以预测。"
金句
让每个人拥有对齐自身价值观的超级智能,在我看来有点像给每个人发一条龙。 —— Casey Newton 3:07
埋在这个非常积极、快乐的 AI 愿景里的,就是一串帮助 Meta 这门生意的政策请求。 —— Casey Newton 6:58
真正的危险,是一家以为自己在设计工具、实际上在设计超级智能的公司。 —— Kevin Roose 转述前 DeepMind 高管 12:20
就在当下这个时刻,我都不相信这帮人能替我排一个病毒式舞蹈视频的列表而不损害我的心理健康。 —— Casey Newton 13:52
AI 正向叙事不是通过宣言交付的,而是通过人类真实的体验交付的。 —— Casey Newton 17:45
这项技术远比拼写检查或打字机强大得多,它能认知——正因如此,我们人类需要在算法层面偏向人类。 —— Max Spiro 30:51
我希望我是昨天才出生的,那样我就能相信我读到的一切。但 Kevin,我知道得太多了。 —— Casey Newton 16:12
提到的书·产品·人物
- Mark Zuckerberg(人物):Meta CEO,本期主题《The Future Is For Everyone》6500 字 AI 宣言的作者,此前在《华尔街日报》发过短版。
- The Future Is For Everyone(文章):Zuckerberg 的 AI 宣言,主张给每个人一个契合其价值观的个人超级智能。
- House of the Dragon(电视剧):Casey 用其第三季大结局中"两派都有龙的血腥内战"类比 AI 能力扩散的风险。
- Meta Superintelligence Labs(部门):Meta 重组后的 AI 部门,重金招募研究员并采购算力,被认为是其模型近期改善的原因。
- Bending Spoons(公司):七月初上市的意大利公司,专收"僵尸科技品牌",以 12.9 亿美元企业价值收购 Airtable。
- Airtable(产品):被形容为"花哨的电子表格",2021 年估值 117 亿美元,被视为 AI 侵蚀企业软件的典型案例。
- Pangram Labs(公司):AI 文本检测公司,原名 Check for AI,提供 Chrome 插件与 Substack 集成。
- Max Spiro(人物):Pangram 联合创始人兼 CEO,前 Google 软件工程师、前 Nuro 员工,自称"slop janitor"。
- SynthID(技术):Google 的文本水印方案,通过扰动 token 采样决策实现,被 Max 视为当前 state-of-the-art。
- 欧盟 AI 法案(法规):促使 Anthropic 同意为其全部文本输出加水印。
- Alex Heath / Sources(人物·newsletter):公开表示借助 AI 写作,但在 Pangram 上始终显示为人类撰写,被举为漏报案例。
- Hank Green(人物):YouTube 创作者,坦承在视频资料准备中过度依赖 AI 后遭网暴,被 Max 视为反应过火的例子。
- Jared Sumner(人物):Anthropic 员工、非数学家,用 Claude 在黎曼猜想的一个 zeta 函数旁支问题上取得进展。
- 黎曼猜想(数学问题):千禧年大奖难题之一,本期讨论 AI 在其相关问题上的进展。
- Fruit Love Island(TikTok 节目):被举为"AI slop 也能获得数百万播放"的代表。
- Nintendo Switch 2(产品):韩国报道里三星工程师送给女友的约 450 美元礼物,成为"芯片宅"经济差距的注脚。
- Ben Thompson(人物):在其 newsletter 中主张水印会让模型输出变差,Max 对此表示不同意。
适合谁听
关心 AI 政策游说如何包装成愿景叙事、以及想弄清 AI 文本检测与水印技术底层原理的人。