核心要点
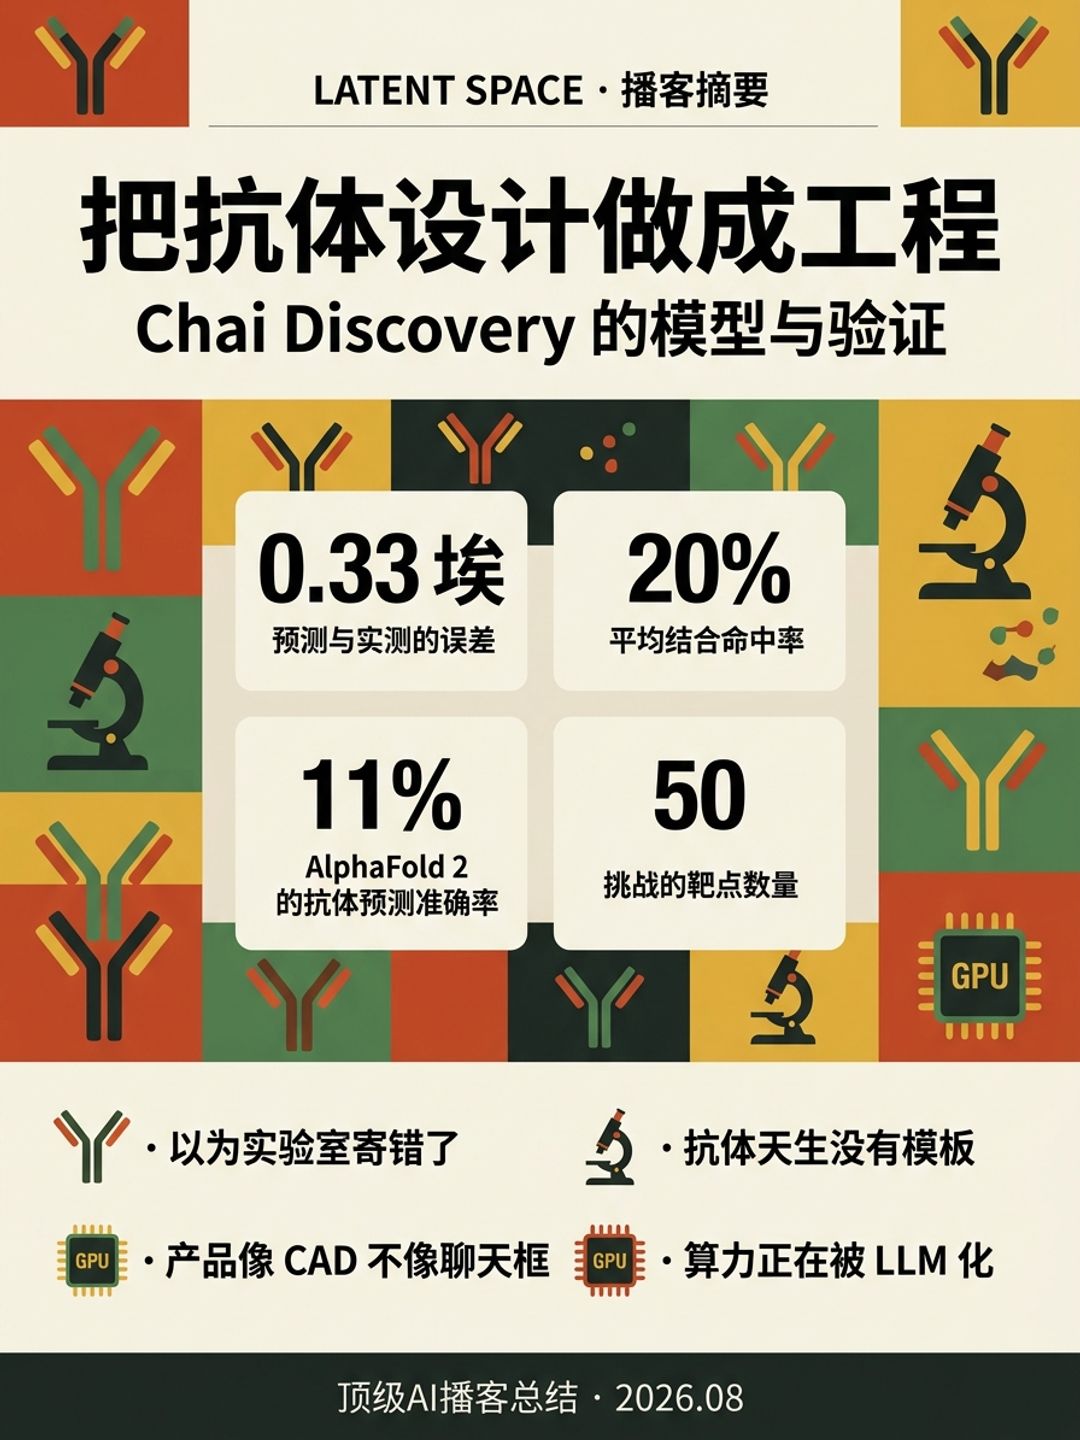
- 0.33 埃:Chai 2 论文里做冷冻电镜验证,把预测结构叠到实测电子云上看不出差别,误差 0.33 埃、约为一个原子直径的三分之一,团队第一反应是实验室把他们自己的设计原样寄回来了,确认过靶点无已知抗体、不存在数据泄漏。
- 50 个靶点:Chai 2 的公司级挑战是为 50 个靶点设计抗体,最终对其中约一半拿到 binder,平均结合命中率约 20%;正是这个数字让药企相信「这可能真的能用在我们的管线里」。
- AlphaFold 2 没解决:很多人以为结构预测已被解决,但 AlphaFold 2 multimer 在抗体-抗原预测上只做对约 11%,也就是九成情况是错的——因为抗体在进化上天生没有模板,MSA 这套魔法失效。
- 算力被 LLM 化:Neil 说 B300 这类新卡 95% 以上被超大规模厂商和头部 AI 实验室买走,且硬件是按 LLM 的 KV cache、72 卡互联形态设计的,蛋白模型的软件栈和产能都还没被市场认真对待。
- 产品不是聊天框:Chai 的设计套件更像 Autodesk、SolidWorks 或 Figma,装载分子后用「画笔」涂出表位、用类似内容感知填充的工具生成 binder,Neil 认为围模型做个 chatbot 才是最省事但最错的选择。
- 复杂度与苦涩教训对立:AlphaFold 3 大约有 23 个子模块,这种系统难以研究和优化;Chai 的工程文化是极端偏好简洁,办公室墙上挂着 SpaceX Raptor 1 和 Raptor 2 引擎的对比照,核心问题永远是「还能删掉什么」。
- Eroom 定律:制药是摩尔定律的反面——每款新药的研发投入呈指数上升,这保证了某个时点新药开发的边际回报会转负;两位嘉宾认为整个行业正处在把这条曲线掰弯的临界点。
章节时间轴
- 1:31 两位嘉宾的路径 — Matt 从理论计算机转 AI 生物、经历 AlphaFold 1 与 2;Neil 从 App Store 到自动驾驶到 Vanta 再到安全创业,最后被「原子挺酷的」吸引加入 Chai。
- 3:49 四家药企与商业模式 — 与 Eli Lilly、Pfizer、Novartis、Regeneron 的合作,以及 Chai 把自己定位为「制药的中立软件工厂」而非自研药企的原因。
- 5:21 为什么两年前敢下这个注 — 多聚体结构预测 2021 年才出现、逆折叠刚开始能用,通用模型尚不存在,Chai 赌的是模型会自己走到位。
- 8:28 抗体到底是什么 — Y 形蛋白、只有指尖参与结合、框架区高度保守,因此既是天然的可设计对象,也自带成药性优势。
- 13:02 传统方法有多笨 — 给老鼠打抗原、酵母展示,从数十亿分子里大海捞针,最后拿到一到十几个 hit,且完全不知道它们结合在哪。
- 14:35 选择性与交叉反应性 — 既要绑人的变体也要绑猴的变体以便做动物实验,同时必须避开高度相似的无害蛋白,这是一个组合约束问题。
- 17:39 Chai 1 与 AlphaFold 3 — 五个人时决定开源复现 AlphaFold 3,真实目的是把训练基础设施逼出来;顺带讲清了 MSA 为什么有效。
- 19:57 48 小时和 Bloomberg 采访 — 为抢发连续熬 48 小时上线网页服务,CEO Josh 直接从办公室冲进 Bloomberg TV 采访,记者说「这公司看着好像没有员工」。
- 23:00 模型长什么样 — tokenizer + 类语言模型 trunk + 类图像扩散模型,从原子到 token 再回到 3D 坐标;Chai 2 是全原子扩散设计模型。
- 29:12 自洽性指标怎么被玩坏 — 用独立结构预测模型做自洽性验证曾是行业共识,但如果所有设计长得一样就能刷高,于是又叠加了置信度校准和多样性指标。
- 33:46 以为模型坏了 — 冷冻电镜结果与预测重合到看不出差别,误差 0.33 埃,团队怀疑实验室寄错了东西。
- 35:19 为什么要有 Chai 3 — 面对 Chai 2 没搞定的另外 25 个靶点,团队在「研究失败案例」和「相信模型会变强」之间选了后者,中间还有 2.5、2.7 等版本。
- 38:25 产品与 IP 安全 — 药企不愿把数据放上平台的顾虑,用单租户隔离化解;设计套件为什么长得像 CAD 而不是聊天框。
- 43:46 一位科学家哭了 — 有位药企科学家花十年没拿到某靶点的初始 binder,看到 Chai 的结果当场落泪;以及内部第一位硬核实验科学家 Nathan Rollins 的怀疑与转变。
- 49:08 从瀑布流到循环 — 靶点发现、hit 发现、优化各设一道闸门的传统流程,正在被「模型直接给出高质量候选」压缩成一个类似敏捷开发的循环。
- 52:13 表位预测才是难题 — 主持人认为这比找 binder 更难,Matt 同意:需要的全局上下文太多,虚拟细胞可能是最接近的方向但还很远。
- 55:17 经济账怎么算得通 — 面对「你只省了五亿里的几百万」的质疑,两位回答是解锁新能力而非加速旧流程:GPCR 激动、双特异性、ADC 这些用免疫法根本做不出来。
- 61:25 买算力有多难 — 算力采购是一份「压力极大、不推荐」的工作,从去年九月的 spot 容量紧张讲到 B300 的 95% 被巨头买走。
- 66:03 持久化执行与 Temporal — 分布式模型调用中最耗人的是重试与队列,Chai 早期决定尽可能把一切跑在 Temporal 上,Neil 认为这才是生物走向工程学的真正瓶颈。
- 69:06 简洁性偏好 — AlphaFold 3 的 23 个子模块难以优化,triangle 层的归纳偏置有效但代价巨大且不适配现代 GPU;Chai 的做法是把每个问题映射回核心 ML 问题。
- 75:13 会不会被商品化 — 类比 LLM:开源模型很有用,但前沿闭源模型仍捕获大部分价值,因为更强的智能会去做更难的任务,而且产品层同样重要。
- 82:51 数据护城河之辩 — 主持人提出「AI 公司本质是咨询公司」,Neil 反驳无数据护城河的前提,并谈为合作方微调专属模型的现状。
- 83:36 GLP-1 与 Eroom 定律 — 两款 GLP-1 合计可能是万亿美元级资产,其总收入一度超过所有 AI 实验室之和;而制药成本呈指数上升,正是摩尔定律的反面。
- 86:41 人人都是资本配置者 — 30 人的公司如何思考研究即投资:把注意力和算力配置到正确的想法上,比堆人更重要。
- 89:42 想删掉的瓶颈 — Matt 选验证循环,希望能瞬间知道设计是否有效;Neil 选「人才的晦涩性」,希望更多聪明人愿意进入生物领域。
- 92:00 本期结论 — Neil:生物正在从摸黑试错跨过阈值,走向像软件、电路设计、CAD 那样的声明式精密工程;Matt:这个领域是真的在起效了。
详细内容
一家不做药的制药公司
Chai 的定位在这一集里被反复强调:他们不做自己的药。Neil 的原话是「我们把自己看作一个制造药物的中立软件工厂」。这在 AI for bio 这个赛道里是少数派——大部分同行都在自建管线、做自己的候选药物。
这个选择带来的是合作可能性。因为不与药企竞争,Chai 才能同时和 Eli Lilly、Pfizer、Novartis、Regeneron 合作。Matt 说 Chai 这家公司的存亡完全取决于合作伙伴是否成功,他个人非常喜欢这种激励对齐:模型变好 → 伙伴更成功 → 反馈回来让模型更好。
主持人追问得更直接:为什么是你们,而不是别的结构预测公司?Matt 的回答是时机与赌注。Chai 从第一天起的主张就是「只做软件和建模层」,这在两年前是有争议的——这套打法之前有人试过,但模型能力还不够。Chai 敢赌是因为看到了早期信号:CEO Josh 参与过 Meta 的 ESM 原始论文,看到了 scaling law 的苗头;Matt 自己在博士期间也看到了希望。
Matt 特别提到一个容易被忽略的时间点:直到 2021 年才有多聚体结构预测模型。「五年前我们才第一次能用深度学习预测两个蛋白同时的形状。」AlphaFold 1 是起点,AlphaFold 2 是巨大突破,但 AlphaFold 2 multimer 又晚了一年。而没有多聚体预测,设计根本无从谈起——你连「两个蛋白怎么结合」都预测不了。同一时期逆折叠(ProteinMPNN)开始在实验室里真的能用,Matt 特意向 Baker lab 的湿实验验证工作致敬。这几件事凑齐了,才是下注的时候。
抗体:为什么是这个赛道
主持人让两位先解释什么是抗体。Matt 用了经典的锁与钥匙比喻:靶点是那个疾病相关蛋白,是锁;你要设计一把插进去并且卡住的钥匙。抗体的特别之处在于它既非常通用,又在结构上非常统一。
Neil 补充了物理形态:抗体是 Y 形蛋白,像比出的 V 字手势,真正参与结合的只有「指尖」那部分,也就是 CDR loops。其余部分是高度保守的框架区,而且是你的免疫系统本来就认识的东西。所以设计问题被大幅简化——你只需要设计指尖,框架区可以直接选一个免疫系统熟悉的。这也顺带解释了为什么抗体的成药性(developability)「有很多是白送的」。
抗体能干的事远不止阻断。Neil 列举:ADC(抗体药物偶联物)——一端结合癌细胞、一端挂着毒性分子,实现精准投递;双特异性——两端各绑一个东西,强行制造邻近效应;以及最难的激动剂行为——历史上大部分药是在「堵住」什么,但如果能精确到某个 GPCR(Neil 称之为细胞膜上的「门铃蛋白」)的特定位置去戳它,就能触发下游反应链。
Matt 说,传统方法是怎么做的:往老鼠体内打入病原让它自己产生抗体,或者做超大规模酵母展示。后者意味着从至少数十亿个候选分子里针对一个靶点大海捞针,最后拿到一个、两个,运气好十几个 hit。而且你对这些 hit 一无所知——只知道它粘上去了,不知道粘在哪,也不知道它像不像一个药。Chai 的卖点正是这一点:你可以说「我要绑在这个区域」,事后还能回去验证抗体是不是真的按预期方式接触靶点。
交叉反应性与选择性:真正的临床约束
这一段是全集里最贴近工业现实的部分。Neil 举了个很具体的例子:药不会直接打进人体,通常先做猴子实验。猴子体内那个蛋白与人的版本大体相似但略有差异,所以你的药必须同时绑得住人的变体和猴的变体——这叫交叉反应性。做法是识别出两者之间保守的区域,然后专门瞄准那块。
反过来是选择性。人体内可能存在一个高度相似的蛋白,一旦误绑就是严重副作用。Neil 说很多药之所以失败、有毒性、或有很糟糕的副作用,根源就在这里。于是问题变成一个组合约束:只绑这些、只避开那些。
主持人指出,CAR-T 领域处理这个问题的方式是加信号通路逻辑门——只有 A 绑上且 B 没绑上才激发。而 Chai 的路线是直接设计一个只会绑目标的抗体。Neil 承认这有细微差别,但「在某些情况下现在真的可以试」。他还说,这次融的钱很大一部分就是为了训更大的模型,让模型能同时考虑更多约束条件。
Chai 1 的真实目的是基础设施
Chai 1 的故事被讲得很坦诚。公司成立头几个月在做蛋白设计,有些进展,然后 AlphaFold 3 发布了。团队当时正抱怨「我们真的很需要一条 MSA 流水线、需要这一整套基础设施」,于是决定:开源复现 AlphaFold 3。
主持人一针见血地问:所以你们表面上在做一个模型,实际上是在学怎么建基础设施?Matt 说完全正确。当时全公司五个人。Matt 在博士期间搭过类似的基础设施,但从没在公司里搭过生产级的。「这就是我们的强制函数,目标非常明确,看看能多快做出来。」他同时认为开源这件事长期一定回本,也是对社区的贡献。
这段时期他们坐在 OpenAI 的办公室里——两位联合创始人 Josh 和 Jack 与 OpenAI 的人有关系,OpenAI 联合领投了种子轮,而那个办公室当时大部分是空的,五个人就蹭进去了。
发布那天的故事很有画面感:模型快训完时才想起「要不要建个网页服务」,本来觉得不用,最后还是搭了——因为直接让生物学家去下载 git repo 太劝退,而他们真心希望有人用。于是连续 48 小时不睡,赶论文、赶网页服务的收尾。那天早上七点 Josh 要接受 Bloomberg TV 采访,冲进一个房间开始连线,办公室里所有人都在但不想被拍到,采访者说:「有意思的公司,看起来这儿好像一个员工都没有。」
模型结构:语言模型的躯干 + 图像扩散的输出
Matt 对 Chai 1 架构的描述很清晰:粗看就是一个 tokenizer、一个 transformer、一个类似图像扩散模型的东西缝在一起。
tokenizer 不是常规的文本 tokenizer——输入是分子里的一堆原子,需要把它们聚合成 token 喂给类语言模型的 trunk。生物数据本质是多模态的:有 token 序列表示,每个 token 挂着一组原子,每个原子还有电荷、元素类型等属性。全部打包成 token 后,中间的处理就非常标准了。但最终要回到 3D 坐标,这一步走的是图像扩散模型的形态:从 token 回到原子表示,「发射」出那个 3D 物体。
主持人复述确认:token 进去,transformer 建立 token 之间的关系,扩散模型把潜在表示变成 3D 结构。Matt:完全正确。
Chai 2 是全原子扩散模型,关键差异在于模型有能力设计原子、放置原子、决定哪些原子该存在——一个氨基酸就可以用「哪些原子在场」来表示,所以让模型自由选择保留哪些原子,再映射回氨基酸。
Chai 1 到 Chai 2 的能力跃迁,Neil 用图像模型打了个比方:Chai 1 是「这张图里有只猫,谢谢」;Chai 2 是「给你个背景,往田野里放只猫」,它真的生成一张猫在田野里的图。主持人把类比推进一步:更准确地说,它同时生成「有只猫」这件事和猫的图像,序列和结构必须同时被生成且互相自洽。
Matt 解释这个共设计过程:结构预测是序列→结构,逆折叠是结构→序列,现在两件事要同时做。扩散的好处是可以慢慢来、反复迭代——让模型花时间想「如果结构这样变,序列该怎么变」,来回拉扯直到收敛到自洽的解。主持人评论:这几乎就是 EM 算法。
怎么知道模型没在自欺欺人
这是全集方法论上最有价值的一段。设计问题的根本困难在于没有 ground truth:给你一个新的疾病分子,模型给出一个 binder,怎么判断它靠不靠谱?Matt 说,人看不出来,「连生物学家都说我不知道这东西会不会真的折叠起来」——甚至 Chai 自己的生物学家也常被那些真的有效的设计惊到。
当时的解法是自洽性(self-consistency):把你预测的序列丢进一个完全独立的结构预测方法(AlphaFold 就是让这套方法成为可能的东西),如果独立模型认为这个序列会折叠成相似的结构,那你的设计正确的概率就高于先验。
但主持人马上指出这个方法的漏洞——如果 oracle 和 sampler 同时被优化,最终会收敛到互相取悦。Matt 承认这个基准被刷了很久,而且「如果你所有的蛋白长得一模一样,很容易做到自洽」。
补救有两层。第一是置信度校准:结构预测模型能给出相当校准良好的置信度,不只说「我认为结构长这样」,还能说「这些部分我不太确定」,聚合成一个标量后可以看独立模型到底有多喜欢自己吐出的结构。第二是多样性:一个完美自洽、置信度极高的模型可能每次都给同一个结构、同一个序列,所以必须看解的多样性,看能解决多少不同的新问题。
主持人问:如果有很多钱去做验证呢,比如冷冻电镜?Matt 说问题不是钱,是反馈太慢——这样能验证几个结构,但可能要花几个月,不可扩展,是整个领域的问题。好消息是现在有一整个湿实验室网络能跑这些实验,从「年」压缩到了「周」。Neil 说这当然比不上 LLM 那边加算力几小时出结果,但已经快到足以开始递归自我改进。
「实验室把我们的设计原样寄回来了」
这是本集标题的来源。Chai 2 论文里他们真的做了冷冻电镜验证:把模型预测的蛋白拿去做实验测定,结果回来后,团队把预测结构叠到实测的电子云点云上——看不出任何差别。
第一反应是:结果肯定错了,实验室把我们自己的设计原样寄回来了。
实际误差是 0.33 埃,约为一个原子直径的三分之一。主持人立刻问了正确的问题:查数据泄漏了吗?Matt 说查了,而且这些靶点是专门挑的、没有任何已知抗体 binder——所以如果拿到 hit,那必然是该靶点的第一个抗体 hit。
Neil 借这段引出更大的判断:生物学的很多部分字面意义上是在黑暗中摸索,你根本看不见这些东西长什么样。结构模型的意义就在于把这个前提改掉了,而这才让 Chai 2 那样的设计模型成为可能。RJ 补充:这是 AI for science 的核心问题之一——你甚至不知道怎么度量你的问题,所以极难验证。
为什么还需要 Chai 3
Matt 说 Chai 2 之后其实有 2.5、有 2.7,每次都更好,最后才有 Chai 3。
真正的分歧发生在 Chai 2 之后的内部讨论:50 个靶点做成了一半,剩下 25 个怎么办?一派主张研究这些失败案例,看看它们有什么共同属性;另一派主张相信模型——投入更多时间,模型自己会走到。Matt 说他们坚决选了后者,「更 bitter lesson 一点」,然后往这个方向使尽全力。
关键指标是什么?Matt 说结合亲和力是大头——不能只是弱结合,要接近治疗级别,也就是绑得非常紧。同时还要有成药性。Neil 展开了成药性的非生物学解释:安全吗、稳定吗、好生产吗、会不会自聚集。Chai 2.5 就是专门做成药性研究的版本,他说团队对能爬到的性能感到惊喜。
主持人的观察是:市面上结构预测模型很多,真正决定产品有用性的其实是这些周边因素。两位都同意。Matt 补充了一个研究方法论上的偏好:结构预测有 ground truth 可比,是一个非常好的「速通式」基准,适合用来验证想法;而设计没有,只能送去实验室等着。
产品:不是 chatbot,是 CAD
Neil 说 Chai 2 之后药企主动找上门,团队才意识到必须做产品。同时要解决三件事:搭产品、抢算力、以及安全与 IP。
IP 这件事所有人都告诉他做不成——药企不可能把数据放上平台,让新药从别人的系统里长出来。Neil 的安全背景在这里派上用场:只要在数据隔离上足够激进,做到单租户(几乎是给每个客户部署一份独立的产品实例),平台是可以交付出去的。去年夏天开始,和 Eli Lilly 密切合作做出了设计套件的 V1。
产品形态的选择很有观点。Neil 说:模型很强,只要用正确的方式给它上下文和约束——比如「我要一个命中这个 GPCR 的抗体,但不能撞到细胞膜,还要针对这个特定表位」。「我们看了一眼,觉得也可以套个 chatbot,那会非常好聊,但你真正要建的其实是很视觉的东西。」
于是 Chai 的产品看起来不像 ChatGPT,更像 Autodesk、SolidWorks 或 Figma:装载分子,一个近乎 Photoshop 式的设计套件,有类似画笔的工具去涂出表位,有类似内容感知填充的工具去生成 binder,当然还有大量科学分析和绘图。Neil 说最让人意外的是,光是把这件事做对就有极高的复杂度——目的是让用户在给模型下指令时不至于搬石头砸自己的脚。
主持人问了个尖锐问题:药物化学家出了名地讨厌 AI 工具,不理解的东西他们不碰,你怎么说服他们?Neil 的答案很直接:靠模型真的好用。Chai 2 和 2.5 的结果本身就是足够的活化能,药企会说「你能不能拿我们几个靶点跑一下」,结果好了他们才愿意上产品。Matt 补充说药企其实极其务实,愿意被说服;而且他自己看到新模型发布时也很怀疑,「所以我一点也不怪他们不信任模型」。药企通常会给一个自己过去搞不定的靶点当试金石,一旦被证明,接受度压倒性地高。
Neil 拿这个和他的安全产品经历做对比:卖安全产品是「对着一群意外地不那么技术的客户做上坡的企业销售苦役」,而这里的客户是花了 5 年、10 年、20 年研究同一个靶点的科学家,极其成熟、极其聪明,合作本身就是一座金矿。
然后是全集最动人的一段:几个月前他们向某个药企合作方展示某靶点的结果,房间里一位科学家开始流泪。团队问怎么了,她说——我花了十年想拿到这东西的第一个 binder,你们帮我做到了。
内部的怀疑论者与验证文化
Chai 早期几乎全是工程师和有 AI 生物经验的人,没有硬核实验科学家。第一批相关招聘之一是 Nathan Rollins:14 岁开始在 Baker lab 工作,18 岁从哈佛毕业,21 岁左右在 Marks lab 拿到博士。
Nathan 一开始对 Chai 非常怀疑。结果陆续出来后他说「这有点意思,可能真的行」。等 Chai 2 的结果回来,他的反应是「我要把这东西打成防弹的,谁都先别庆祝」。Matt 说这种严格性正是他们需要的——团队里有人真正在实验室待过、亲手设计过蛋白,还有像 Andy 那样带过多个治疗项目、把药推进过临床的人,他们在公司内部把产品往死里测。
主持人由此问出一个结构性问题:你们没有自己的管线,怎么持续压力测试?Neil 的回答是内部基准集:一组有已知治疗药物的靶点,一组专门挑来为难自己的靶点,内部科学团队负责持续扩充这个集合、真的跑实验去拿初始 binder。「我们不在乎把这些开发成药,我们做这些只是为了验证并改进模型。」
从瀑布流到循环
主持人问 Chai 到底站在 hit discovery 还是 hit-to-lead、lead optimization 的哪一段——后面这些阶段通常更定制化、更难通用。
Matt 的回答是他们刻意不做这个区分。之所以历史上有这些阶段,是因为初始分子通常离药太远。而现在正处在拐点上:模型给出的分子已经很接近药了。Chai 的北极星是让模型直接产出类药分子。当然会很难,需要能 prompt 模型、需要整套 RL 栈去学习不同属性,但 Matt 认为非常可行。
Neil 把这个讲成流程形态的转变:靶点发现、hit 发现、优化各设一道闸门、各花几个月到几年,这是典型的瀑布模型,早期试错成本极高。一旦模型能给出真正靠谱的候选,整件事就更像一个循环——「就像软件开发变得敏捷」。
他说 Chai 内部有两个北极星,乍看矛盾:研究侧要 de novo 一次成型出越来越接近临床的候选;产品侧要支持迭代工作流——拿到 binder、拿到实验结果、用它来 condition 下一次模型运行。他认为不矛盾,因为这是一个抽象层级不断上升的过程:先在某类药(比如相对容易的拮抗剂)上做到一次成型,然后下一个问题就是激动剂——如何可靠地一次命中细胞上的某个开关,再往下是双特异性、ADC。
Neil 讲了一段关于产品寿命的存在主义焦虑:几个月前他意识到,现在为可视化分子做的这一切,等 Matt 发布 Chai 4 的时候可能全部要扔掉。「但我想这就是现在做产品的现实。你越来越少地把产品当作目的本身。以前你可能造一个能用二十年的软件,现在也许只能活一年,但它是交付价值、支撑研究走到下一步的桥梁。」他预计产品会在越来越高的抽象层上被重写:现在像 Cursor,你还需要检视分子就像检视代码;之后产品会变成帮你编排一整批假设、编排针对一个靶点的多个表位选择;再往上是针对某条通路里所有靶点的整个 campaign。「如果结构预测、结合、设计这些原语足够好并且可以组合,你就能长进科学的外层循环里。」
表位预测:更难的那个问题
主持人明确提出,业内很多人会认为表位预测比找抗体、找 binder 难得多。
Matt 分层拆解:最基础一层是搞清楚某个疾病里到底哪些蛋白负责,也就是生物学上该瞄准什么;确定之后就变成结构生物学问题——这组蛋白在和不该相互作用的东西相互作用,你想阻断这个相互作用,那个作用位点就是表位。他直接承认:「这是个难到离谱的问题,我同意你,这是更难的那个问题。」原因是需要的上下文和全局理解量太大。
主持人举了具体场景:来了新的 SARS 变种或新流感怎么办?Matt 说那种情况下可以跑结构预测模型看它认为会结合在哪,如果置信度高就可以定为要阻断的位点。但一般情况仍然很难。
他顺带纠正了一个流行误解:很多人以为 AlphaFold 2 解决了结构预测,其实没有——multimer 版本在抗体-抗原预测上大约只做对 11%,意味着九成情况是错的。主持人补充了原因:AlphaFold 2 解决的是有 MSA 的一类单体蛋白,而 MSA 才是让它奏效的魔法,它相当于一个关于结构应该长什么样的模板;但抗体在进化上根本不可能有模板——每个人的抗体都是根据自己一生遭遇过的东西定制的。RJ 进一步为听众澄清:抗体的整个设计目的就是识别身体从未遇到过的东西,靠快速重组不同组件去匹配未知病原,所以它天生不像其他蛋白那样在进化中被保守下来。
Matt 的结论:如果要为一个全新靶点发现表位,仍然是非常困难的问题,虚拟细胞可能是最接近的方向,但还很远。
经济账:几百万 vs 五亿
主持人抛出了全集最尖锐的质疑。开发一个抗体大概几百万美元;而如果你有先见之明选对靶点选对技术,把一款药推到上市大概是五亿美元(那个常被引用的 26 亿美元是把所有失败摊进去的数字)。「所以你是在一个五亿美元的战役里省下了几百万。为什么这件事这么值钱?」
Neil 从前提上反驳。如果只是给一个简单靶点找抗体,也许确实如此。但 Chai 最兴奋的是合作方在用抗体做更复杂的事——比如 Chai 2 展示的 GPCR 激动活性,真的能精确按下细胞表面那个「门铃蛋白」的开关。「如果你没法这么精确,用抗体做这件事非常非常难。」所以这不是把现有的药做得更快,而是解锁新能力,去打更精确、更有效的靶点。
Matt 补充了更硬的论证:有些药物模态根本没法用免疫法发现。多特异性、带弹头的复杂格式,必须从第一性原理设计出来。就拿双特异性来说,两条臂要各自结合不同靶点——命中率是相乘的。「如果一条臂找到 binder 的概率是十亿分之一,另一条臂也是十亿分之一,那传统方法根本不可能奏效。」
Neil 的第三个论点是平台的规模效应:你帮的不是一款药,而是合作方整个靶点组合;平台模式能随着他们追求更多、更有野心的靶点一起放大。主持人总结:这让你把学习集中在一个子领域,所有人都受益。
Neil 把它上升到公司使命:「把药物发现从科学实验变成工程学科」——走到精密工程阶段,你几乎可以声明式地定义你想要什么,让模型填补空白。
从科学到工程,卡在哪
主持人问:从科学变成工程,最大的障碍是什么?
Matt 先说了一堆脏活。生物学家的文件格式——「他们就是不在乎」,标准格式是有的,好不好用不知道,但要塞进去的信息很多:结构是谁解的、用什么方法解的。而且取决于测定方法,你可能拿到同一个结构的多个副本,某些部分可能没解析出来,或者「可能在这也可能在那,我两个选项都给你」。所以光是解析这类数据在工程上就极其困难。
主持人说这听起来正是 LLM 擅长的。Matt 的回应有意思:LLM 确实很强,但真正的问题是简洁性取向——「这个函数到底该有 20 个特例,还是我们应该在方法上更有主见(opinionated)?」他们要的是人类读代码时能搞懂的策略。
再往上是模型规模化和基础设施规模化。Neil 说他的答案就是基础设施,尤其是算力。他负责为公司买算力,评价是「最糟糕的工作,我不推荐,压力极大」。去年九月他们开始发现形势吃紧:当时推理跑在 spot 和按需市场上,隔三差五遇到容量紧缩,于是决定自己买。
他说自己没意识到这是多强的幂律:比如全球出货一万台 B300,超大规模厂商和最大的 AI 实验室买走 95% 以上,创业公司在剩下的残渣里抢。更有意思的是这些新一代硬件(Vera Rubin、B300)是高度为 LLM 设计的——巨大的 KV cache、72 张 GPU 全互联。有些性能提升当然也惠及他们,但整个算力市场「被 LLM 化」了,无论是产能还是软件栈。「我认为这一类模型会和 LLM 一样大、一样有影响力,但算力市场好像还没意识到。」所以 Chai 花大量时间做基础的算力优化,让硬件更适配自己的模型类型。
三角注意力的账与持久化执行
RJ 追问了具体的优化。Matt 以 Chai 1 这类遵循 AlphaFold 2/3 架构的模型为例:注意力不是作用在正常的序列表示上,而是松散地作用在「配对表示」上——可以理解为长度 L² 而非 L 的序列。做注意力时按实际批处理方式算下来是 L³。这是非常重的计算区间:每个 token 投入的浮点运算很高,而把这些数据从 SRAM 搬来搬去的内存带宽开销是真正的瓶颈——「哪怕像 layer norm 这么简单的操作都可能占掉相当可观的计算时间。」
后面他还补了一层:triangle 层不仅算力昂贵,而且在现代 GPU 上根本不高效——隐藏维度小、序列维度大,正好是 GPU 设计意图的反面。他给了一个心智模型:triangle 层本质是拿参数换计算——因为你没法把巨大的配对表示存下来还做正常注意力,所以选择多投计算、少存参数。
Neil 接着讲编排层。设计一个分子不是一次调用,而是跨大量算力的一堆 GPU 协同。他认为软件工程里最难做对的事之一是「持久化执行」(durable execution):当你在很宽的基础设施上跑大量数据和模型调用,总会遇到某处不稳定——取数据的存储桶挂了、数据库因事务太多打嗝、GPU 报错。他在以前的公司见过团队把时间全花在这上面:加队列、加重试、用胶带粘在一起,最后一个本该简单的分布式计算,95% 以上的时间花在排队和重试逻辑上。
Chai 早期的一个关键技术决定是尽可能把一切跑在 Temporal 上——数据库调用的副作用、模型调用、超长数据流水线的编排,都交给它智能重试,不用自己写队列逻辑。「刚融了 4 亿美元,我又要去买一个算力集群,我们会有非常非常大的训练和推理任务。把这些地基打对,才是让我们能做更有野心的事的原因。」他给主持人问题的正式答案是:让生物学更像工程学的瓶颈,就是有没有正确的工程原语。
Matt 补了一句模型侧的类比:基础设施的问题好在非常可见——崩了就是崩了,或者 loss 曲线不下降、梯度行为诡异。而工程优先这套原则同样适用于研究团队。他的表述是:「复杂度和 bitter lesson 从根本上是对立的。」AlphaFold 3 大概有 23 个子模块,这么大的系统极难优化和研究——改了第 21 个模块,整个系统会怎样?你总能想「加个第 24 个模块就更好了」,但也许该想的是删东西、把复杂度降下去。Chai 的工程文化极端偏好简洁,办公室墙上挂着 SpaceX Raptor 1(一堆管子)和 Raptor 2 的对比照,核心问题永远是「怎么删掉更多东西」。
RJ 提出了一个重要的反面观点:AlphaFold 2 和 3 之所以有效,恰恰因为它们是相对小的模型——计算密集但数据效率极高,靠的是一层层由人类直觉和惨痛经验带来的归纳偏置。「它们不是纸牌屋,每一样都是在上一样之上的增量改进。」要超越它们,你需要新的数据来源,或者从根本上以更高效的方式对待数据。
Matt 的回答是 Chai 的方法论核心:「我们是相当第一性原理的人。整个研究团队,除了我和 Kevin,几乎没人有所谓的生物背景,连我们俩也离得挺远。所以我们试着把每个问题都看成核心 ML 问题,想它在别的领域的类比是什么。」他举了 CNN 的例子:CNN 是为处理图像而生的,图像该按 patch 看,这是很好的归纳偏置;后来人们发现直接 tokenize 丢进 transformer 也能work,即使数据集相对小。但蛋白质很难——结构数据远没有那么多,序列数据倒是海量(这是 ESM 能跑通的关键),可你要拿实验结构数据做同样的事,「祝你好运」。RJ 提到 Apple 那篇在 distillation 数据集上蒸馏折叠的论文:确实能拿到不错的信号,但完全不泛化,因为它不是在推理而是在模式匹配。他认为 triangle 层确实带来了一个干净的归纳偏置——也许不是论文最初宣称的三角不等式那套解释,但它无疑是让整件事奏效的因素之一,只是代价巨大。Matt 同意:可以从 AlphaFold 的想法里抽象出一些基本的东西,然后按自己的方式微调、往上建。
会不会被商品化
主持人指出蛋白设计已经是个相当拥挤的赛道,大概有十到十五家创业公司,并回忆了几年前 NeurIPS 上的场景:RF diffusion 刚出来,Baker lab 的人说「我一发就中了皮摩尔级的 binder,直接丢去做冷冻电镜」——但这显然没有解决整个问题。他问:迷你蛋白、纳米抗体、抗体,难度依次上升,其中某些层次会不会被商品化?
Neil 的回答是「以上皆是」。某些模态或药物类型大概率会有一个商品层,同时整个行业会去做越来越有野心的药。他直接类比 LLM:开源模型对某些事情很通用很有用,但人们仍然在买前沿模型,而且如果看价值捕获,捕获大头的是闭源前沿模型——整块饼在长大,长得如此之快,以至于即便开源份额在扩张,前沿模型仍然拿走大部分价值。
原因有二。一是更强的智能会让你去做更难的任务:「如果我们有更聪明的生物模型,我们就会去做更疯狂的生物任务。」二是产品层:「我不用开源模型的一大原因是我拿不到 Claude Code,拿不到 Claude。我认为有一个产品层要建,它和模型层一样重要。」Chai 从合作方和内部人员那里学到大量东西——有些是最蠢的需求(「我想更好地可视化这一块」),有些是必须做出相当垂直的产品才能满足的复杂需求。「也许在时间的尽头 AGI 能一次性解决一切,但离那还有相当长的时间。」
Matt 的答案更偏模型:生物学是慢的,标注数据不多。你可以拿公开的全部序列信息训一个不错的基础模型,但你仍然需要在这些数据上有测量值,那依然非常耗时,然后还要迭代。「如果真想做零样本设计、直接生成几乎可以进临床的分子,数据本身就是阻塞点。AGI 未必能马上解决这个,那里确实有技术障碍。」
数据护城河与「AI 公司都是咨询公司」
主持人提出:Chai 押的两件事是全能产品,以及不做自己的管线——但这样就没有自己的数据护城河,这会成为阻碍吗?
Matt 说 Chai 确实没有做自己管线的计划,合作模式他们很认真对待,而且他个人喜欢这种激励对齐。这个模式带来的独特之处是能和很多人合作,并拿到真实反馈——知道产品真的在大药企手里跑真实 campaign。代价是压力:研究团队必须持续交付更好的版本。他的整体判断是:如果你是相信 bitter lesson 的人,会走到某个点上,模型侧和数据侧都还有很多事可做,「说我们不再需要数据是愚蠢的,说模型已经到头了也是愚蠢的」,两边都有大量空间。
Neil 直接反驳「没有数据护城河」这个前提:「这就好比说,所有和 Anthropic 合作的企业都不让 Anthropic 拿数据训练,所以 Anthropic 造不出擅长企业工作流的模型。」一方面 Chai 在投资数据,有办法把算力转化成数据;另一方面关键是你想要什么样的数据——和这么多合作方紧密工作,让他们能了解研究上真正有用的是什么,从而做有信息指导的研究,而不是在真空里基于「假设很酷」去做研究。
主持人接着问:你们应该不被允许用合作方的数据训通用模型,那是不是有专门的 Regeneron 模型、Pfizer 模型?Neil 说这些交易都是公开的,确实包括为他们训练或微调一个版本的模型,而且这块未来还有很大空间。他提到自己的兄弟创办了 Applied Compute,正在为 LLM 做类似的事——帮企业理解自己语言数据的价值并用于专门任务;他认为生物数据完全可能有对应的一整个世界。
至于合作方数据的价值来自哪里,Neil 说是特化:他们有大量来自实验的科学数据,能帮模型在他们关心的特定候选类别或靶点上做得更好。Matt 补充了一个更朴素的层面:他们可能就是有某种偏好的做事方式,不是 Chai 模型的原生行为——比如「我们的设计需要有属性 X,你能保证吗」——这种简单的事对他们影响其实很大。
主持人由此抛出自己的「宠物假说」:所有 AI 公司,尤其是生物和科学类的,本质上都是咨询公司;制药尤其如此,因为新药按定义就是新的,除非你在重复旧东西,否则总要定制。Neil 的回应是:Chai 的目标是让模型通用、产品通用、能力强大,但每个客户确实都有整合工作——而这本身就带来一定的防御性;更重要的是建立可信任的关系,「如果我们在第一年执行得非常好,他们会继续和 Chai 做更多、更有野心的药」。主持人笑说:那时候要换供应商就很难了。
每个 token 的下游价值
Matt 给了一个很有冲击力的框架:按 token 计价来看,「我不知道还有哪个领域,一个 token 的下游价值有制药这么高」。真正产出的药可以是数十亿美元级的资产。以 GLP-1 为例,两款 GLP-1 药物合计可能是万亿美元级的资产。Neil 补充:直到大约三个月前,GLP-1 的总收入还超过所有 AI 实验室加起来的总和——「我不觉得人们意识到了这件事」,而相对而言市值却低得离谱。
Neil 还说他没意识到制药本质上有多像 VC 生意——它们在下非常有野心的赌注。他提到硅谷史上的一个事实:八十年代最大的风险投资成果之一、也是最早的成果之一,是 Genentech。正因为是 VC 模式,一串 token 才能在下游带来那么大的价值。(两位顺带推荐了 Outposting 关于金融与融资的博客系列。)
Matt 引出 Eroom 定律——Moore 反过来拼写。算力遵循漂亮的指数式对数线性下降,制药几乎完全相反:单款药的成本呈指数上升。RJ 指出这保证了在某个时点,新药开发的边际回报会转负。Matt 认为他们可能正处在把这条曲线掰弯的临界点上。
最后是一个把制药与 VC 连起来的观察:两者本质都是在优化一个投资组合。Neil 说把药企理解成「成熟的资本配置者」——手里有一组靶点,在它们之间做配置——是他认知上的一次重大重构;他希望药企能像 VC 一样去下更冒险的注、追更酷的靶点。
三十个人的公司如何思考「配置」
Matt 说这个投资者式的模型也是 Chai 内部思考研究的方式。他们的研究团队相对小——「大概十个人左右」,比起 Isomorphic 或 DeepMind 那类要小得多。「所以我们几乎把它当成一份投资工作:你在把算力投向想法。从这个意义上说,你就是资本配置者。」
Neil 把这个推得更广:让人意外的是 Chai 总共只有 30 人,原因是每个招进研究或工程团队的人,尤其在 AI 加持之下,工作的很大一部分就是把自己的注意力配置到正确的想法上、把算力配置出去。
RJ 提出一个区分:如果你在给一家 B2B SaaS 公司写 API,你的约束几乎完全是人;而如果你在做硬件、AI 模型、科学项目,你的约束是实验室、是算力,所以必须有「我只有有限的射门机会,怎么分配」的心态。
Neil 部分同意但补了一刀:那个 API 也有增量成本——你要支持它,它给产品增加复杂度,还要拿去做市场和销售。也许你本该把这份投入配置到路线图上另一个赌注上。「在一个建造东西越来越便宜、趋近于免费的世界里,稀缺的是注意力——你自己能投入以保持产品简洁可成长的注意力,以及你的客户能投入去真正学会用它的注意力。」他的结论是:工程师都在变得更像配置者。RJ 说:那就是高管在做的事,我们都在变成高管。Neil 引用了 Satya Nadella 的说法——微软想让每个人都成为「无限心智的管理者」;「我确实觉得自己像个高管,而且我每天都在和 Claude 说话。」
如果能删掉一个瓶颈
Matt 选的是蛋白设计的验证循环:希望能瞬间知道这东西行不行。「还是有相当多在黑暗中摸索的成分。」主持人和 RJ 都同意这是未解决问题,而且价值巨大。
Neil 给了一个更抽象的答案:talent obscurity(人才的晦涩性)。很多聪明人去做 LLM、去做 SaaS 的软件工程,但去做生物的聪明人没那么多。「我高中时没做生物,因为我可以拿起电脑写 app;而想做生物就得去上学、拿好成绩、也许还要读个博士。」另一个原因是这个领域太晦涩——这一集就抛出了大量术语,而且你看不见那些东西。Chai 因此非常在意如何在官网和产品里把整件事变得可视化。他关心人才在经济中的流向:九十年代人才涌向某处,2000 年后涌向科技,大厂吃掉大量人才,最近几年是 LLM 和大 AI 实验室在吸走好人才。「怎么在元层面上更好地配置人才?私心上我希望更多人才进入生物,但我们大概也需要更多人才进入制造业和物理世界的问题。」
最想让听众带走什么
Neil 的结论是形态转变:生物一直是个让人摸黑前行的领域——不知道自己在看什么、实验带着非确定性、试错循环极长。但当折叠模型的误差进到一个埃以内、设计模型的命中率超过 50%(意味着一块 96 孔板里能有 48 个有意思的 binder)时,你就跨过了那个阈值:可以声明式地精密工程你想要的东西,而不是押注自然或试错。「软件里发生过同样的事——你写代码就能确定性地得到结果;电气工程里也是,你不再手画原理图,而是丢进 Cadence 的设计系统,然后它就被做出来了;机械工程里的 CAD 也是。同样的事正在生物里发生,而且发生得非常快。」他补充说,这也让像他这样的软件工程师、像 Matt 这样的研究者能进来——专家当然还需要,但通才常常能真正加速这个领域的精密工程化。
Matt 的结论更简单:这个领域是真的在起效了。「不只是有商业牵引,研究上真的出现了生命迹象——甚至不只是迹象,迹象已经被展示完了。我们现在真的处在模型能用、在交付价值、同时还有大量有趣研究问题的位置。」他认为这个领域的低垂果实比其他领域多得多,作为研究者能产生的影响无与伦比。「我们都是使命驱动的,但就算你不是,这里也有一堆好玩的谜题:3D 几何、扩散模型、Chai 1 里那个类 LLM 的躯干,核心机器学习的绝大部分都被这些问题触及。」
金句
我们不给自己做药。我们把自己看作一个制造药物的中立软件工厂。 —— Neil Patel 4:35
结果看起来是错的,因为我们把预测叠在电子云上,根本看不出任何差别……很明显是他们把我们自己的设计原样寄回来了。 —— Neil Patel / Matt McPartlon 34:33
AlphaFold 2 的多聚体版本在抗体-抗原预测上只做对了大约 11%,也就是说九成情况下它是错的。 —— Matt McPartlon 53:45
复杂度和相信 bitter lesson,这两件事从根本上是对立的。 —— Matt McPartlon 69:06
我不知道还有哪个领域,一个 token 的下游价值有制药这么高。 —— Matt McPartlon 83:36
我确实觉得自己像个高管,而且我每天都在和 Claude 说话。 —— Neil Patel 88:57
提到的书·产品·人物
- Chai Discovery(公司):本期主角,成立两年半、30 人的蛋白设计公司,只做模型与软件层,不自研药物。
- Chai 1 / Chai 2 / Chai 2.5 / Chai 3(模型):分别是开源结构预测模型、全原子扩散设计模型、成药性优化版本、以及最新一代设计模型。
- AlphaFold 1 / 2 / 3(模型):结构预测的三代里程碑;AlphaFold 3 的发布直接促使 Chai 决定开源复现并借此搭建基础设施。
- ESM(模型):Meta 的蛋白语言模型,Chai CEO Josh 参与了原始论文,是他看到 scaling law 苗头的来源。
- RF diffusion(模型):Baker lab 的蛋白设计模型,主持人回忆几年前有人用它一次就拿到皮摩尔级 binder。
- ProteinMPNN / 逆折叠(方法):Matt 提到的、在实验室里真正能用的逆折叠方法,是设计可行性的前置条件。
- Eli Lilly / Pfizer / Novartis / Regeneron(公司):Chai 的四家大药企合作方。
- OpenAI(公司):联合领投 Chai 种子轮,早期五人团队曾借用其位于 Mission 的办公室。
- Anthropic / Claude / Claude Code(公司/产品):被用来讨论算力挤占与产品层价值;Neil 说自己每天都在和 Claude 对话。
- Temporal(产品):持久化执行框架,Chai 早期决定把尽可能多的工作跑在其上,以避免陷入重试与队列地狱。
- Vanta(公司):Neil 早期加入的 SaaS 安全公司,他是最早的员工之一。
- Applied Compute(公司):Neil 兄弟创办的公司,为 LLM 做企业数据的专门化训练。
- Genentech(公司):八十年代最早也是最大的风险投资成果之一,用来说明制药本质上的 VC 属性。
- Nathan Rollins(人物):Chai 早期的硬核实验科学家,14 岁进 Baker lab、18 岁哈佛毕业、21 岁拿到博士,最初对 Chai 极度怀疑。
- Josh / Jack / Kevin / Andy(人物):Chai 的 CEO 与联合创始人、研究团队成员、以及带过多个临床项目的资深科学家。
- Satya Nadella(人物):Neil 引用其「让每个人都成为无限心智的管理者」的说法。
- Eroom 定律(概念):Moore 反写,指制药单款药成本呈指数上升的规律。
- GLP-1(药物):两款合计可能是万亿美元级资产,其总收入一度超过所有 AI 实验室之和。
- Outposting(博客):关于金融与融资的博客系列,两位嘉宾都推荐。
- Autodesk / SolidWorks / Figma / Photoshop / Cursor / Cadence(产品):用来描述 Chai 设计套件的形态与产品抽象层级的演进方向。
- SpaceX Raptor 1 / Raptor 2(产品):两代引擎的对比照挂在 Chai 办公室墙上,象征「不断删东西」的工程文化。
适合谁听
想理解 AI 蛋白设计到底走到哪一步、以及一家 30 人公司如何在算力、验证、产品和药企合作之间做取舍的 AI 与生物从业者。