核心要点
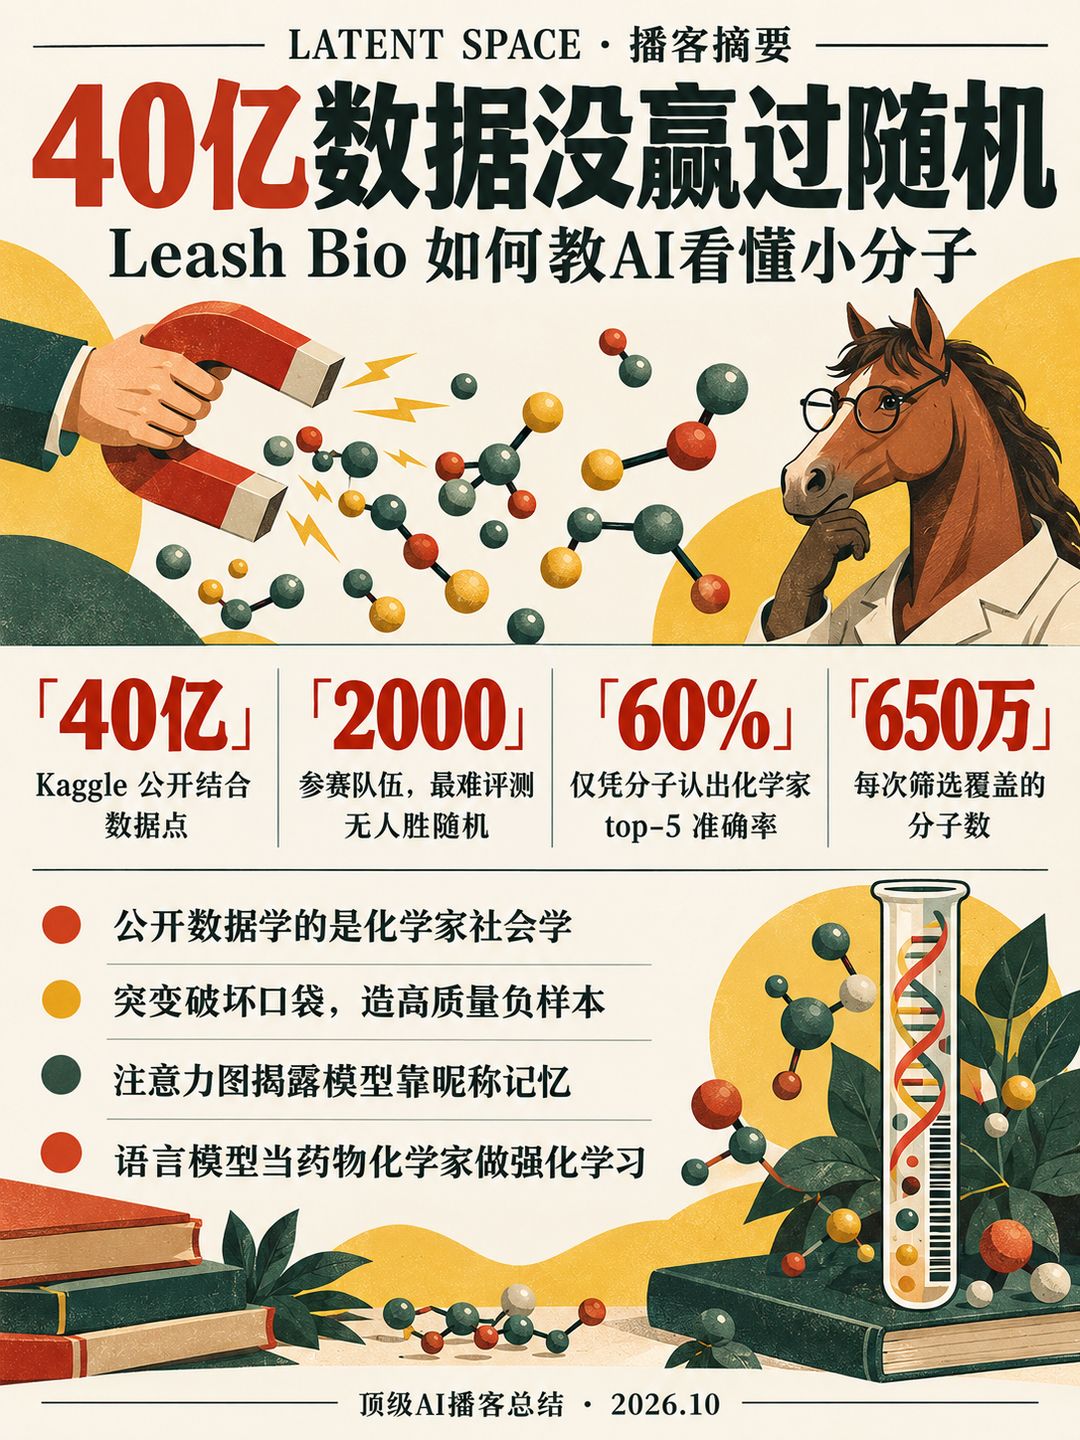
- Kaggle 无人胜出:Leash 放出约40亿条结合数据,2000支队伍参赛,在完全不同化学库的最难评测上无人优于随机;前五中三个是教程 notebook,说明模型靠记忆而非物理。
- 化学家社会学:在 ChEMBL 上用1815位化学家训练分类器,仅凭分子预测作者 top-5 准确率达60%;用"作者概率向量"预测活性,效果不逊化学结构,公开数据学到的是制作者指纹。
- 自建数据:Leash 只用内部数据训练,再去预测外部分子,规避公开数据泄漏。累计约2000个蛋白构建、约5000次筛选,每次覆盖至少650万分子。
- 突变破坏口袋:对结合位点氨基酸做定点突变后重筛,被竞争剂挤出的化学系列同样消失,其他结合不变,由此得到高质量负样本;而现有共折叠模型口袋被破坏后仍把分子硬塞回原位。
- 注意力显形作弊:Hermes 的交叉注意力不看口袋,而是盯住10~12个非保守氨基酸给蛋白起"昵称"来记忆;加入突变数据后,注意力变得均匀。
- LLM 当化学家:用开源 Qwen、GLM 等模型,给10个结合者与10个非结合者、100分子预算,在650万分子库中查表做多步强化学习,上周跑出1万多个 SAR 轨迹。
- 护城河在工艺:批次效应、蛋白折叠质量、DEL 噪声都要长期追踪;有项目6个月从库内命中做到小鼠药代药效,Ian 认为护城河是文化与耐心。
章节时间轴
- 0:00 开场:认出化学家的分子 — 在 Recursion 一位药物化学家路过就说出分子是谁做的,埋下"模型也许只学到作者"的疑问。
- 2:18 什么是 DNA 编码库 — 每个小分子挂 DNA 条形码,混在一管里用磁珠上的蛋白"钓鱼",再测序读出,库可达 40 万亿分子。
- 9:16 假阳性与条形码设计 — 同一分子用32或48个不同条形码编码,识别 DNA 结合蛋白造成的假阳性,复现性很好。
- 15:25 为什么 DEL 令人"创伤" — 传统用法只为单一难靶点追求大库;Leash 反过来对数百蛋白筛同一库,从而刻画库的怪癖。
- 27:01 Kaggle 竞赛 — 约1.3亿分子库、三层难度的评测设计,2000支队伍,最难集无人胜过随机,SMILES 反而最好。
- 40:45 Hermes 模型 — ESM 蛋白嵌入加 SMILES 嵌入,交叉注意力预测二分类;构件块聚类切分,XGBoost 随距离下降而 Hermes 较稳。
- 46:08 Clever Hans 与 ChEMBL — 1815位化学家、top-5 60%;分子量排序也是极强预测器,说明数据反映人的选择。
- 55:17 只用内部数据训练并对标 Boltz — 在外部数据约1300万次测试上与 Boltz 相当,BRD4 例子显示 Boltz 看过晶体结构。
- 59:07 活性悬崖与突变筛选 — 破坏口袋后现有共折叠模型仍把分子塞进原位,Leash 用竞争剂加突变获得负样本。
- 71:24 注意力图与"昵称"问题 — Hermes 记忆非保守短片段,加突变后注意力趋于均匀。
- 76:02 LLM 与强化学习 — 用可读英文描述分子差异,在650万分子库上做查表式 rollout。
- 85:56 刁钻问题环节 — DEL 局限、ADMET、商业模式、护城河、KD 预测、折叠错误的"Lumacaftor 信号"。
详细内容
一、DEL:把"拍照"换成测序
Ian 的说法是,生命科学里真正可规模化的读数只有两种:拍照和测序,而测序本质上也是拍照。DEL 把每个小分子挂上 DNA 条形码,一管里混合数百万到数十亿分子,把靶蛋白固定在磁珠上,像钓鱼一样捞出结合者,再 PCR 扩增、测序。传统逐管筛选的最大库只有低个位数百万,DEL 最大的库已到40万亿。组合化学的好处是大量分子只差一两个构件块,便于推断是哪一部分在驱动结合。
主持人追问了条形码的重量、假阳性等常见"创伤"。Ian 的回答是:训练模型时在输入里放一个占位符标记 DNA 位置,模型就是在"带 DNA 的分子"上学习;而且重复实验用新蛋白批次和新库,数月后命中仍基本同序,信号高度可复现。若要做药,则需脱 DNA 重新合成,容易的约90%保留活性,难的约50%。
二、为什么 Leash 的用法不同
传统 DEL 团队只为一个难靶点花2到6个月做蛋白,追求超大库和多样性。Leash 来自基因组方法学背景,反而对数百个蛋白筛同一个库,因此能发现同一个库两次合成行为不同这类怪癖。他们认为现有库的标签错误率约20~30%,DEL 并不更糟。
三、Kaggle:希望与恐惧
Leash 放出的数据约40亿,而当时 BindingDB 只有不到300万条。他们给"公司被共折叠模型淘汰"留了约5%的概率,更怀疑别人也不擅长此事。评测用阿里 Alpha Mal 的约1.3亿分子三嗪中心库做三层切分:共享构件块、共享核心、完全不同的 Leash 自设计库,并且不告知参赛者。结果最易一层有成绩,核心相同的一层略有提升,最难一层无人高于随机。
教训有三:只有三个较成熟的靶点,要泛化到新蛋白必须筛更多蛋白;与其把上亿分子的库做大,不如把小库刻画好;模型会记忆构件块。面对"是不是参赛者不够强"的质疑,Leash 把全部原始数据和评测放到 Polaris 平台公开。Ian 的态度是"我们想让这个问题被解决"。
四、Hermes 与评测纪律
Hermes 本意是一个极简、便于快速试验的模型:ESM 蛋白嵌入加类似 SMILES token 预测器的化学嵌入,交叉注意力,输出二分类。选注意力是因为他们以前发现打乱位置坐标的图模型表现不变,类似 CNN 的"毕加索问题",只学局部不学整体拓扑。
评测上他们按构件块相似度聚类切分,避免相似块跨越训练和测试。XGBoost 随共享构件块越少而稳定下降,Hermes 较平稳。团队还强调基线要简单,别花六个月优化后被 XGBoost 打败。
五、Clever Hans 与公开数据的毒性
故事起点是 Andrew Blevens 和 Ian 被一次随口评论困扰了六七年。他们下载了 ChEMBL 中发表超过约30篇论文、600个分子的化学家,共1815位,训练分类器,仅凭分子预测作者,top-5 达60%。再把分子表示成1800维的"作者概率向量"去预测 ChEMBL 活性,效果与化学结构相当,两者合并也没有明显提升,说明模型学到的是社会学。
原因有几条:化学家有个人风格并传给学生;他们总在解决同类问题;订购合成很麻烦,没做的分子不会被记录,"不做"也是指纹;药物化学家迷信某些构件块;优化过程中不断加基团,分子量成了最大预测器之一,CASP 里排序分子量也几乎并列第一。结论是"在排放物上训练会有麻烦"。
六、只用内部数据,并对标 Boltz
Leash 不在外部数据上训练,只用来预测。Hermes 论文里约1300万个测试、约500个靶点,与当时最佳结构模型 Boltz 大致相当,各有强弱项。BRD4 的例子很说明问题:该分子也在 PDB 晶体结构里,Boltz 几乎完美,Hermes 较差,推测 Boltz 见过。
七、活性悬崖、突变与负样本
Leash 认为通往泛化的路是刻意制造活性悬崖,即微小变化导致巨大行为变化,如药化里传说的"magic methyl"。在蛋白侧,现有共折叠模型即使把口袋改成水泥或移除,仍把分子塞回原处,说明在记忆。结构数据库里缺少这类负样本。
Leash 的做法是:先筛野生型;加入已知竞争剂,挤出口袋内的化学系列;再对口袋内氨基酸做定点突变,若同一批系列也消失,而其他结合不变,就证明它们进入的是那个口袋。他们大周可筛约100个蛋白构建。图中还展示了一个突变让某化学系列结合更强、另一个突变让所有系列被踢出的例子。
八、注意力显形记忆,LLM 作为化学家
Hermes 的注意力图并不在口袋,也不在保守结构域,而是在远离功能区的10~12个非保守氨基酸上,给蛋白起"昵称"。加入大规模突变后,注意力趋于均匀。Ian 说这类可解释性在生物里很实用,因为是"向模型学习生物学"。
最近他们转向语言模型:用 Qwen、GLM 等开源模型,先教它用英文描述结构、描述两个分子的差异、解释结合者为何结合,然后给10个结合者和10个非结合者,让它从目录中挑5到10个分子测试,再瞬间得到答案并更新假设。预算100分子,约100到200次调用,目标是从650万分子里找最佳结合者。他认为自然语言是好的正则化器,而且这是"物理上落地、可规模化、速度快"的强化学习环境。一个药化师职业生涯可能见到几十次 SAR 战役,上周他们就拉出了超过1万次。
九、刁钻问题:局限、商业与护城河
DEL 局限:构件块决定几何,Y形、线形、大环;商业可得构件块限制多样性,如果想把氮原子在环上逐位移动就要定制合成。酰胺键易降解的老问题,近四年已有更多碳碳、碳氮键化学。ADMET 方面,他们做过一个炎症项目,从库内命中到小鼠药代药效只用了6个月且药物化学循环很少,细胞因子水平符合预期。目前正与伙伴谈拆分新公司。库里已有约700个靶点上看起来较选择性的起始材料,如针对细胞因子的小分子口服替代抗体。
对 Kasari 悖论(有数据还要模型做什么),Ian 说若只为一个靶点,确实不需要;但若泛化到农业、兽医、材料,不用每个领域再筛一遍。KD:相对排序可行,读数到 KD 还不行,部分蛋白其实结合 DNA。护城河:不是资本,而是追踪批次效应、重做选择流程与蛋白表达的文化,例如发现库里类似 Lumacaftor(用于囊性纤维化的分子伴侣)的化学系列,在蛋白错误折叠时会反复出现,可作为数据过滤器。
金句
当你在"排放物"上训练模型,你可能就有麻烦了。 —— Ian Quigley 0:47
我们对 bitter lesson 是彻头彻尾的信徒:如果能用可规模化的测量得到好信号,就去拿。 —— Ian Quigley 34:37
模型不理解化学,它们只是记住了创造者的社会学。 —— Ian Quigley 55:17
它给蛋白起了个昵称,不需要学功能部分,记住十几个不同的氨基酸就够了。 —— Ian Quigley 72:55
没有人会卖关于政治理论的推理轨迹,但我们筛选过程中会产生一些金子。 —— Ian Quigley 91:14
提到的书·产品·人物
- Leash Bio / Hermes:Ian 的公司与其蛋白—小分子结合模型,用 ESM 加 SMILES 嵌入做交叉注意力。
- DNA-encoded library (DEL):核心技术,条形码标记的组合化学库,最大约40万亿分子。
- Kaggle 竞赛 / Polaris:约40亿数据点竞赛及数据公开平台。
- Recursion 及 "Recursion mafia":Ian 的前雇主,还提到 Noetic、Inveta、Nome Medicine 等同源公司。
- ChEMBL / BindingDB:公开结合数据库,ChEMBL 被用于 Clever Hans 实验。
- Boltz、AlphaFold、Isomorphic、Chai、Nabla:结构与共折叠模型及团队。
- ESM(Alex Rives 团队):蛋白嵌入来源,主持人提到前嘉宾。
- XGBoost:强基线。
- Clever Hans:德国会算术的马,被用作比喻。
- Lumacaftor:囊性纤维化分子伴侣,用作蛋白折叠不良的信号。
- Shaoji Luo / Alpha Mal:Kaggle 竞赛的化学库赞助者。
- Qwen、GLM:被微调成"药物化学家"的开源语言模型。
- GenePT、Xaira、Lila:被主持人提及的相关路线与公司。
- Shri Kasari:提出"机器学习药物发现商业模式悖论"的推文作者。
适合谁听
做 AI for Science、药物发现或任何"在噪声实验数据上训练模型"的人,尤其关心数据泄漏与评测设计的工程师。