核心要点
- 执行位置未解:Dev Day 宣称「可以合上笔记本」,但几位嘉宾实测合盖后智能体就停,Codex 与 Dots 的远程执行体验混乱;Pi Durable 把状态外置成只追加日志,被视为正确方向。
- 产品越改越糟:嘉宾认为 Dev Day 多数更新是退步,Codex 桌面应用新增侧边栏后性能变差、频繁卡死,ChatGPT 与 Codex 合并后「想服务所有人,结果谁都不满意」。
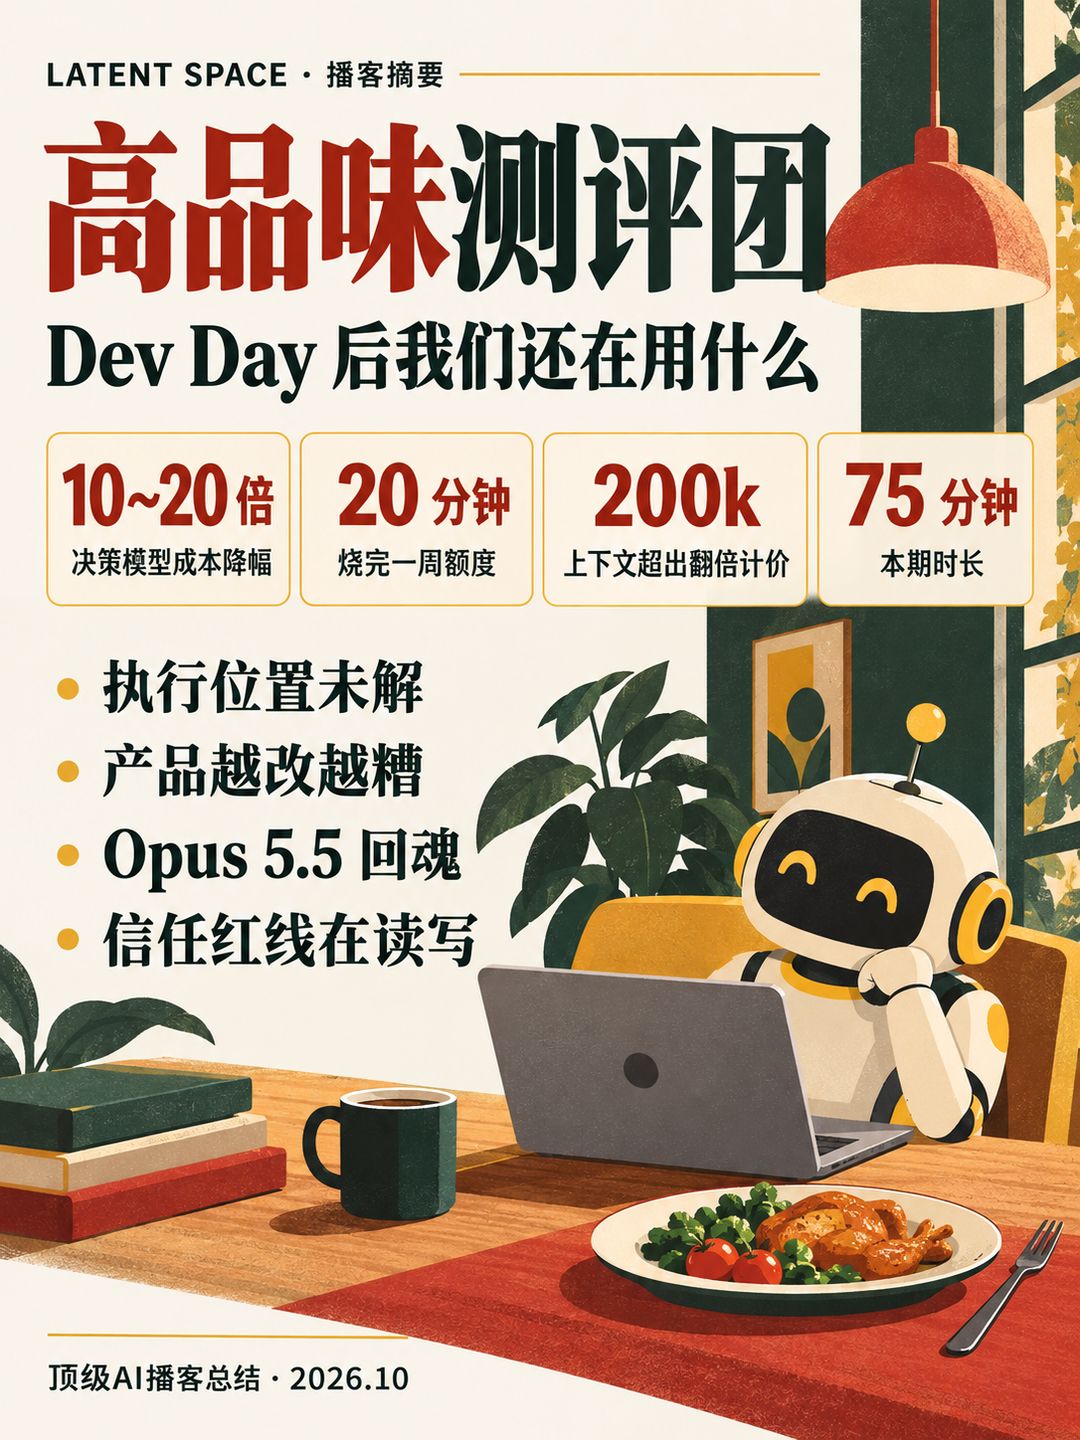
- 决策模型成本骤降:结构化分类用决策模型可比前沿模型便宜 10~20 倍,在评测中与不开推理的 Opus 5.5 接近;已有标注数据时,切换模型几乎零成本。
- Opus 5.5 回魂:嘉宾称 Opus 5.5 写作有「灵魂」,Soul 6.1 性价比极高,日常工作不必再用 Astra 或 Fable,只有大重构才动用顶配。
- Astra 极耗额度:Astra Ultra 最快模式下约 20 分钟烧完一周额度,子智能体配置设到 48 个时 2 小时耗尽限额,多数人把上限压回 15 个左右。
- Grok 4.7 失望:超过 200k 上下文价格翻倍,开快速模式再翻倍,叠加近三倍;token 效率差,只在为其强化训练的 Grokbot 里好用。
- 信任红线在读写:新一代模型对提示注入明显更稳,但嘉宾更怕模型「过度热心」误泄信息;多数人停在只读,写入前必须人工确认草稿。
章节时间轴
- 0:46 Dev Day 印象:发布比活动重要 — 嘉宾点评 Dots、Soul 6.1、Ultra 与 Notion 竞品,认为 Dots 隐藏太深,应做成独立应用。
- 4:36 「在哪里执行」仍未解决 — 抱怨云端按钮难配置、合上笔记本就停,并引出 Pi Durable 的外置日志方案。
- 8:24 Codex 桌面应用的退步 — 侧边栏、卡顿、ChatGPT 与 Codex 合并带来的混乱,以及「给所有人做的产品等于不为任何人做」。
- 13:00 助理的隐私与提示注入 — 讨论 Dots 接邮箱、谁值得信任(Apple、Google、OpenAI),以及 Muse 的误操作事故。
- 20:45 助理与编码智能体的分野 — 有人用 Pi 加 cron 搭个人助理,有人认为终局是同一套 Codex harness。
- 21:32 决策模型(Decisions API) — 日志概率、低切换成本、命令菜单排序等用法,以及 Cloudflare 竞品与「别看基准」之争。
- 32:13 主菜:模型选择 — Astra Ultra、Opus 5.5、Fable 与 Soul 6.1 的手感对比,Anthropic 内部用什么模型。
- 37:32 过夜长任务与子智能体 — 有界 Ralph 循环、detach 模式、子智能体缓存优势,以及压缩(compaction)的槽点。
- 43:42 其他模型:Luna、Muse Spark、Grok — OpenAI 命名混乱、Muse Spark 的多模态与低价、Grok 4.7 的定价与效率问题。
- 49:53 开源与闭源的差距 — 四台 DGX Spark 跑本地模型;Opus 5.5 写出三倍代码、一半是测试。
- 54:31 提示注入与权限边界 — 新模型的指令层级、只读与写入的界线、统一 MCP 网关 Executor。
- 59:50 甜点:各人的助理组合与冷门推荐 — Grokbot、Muse、Instinct、Devon 的分工,Soul 6.1 被低估,Google AI 搜索被低估。
详细内容
Dev Day 与 Dots:做对了方向,藏错了位置
嘉宾一致认为,这次 Dev Day 重要的是发布而非活动本身:Dots、Soul 6.1、Ultra 以及一个类似 Notion 的协作白板。一位嘉宾指出,Dots 的协作白板可写 markdown、画图,但深埋在界面里,和「在聊天里让 Codex 做可视化」一样没人知道。多人期望 Dots 是独立应用,一位嘉宾甚至推测它会走向独立设备,另一位反驳说「长期」在 AI 时代也就是三到六个月。
关于硬件,大家讨论了 Jony Ive 的缺席、Meta 眼镜已经算实物设备、OpenAI 可能先做类似 Echo 的家庭助理。一位嘉宾说自己和朋友用 Live 类工具一个周末就搭出了带计算机操作、MCP、CLI 的智能音箱,「不明白为什么没人做」。
Dots 的最大痛点是授权与执行位置。有嘉宾让自己的 Claude 夜里去配置 Dots,想让它能跑自己 git 仓库里的脚本(例如从 Mercury 拉银行数据写周报),但 ChatGPT 没有 Mercury 插件,除非开着 Codex 桌面应用让 Dots 去调用,否则用不了。这与 Dev Day 的「合上笔记本」口号形成反差:有人合盖后智能体就停,只好把笔记本留在办公室开着。
状态外置与「标准」缺位
Pi Durable 是前一天刚发布的项目:多数编码智能体默认把状态放在内存里,要迁移本地与云端就得重写。Pi 把状态外置为只追加的日志文件,作者据说重写了七次。嘉宾指出 Claude Code 与 Codex 内部本来就是大 JSONL 文件,却迟迟没有承诺稳定接口,所以有人干脆自建「只追加日志」的 harness,避免依赖实验室随时会变的 API。
目前没有类似 agents.md 的会话日志标准。有人在推动标准化智能体格式,也有面向研究与基准测试的 trace 标准,但在某个实验室采纳之前都只是尝试。另一位嘉宾补充了一个有趣的反差:在前沿智能上,闭源实验室跑在前面、开源追赶;在个人助理形态上,反而是 Peter Steinberger、Hermes 这类折腾者先做出爆款,Meta 与 OpenAI 要很久才能做出成熟产品。
产品退步与「给所有人」的陷阱
多位嘉宾认为 Codex 桌面应用刚出来时「非常对」,之后每次更新都在变差:额外侧边栏、性能下降、断网时输入框直接冻结。ChatGPT 与 Codex 合并后,界面只靠一个下拉框切换模型和模式,初版很糟,连 ChatGPT 线程都看不到。有人举例,Codex 把「fork chat」改名成「copy」,理由是非开发者看不懂 fork,这让开发者用户很恼火。
有嘉宾总结为「中间地带产品」问题:Grokbot 面向专业个人助理、调校到位;Muse 面向普通消费者、体验很好;而 Codex 被稀释、ChatGPT 越来越复杂,没人满意。ChatGPT 把强大功能藏起来,是因为要照顾八百万不太懂 AI 的用户,比如隐藏在二级侧边栏里的地图功能。嘉宾也半开玩笑地说,这种「到处随机变化、方向不明」正是用 AI 写产品的副作用。
对于合并的长期动机,一位嘉宾判断,OpenAI 是要在同一套 harness、同一套工具上做强化学习,所以最终一切都会是底层的 Codex。至于企业版 Dots 的愿景(员工与他的 Dots 同时出现在 Slack 线程里),嘉宾提出一个没答案的问题:别人给你发消息,他期待你本人回复还是你的机器人回复。
助理还是智能体:改名与权限
一位嘉宾发起「改名运动」:2025 是智能体之年、2026 是主动式智能体之年,但对非开发者,「agent」是吓人的词,「assistant」才亲切,因为人人都知道富人有私人助理排日程。他还提到自己在个人助理里读邮件、筛重点、预约理发。
另一方则问:既然都是开发者,为什么不直接把 Codex 改造成助理?一位嘉宾说,自己的主力助理就是 Pi,配了独立 Gmail、信用卡和 cron 提醒;另一位也是在 Codex 里加 cron 和自建的 S3 到 Google Drive 共享盘。反对意见是,自维护基础设施会让「一个问题变三个问题」,Mac mini 一断线助理就掉线,而且主动性部分很难做好。支持助理产品的一方则说,高管之所以离不开私人助理,正是因为忙到管不过来日程,主动式能力才是增量。
信任排序也很有意思:多位嘉宾说,只信任 Apple、Google、OpenAI 三家,愿意给邮箱权限;有人在 Cognition 收购 Poke 之后才放心连接。关于 Meta,有人对 Muse 预览版要邮箱密码拒绝;也有人认为 Meta 会「先做了再付代价」,而 OpenAI 数据已经够多,更不会乱来。
决策模型:便宜、快、低切换成本
节目里的「decisions」模型被描述为:目前基本是 Luna 加上结构化输出的封装,会继续改进,目前仍在候补名单中。一位嘉宾指出它并没有让任何事「技术上首次可能」,价格与速度才让它能用在新地方。另一位说,之前用结构化输出做 0 到 1 概率会被分桶成 0、0.5、1,校准很差;一位嘉宾坚持「从不相信模型给的 1 到 100 分」。
切换成本是一大卖点:只要积累了标注数据,新模型便宜 10 倍时,可以把现有标签当评测,只要一致率超过某个百分比,就只需人工复核不一致的部分。有人还做「穷人版 GEPA」:拿失败样例当评测,不断改提示。一个具体的数字是,某个智能体记忆管线(看所有智能体轨迹、告诉你该往 CLAUDE.md 加什么)里,用它做排序与重排后成本降低 10 到 20 倍,评测中与不开推理的 Opus 5.5 基本对齐。
产品用法方面,嘉宾举了「命令面板 Cmd+K」的例子:以前要么在 JavaScript 里查表,要么等 AI 流式输出,现在近乎即时地从 20 个页面里排序出用户想去的。他们同时吐槽,病毒式传播的示例多半「愚蠢得很」。
关于 Cloudflare 的竞品,嘉宾提到其基准成绩很好:小模型与之相当而更快,大模型更好更快。创始人反复强调「不要拿基准看我们」,有嘉宾赞同:在结构化分类里,很容易对特定领域过拟合;如果任务高度重复,过拟合也无妨,但通用场景很难公平比较。另一位嘉宾说,自己通过 Vercel AI Gateway 调用,所以根本没拿专属 API key。有人认为未来会本地运行,Web GPU 已能跑。还有人提出一个深层观点:二分类其实是世界上最难的问题之一,OpenAI 早年论文就把幻觉看成二分类问题。
模型手感:Opus 5.5、Soul 6.1 与顶配模型
嘉宾的第一选择多是 Astra Ultra 的最快模式,但代价是额度:一位嘉宾约 20 分钟就烧光一周额度。写作方面,一位嘉宾坚持「Claude 模型有灵魂、GPT 模型没有」,Opus 5.5 与 Fable 有,而 Sam Altman 也公开承认 OpenAI 模型写作不够好。有人回顾说,Opus 4.6 是上一个真正好用的版本,4.8 一塌糊涂,每日 AI 摘要产品的用户甚至因为文风变差发来截图抱怨,直到切回 Opus 5.5。
Anthropic 发布时,研究员对旧版本公开致歉,在嘉宾看来是前所未有的做法。有人推测 Anthropic 内部人员主要用未发布的模型,且速度与额度不受限,体验和外部用户完全不同。Opus 5.5 与 Soul 6.1 让日常工作无需再碰 Astra 或 Fable,只有「重构一切、审查巨大改动」才需要。Sonnet 被评为「不该碰的最佳模型」:适合作为 Opus 的低价子智能体,写作远不如 Opus。
OpenAI 的命名也成了槽点:Terra、Luna、Soul 的搭配本来清晰,但之后发布 Astra,Soul 6.1,Terra 一周后就消失了,嘉宾猜测是品牌考虑,以及 OpenAI 需要一个 Fable 级的模型。还有嘉宾提到,Soul 被认为是「被营销拖累」:据传原本不是这个名字,最后一刻改过。
过夜长任务、子智能体与上下文压缩
一位嘉宾说,Opus 5.5 让他第一次在 Claude Code 里用完一次额度重置。他此前不愿夜里跑满,因为「生产软件如果通宵不停地跑,会生成多到无法可靠消化的代码」;现在手上有 10 个原型,晚 10 点启动夜间智能体,早 9 点上线接手。做法是「穷人版 Ralph 循环」:排队 5 到 10 条提示,如「做个更好的压缩、读计划、持续改进」,这就像下棋时预走几步。
另一位嘉宾的 detach 模式 skill 可在后台并行运行 40 个 CLI 智能体,监控日志、暂停、改进、再跑。关于 Codex 能否开多个可对话线程,Codex 团队的多位成员回答说,子智能体因缓存优化与模型处理方式,明显更快更好。设置上,有人把子智能体设到 48 个,Astra 两小时就烧光限额,多数人保持 15 左右;还有人把自动压缩阈值调到 400k。
压缩是共同槽点:有人希望直接截断工具输出、剥掉图片,而不是做摘要;Claude Code 的压缩有时会让模型像「新来的人」一样说「我看到你之前在做……」。有人喜欢 OpenAI 的压缩,但嫌它慢。工作流分歧也很有趣:一位嘉宾让主线程只做对话、执行交给子线程,另一位则相反,让主线程干活、在旁边开临时线程聊天。更极端的做法是让主线程「只负责派发子智能体并设计时器催促」,据说靠它解决了其他模型都做不了的难题。
开源差距、Muse Spark 与 Grok
有嘉宾买了四台 DGX Spark,在 GLM 5.3 Flash 出现时看到模型尺寸就判断算力会升值,让父亲从俄亥俄的 MicroCenter 买来,结果「靠算力赚了钱」。他在上面跑 V4.1 Flash,可用于能验证的爬坡类问题,但不适合日常工作:前沿与其余模型之间有「鸿沟」,开源曾落后约六个月,现在大概一年。
一位嘉宾用 Slop Code Bench(威斯康星大学实验室)跑了十道题:Opus 5.5 写了约 3 万行代码,而 Sonnet 5 与 Opus 4.8 约 1 万行,其中超过 51% 是测试,其他模型只有 10% 到 15%。嘉宾们把这一代的特征概括为「蜂群行为更好」「信任」:能判别、能自我约束的子智能体编排,上一代到夏末已碰到天花板。
Muse Spark 的支持者强调:100 万上下文、多模态,可以听视频里的掌声,比 Gemini 便宜;不适合编码,适合甩大段文本。Grok 4.7 则被批「失望」:定价陷阱、token 效率差、既不够快也不够便宜、也不如 Opus 能干,只在被专门强化训练的 Grokbot 里好用。另一方为 Grok 辩护:X.com 内的 Grok 能访问实时推文,是最佳研究模型;grok build CLI 可被其他智能体当子智能体调用,原生带 X API 能力。
权限红线、统一网关与各自的组合
嘉宾们认为,新一代模型(始于 Astra 与 Opus 5.5)对提示注入明显更强,因为有「宪法、系统提示、内容」的层级,且内容都被明确包裹。Ply the Liberator 对一个 Hermes 智能体发起五次攻击未得手,被引为例证。但另一种风险被认为更大:模型「想帮忙」而误判该不该分享,比如有人让 Instinct 把 Netflix 2FA 验证码从邮箱里发出,Muse 曾让陌生人上门。
红线普遍划在只读,写入需明确许可。一位嘉宾让 Grokbot 发邮件前先显示草稿,但「五次里有一次」带有不想要的细节,如以「我是某人的 Grok」自称。另一位嘉宾的解决办法是统一的 MCP 网关 Executor(朋友的公司),放在家里的 Linux 机器上,通过 Cloudflare DNS 代理访问,所有助理只需连一次,技能、提示、配置全部集中。支付方面,有人想让智能体用 Mercury 为每个供应商生成虚拟卡,也有人提到 Link 的钱包。
各人的组合:有人是「git 仓库加脚本加 markdown 记忆」再配 Instinct 处理对外事务;有人 Grokbot 管行政、Codex 管其余;有人同时用 Poke、Lindy、Instinct,自嘲「像地狱」;还有人在 Grokbot 里搭了约 30 个角色(幕僚长、PM),通过 Linear 工单互相 @,Muse 用来处理语音一问一答,并把同一任务同时发给三个助理比较。大家也发现「记不清哪个对话在哪个助理里」,且记忆会各自分叉,导入导出并不能解决。
冷门推荐与结尾
嘉宾们的冷门推荐包括:Soul 6.1 被品牌混乱低估;个人助理对普通人是「时间解锁」,同时也让实验室从「查询-回答」转向全天候 token 消耗;一位嘉宾做了周末计划机器人,源于带孩子去上空手道课却发现课程关闭。另有人称 Google AI 搜索概览极被低估:约 300 毫秒出答案,而 ChatGPT 常停在最高推理设置。有人用 Raycast 的 AI 快捷键秒问,也有人在阿姆斯特丹半夜用 Instinct 问能否刷卡乘车。
硬件方面,Grokbot 可进特斯拉并用语音交互;一位嘉宾预测 Meta 展示的 Tamagotchi 式「charm」设备会瞬间售罄。关于 Apple 与可穿戴设备,有人认为需要充电的设备已经饱和,自己总会忘记给手表充电。最后各人呼吁:解锁想象力、对抗末日论、试试助理;Raindrop 提供智能体可靠性服务,每天 1000 次运行以内免费;Dex 在 Human Layer 做「软件锻造厂」,并澄清自己的热门演讲并非反对软件工厂。
金句
如果你在做生产级软件,让模型通宵不停地跑,你产出的代码会多到没法可靠消化。 —— 嘉宾 36:47
把你已有的标注全当作评测:一致率超过多少就换,只需复核不一致的部分。 —— 嘉宾 23:03
我只信任三家公司:Apple、Google、OpenAI,没有第四家。 —— 嘉宾 16:08
这些中间地带的产品想对所有人有用,最后对谁都没用。 —— 嘉宾 11:27
我现在大致停在只读,写入需要明确许可。 —— 嘉宾 59:04
我不想写代码,我只想让你做你自己,替我完成这件事。 —— 嘉宾 65:14
提到的书·产品·人物
- Dots(OpenAI):Dev Day 发布的个人助理,被批隐藏过深、执行位置不清,也有企业版设想。
- Codex / ChatGPT:Codex 桌面应用退步,与 ChatGPT 合并后被批;终局可能统一为同一 harness。
- Pi / Pi Durable:外置只追加日志的编码智能体,也被一位嘉宾用作个人助理。
- Peter Steinberger / OpenClaw:被视为个人助理形态的先行者。
- Hermes Agent:被提到作为个人助理,以及 Ply the Liberator 的测试对象。
- Ply the Liberator(越狱者):对 Hermes 智能体发起五次攻击未得手。
- Astra / Soul 6.1 / Luna / Terra(OpenAI):模型线;Astra Ultra 最强但极耗额度,Soul 6.1 被认为性价比高。
- Opus 5.5 / Fable / Mythos / Sonnet(Anthropic):Opus 5.5 被视为最佳日常模型;Fable 与 Mythos 被认为是内部用的顶配。
- Decisions API(决策模型)与 Cloudflare 竞品:低成本结构化分类,创始人强调不要看基准。
- Muse / Muse Spark(Meta):消费者助理与多模态模型,便宜、上下文 100 万。
- Grok 4.7 / Grokbot / grok build CLI(xAI):Grok 4.7 被批定价与效率,Grokbot 是被强化训练的助理产品。
- Instinct、Poke(后被 Cognition 收购)、Lindy、Devon、Cursor cloud agents:被不同嘉宾用作助理或云端智能体。
- Executor:朋友公司做的统一 MCP 网关。
- Slop Code Bench(威斯康星大学):评估代码膨胀的基准。
- DGX Spark / GLM 5.3 Flash / V4.1 Flash:本地跑开源模型的硬件与模型。
- Raindrop、Human Layer、Link 钱包、Mercury、Raycast、Vercel AI Gateway:嘉宾所在公司或被提到的工具与服务。
- Raindrop CTO、Dex(Human Layer)、Ben Davis(Nerd Snipe):本期嘉宾。
适合谁听
每天在 Codex、Claude Code 与各种个人助理之间切换、想听一线用户真实手感与权限踩坑经验的开发者和 AI 产品人。