核心要点
- 物理交割:SF Compute 花三年才明白,算力远不如想象中同质化。在行业建好物理交割之前过度金融化,市场容易被操纵,还会出现基差风险,对冲的价格与真实可买到的容量毫无关系。
- 必须中立:SF Compute 不拥有硬件,否则就能操纵远期市场。Nvidia、Crusoe、CoreWeave、Lambda、Baseten、Fireworks、Modal 都做不了,因为要做就得放弃自己的大推理和云业务。
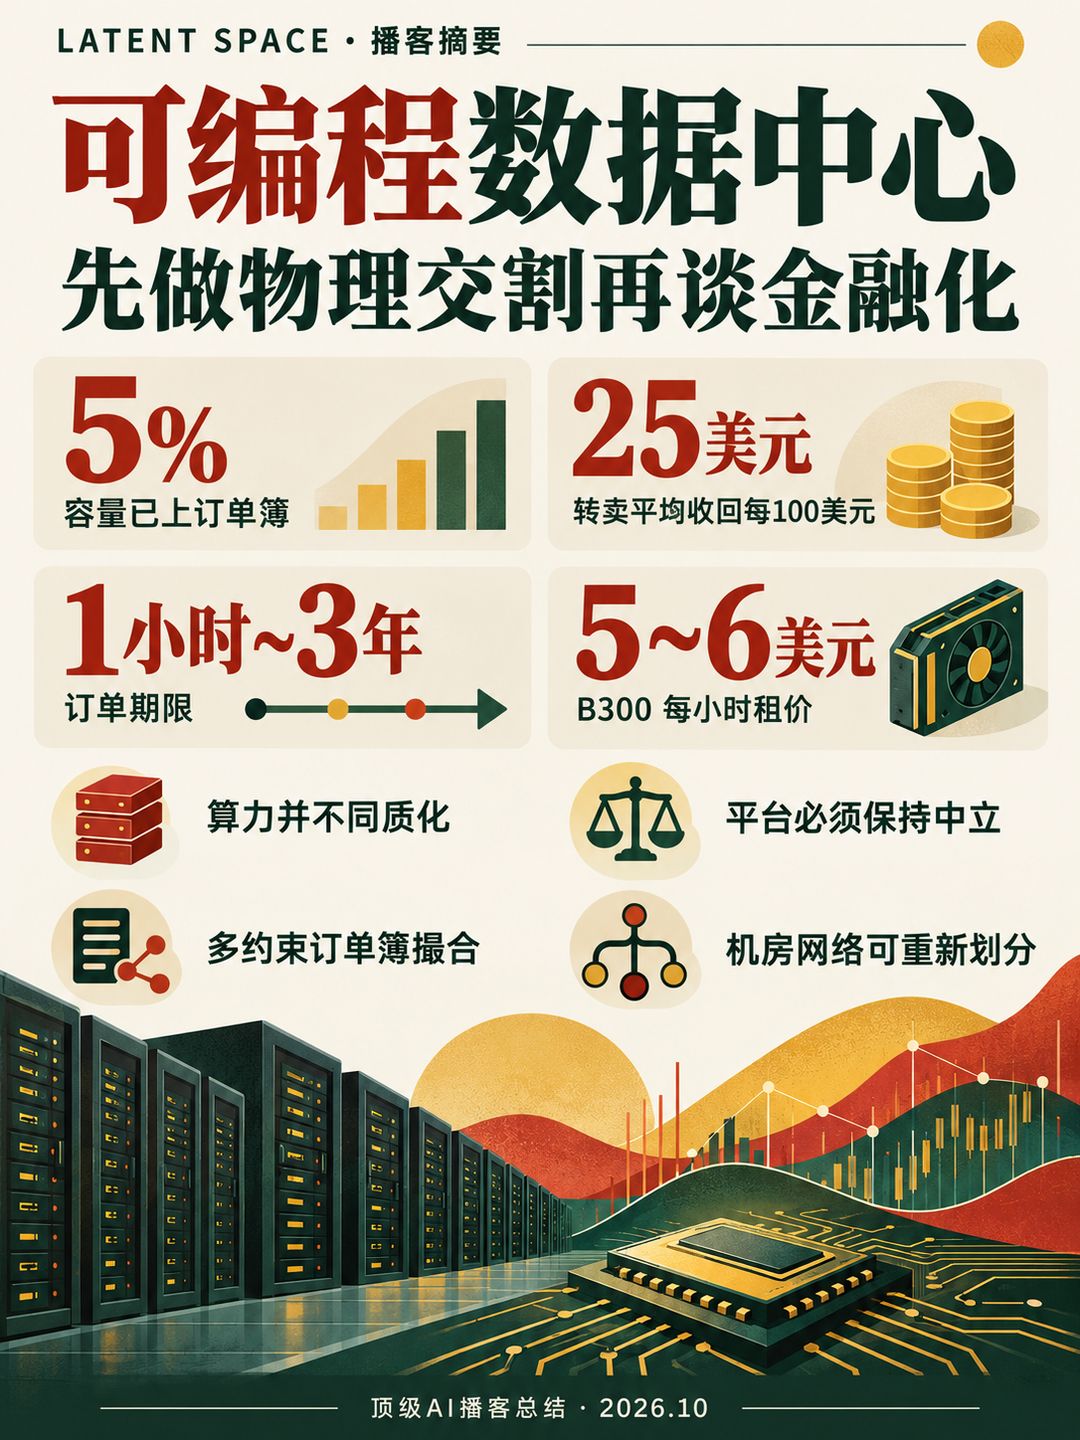
- 价差悖论:B300 满载跑推理每小时约赚 40 美元,50% 利用率约 25 美元,而租价仅 5 到 6 美元。Evan 说"总有一个数字要变",所以远期曲线并不是单调的,而是呈驼峰形。
- 多约束订单簿:不先定死 SKU,而是让买家给订单附加时间、存储、中断容忍度等约束,再由撮合引擎匹配。代价是买卖价差更大,好处是可以自定义 SKU,例如"任何 Blackwell,每小时不超过 6 美元"。
- 流动性指标:目前仅 5% 容量上了订单簿,成交量小但流动性集中。他们的衡量标准是客户花 100 美元买容量,转卖后平均能收回 25 美元,也就是看它有没有真正解决客户的问题。
- 期限与中断:订单可短至一小时、长至三年。批处理任务接受一两分钟通知,在线推理则需要数月预警,两者中断的定价截然不同,类似电力市场的日前市场与实时市场。
- 可编程机房:SF Compute 做选址、BOM、集群架构、PDU、交换机、UFM、BMC 等整套 backplane,已成交数亿美元,还允许客户随时重划 InfiniBand fabric,等于把数据中心虚拟化。
章节时间轴
- 0:00 开场:Nvidia 为什么不做 — 先抛出 Nvidia 能受益却无法亲自做算力市场的问题,并引出 Jump、SemiAnalysis 入场的背景。
- 2:16 从转租到物理交割 — Evan 用酒店比喻讲述从 Junnar 转租集群,到被迫运营整个"酒店",再到提出 physical settlement 的过程。
- 5:20 市场深度与流动性 — 5% 容量上订单簿,流动性集中,客户花 100 美元平均能转卖收回 25 美元。
- 7:38 标准化为何还很远 — 同一运营商的虚拟机可有 40% 性能差距,因此他们用多约束订单簿代替先标准化。
- 9:10 订单维度 — 当下负载与未来容量、存储(Weka、Vast)、WAN 传输路径,以及早期 H100、GB200 的批次固件问题。
- 14:33 期限与中断定价 — 集群融资周期为 3 到 5 年,订单簿可买一小时到三年,批处理与在线推理的中断成本不同。
- 17:39 曲线形状与价差悖论 — 价格曲线呈驼峰,B300 推理收益与租价相差数倍,买家对未来价格各有判断。
- 20:42 芯片代际与自定义 SKU — 因 VRAM、NVLink 域等差异,代际无法抽象,用户可自定义 SKU 查询。
- 23:01 物理交割对现金交割 — 对比 CDS、《大空头》和 LIBOR 操纵,主张现金交割应从物理交割派生。
- 26:49 生态与同行 — Silicon Data 做现金交割,SemiAnalysis 做标准,另有残值保险、押金借贷等公司。
- 29:06 技术栈与业务模式 — 不拥有硬件,却做站点勘查、BOM、集群架构和 backplane 管理,被称为"算力界的 Palantir"。
- 32:11 主权算力与巨头为何做不了 — 为各国搭建云,并解释 Nvidia 与各大云厂商因独立性与自身业务冲突而无法入场。
- 34:28 里程碑与号召 — 成交数亿美元,支持动态划分 InfiniBand,并向想持有 GPU 集群的投资者发出合作邀请。
详细内容
从转租集群到运营整座"酒店"
Evan 说,公司最初叫 Junnar,只想转租自家集群。就像酒店客人先要打扫,再要客房服务,再要安保,你最后不得不接手整座酒店。到了这一步,他们意识到市场的供应方应该更像基金或云,手里握有数据中心,于是花了几年建出一整套云运营能力,以便可靠地交付算力。
他们把这件事叫 physical settlement,借自期货市场:交割原油或大豆时,买家真的拿到货。可有些市场的交割有现实约束,比如原油需要管道。主持人补充了 COVID 期间原油价格一度为负的例子,用来说明物理交割的怪异之处。电力市场的订单里甚至要考虑锅炉冷却需要时间。
算力也一样,所以他们同时设计物理交割和订单簿,能处理诸如"我可以被中断,但前提是有存储让我快速恢复"这类真实约束。
市场深度、流动性与标准化
主持人以前做衍生品交易,所以问得很具体。Evan 承认市场不成熟、不够深:先要把供应拉上线,再搭平台,现在才开始把容量逐步搬上订单簿,目前约 5%,而且新增容量全部直接进订单簿。成交量虽小,流动性却高度集中。
他们的核心指标是客户花 100 美元买容量,转卖给别人平均能收回 25 美元。Evan 说,比起做市商数量之类的指标,他们更看这个流动性是不是真的解决了客户的问题。
关于合约标准化,他认为还很遥远。要标准化,先要让运营一致。例如同一运营商可以提供两种虚拟机,GPU kernel launch 的速度差 40%,最终影响 MFU。所以他们没有先定义商品等级,而是做了带多重约束的订单簿,让买卖双方各自附加属性再撮合。技术变化太快,先标准化不现实。代价是流动性不集中、买卖价差更大,但对能使用多种容量的产品来说,价差反而是套利空间。
订单簿的维度:时间、存储、网络与批次
Evan 逐项列举影响定价的维度。第一是容量是否正在运行:现在就要卖掉,必须中断当前负载;一个月后才开始的容量则可以随时买卖,流动性很容易形成。
第二是中断方式。集群有没有 Weka 或 Vast 这样的存储、容量多大,决定了被抢占后恢复得多快。存储位置也有影响:如果数据能快速搬到另一个集群,就可以在这里被中断、在那里重新跑起来,前提是集群之间有足够好的广域网(WAN)。
而 GPU 集群通常建在电力旁边,而不是客户旁边,所以传输路径往往不理想。第三是批次:早期 H100 和 GB200 有固件问题,可能出在 Supermicro 的整机固件而不是 Nvidia,需要厂商更新或在新机器出货时修复,因此成熟客户愿意为更晚出货的批次多付钱。主持人说这与 burn-in 和 RMA 不同,后者由好的云在交付前完成。
期限结构、中断定价与"驼峰"
Evan 说,整个行业的集群通常按 3 到 5 年融资,订单簿里的区块可以任意长度。目前区块要求全额预付,长期租约则不用。他们更关心远期:用户可以买从现在到下一小时,也可以买到三年后。
不同客户的中断容忍度不同。批处理推理有一两分钟的通知就行;在线推理则要提前几个月,因为一旦违约就要赔 SLA。所以这是一个"提前解约"的市场,也与电力市场里的日前市场和实时市场相似。
主持人追问 backwardation 还是 contango,Evan 说其实是驼峰:快到期未售出的容量像临期牛奶一样要降价;之后价格上升到合理水平;更远的未来又因为大家更想要现货而略低。但真正让他惊讶的是,B300 跑推理满载约每小时 40 美元,50% 利用率约 25 美元,租价却只有 5 到 6 美元。有人觉得价格会涨,所以愿意提前锁定更高的价格。
芯片代际、SKU 与查询
主持人问能否把算力抽象成统一的 FLOPs。Evan 说不行,因为 VRAM、NVLink 域大小等都和代际有关,客户确实在乎。主持人举了炼油厂的例子:原油可以放进黑箱,出来各种油品,而算力太异构,只能把复杂性暴露给客户,这对做市商不利。
Evan 的做法是降维但不消除维度。他们把 SKU 做成一个概念,让别人自己定义,例如愿意以每小时 6 美元或更低买 Blackwell,由系统在 GB300 或 B300 中匹配。有的客户不挑,有的客户非常挑,后者就会被市场收更高的价钱。命名查询是新功能,但查询系统本身就是订单簿现在的工作方式。
现金交割、LIBOR 与生态
Evan 想让行业记住的核心就是物理交割:他们花了三年才学会为什么需要它。算力并不像人们想的那样可替代,让它变得可替代是行业的任务。如果金融化跑在物理交割前面,市场就容易被操纵,并出现基差风险。
主持人举了信用违约掉期规模是所保险债券 12 倍之类的例子,以及《大空头》里的对赌。Evan 的立场不是反对现金交割,而是认为它应当派生自物理交割。对赌 OpenAI 之类不存在的份额也是同类问题。
主持人提到 LIBOR 的定价委员会,Evan 指出 LIBOR 就被操纵过,而算力指数同样可能基于很少的数据,与真实买入预留合约的价格相关性不高。他把 Silicon Data 和 Computer Change 视为早期的押注者,做现金交割,与自己互补,将来很可能合作。生态里还有 SemiAnalysis 做标准、残值保险、押金借贷等,都在解决算力的金融瓶颈。
技术栈、商业模式与为何巨头做不了
SF Compute 做云做的所有事,却不拥有硬件,因为拥有硬件就能操纵远期市场,所以必须像瑞士一样中立。物理交割要求他们做站点勘查、设计 BOM、做供应链咨询,设计集群架构、监督上架,再接管 PDU、交换机、DPU、UFM 和 BMC 等 backplane,主持人惊讶于这本是数据中心帮客户抽象掉的东西。
他们不做 Equinix 式的数据中心业务,也不自己施工,而是提供 supercomputing as a service:对手握电力、土地或数据中心的伙伴,帮它们变成云,由伙伴做数据中心云,SF Compute 做超算部分。有人形容他们像"算力界的 Palantir"。业务以美国为主,也在全球部署,对主权算力的卖点是在本国建云,并带来 San Francisco 的承购与经验、让它可融资。
为什么 Nvidia 做不了?因为它会失去独立性,没人敢在上面交易,贷款方也就不愿对远期市场放贷。Crusoe、CoreWeave、Lambda 和各家推理平台同样做不了,要做就得牺牲自己的大推理和云业务。这个市场能降低整个行业的融资成本。
里程碑与号召
Evan 说他们已完成数亿美元的成交量,有相当数量的新集群在路上。他最兴奋的是为 PaaS 公司做了一批新功能,例如客户无需联系他们就能随时重新划分 InfiniBand fabric,而一般云只给你一张固定的 fabric。主持人总结为"虚拟化数据中心并使其可编程",并说上一次这样的变化是云本身。
号召上,他欢迎想持有 GPU 集群并保留残值的人合作:SF Compute 负责超算部分并承担 SLA,如果之后想退出,可以立刻把集群卖给别人,不会落到你的资产负债表上。几周内会有合作伙伴公告。
金句
我们的看法是,Nvidia 自己做不了,但会从它的存在中获益巨大。 —— Evan Conrad 0:00
如果金融化走在物理交割前面,你得到的是一个很容易被操纵的市场。 —— Evan Conrad 23:46
就像牛奶快过期了,你就会降价。 —— Evan Conrad 18:26
一个 B300 每小时能赚 40 美元,却只花 5 到 6 美元就能租到,这两个数字必须有一个要变。 —— Evan Conrad 19:11
要做这个市场,你得先杀掉自己的生意。 —— Evan Conrad 33:43
我们在虚拟化数据中心,让它变得可编程。 —— Evan Conrad 35:14
提到的书·产品·人物
- SF Compute(公司):Evan Conrad 的算力交易与物理交割平台。
- Junnar(公司):SF Compute 早期名称,最初只想转租自家集群。
- Jump(公司):宣布进入算力市场,并与 SF Compute 合办活动。
- SemiAnalysis / Oliver(公司/人物):开始覆盖算力市场,并致力于更好的标准。
- Silicon Data、Computer Change(公司):做现金交割的同行,Evan 认为互补。
- Nvidia(公司):被称为 800 磅大猩猩,受益于该市场但无法自己做。
- Crusoe、CoreWeave、Lambda、Baseten、Fireworks、Modal(公司):因自身业务冲突,无法做中立市场。
- Weka、Vast(产品):集群存储系统,影响被抢占后的恢复。
- Supermicro(公司):早期 H100 整机固件问题的例子。
- Cornelis(公司):主持人提到 B200 上遇到过类似固件问题。
- GB200、H100、B300、GB300(产品):讨论批次、价格与代际差异的 GPU。
- InfiniBand、UFM、BMC、PDU、DPU(技术):backplane 管理所涉及的组件。
- 《大空头》(影视):主持人用来比喻现金交割的对赌。
- LIBOR(指标):用来类比指数被操纵的风险。
- Equinix(公司):主持人对比的数据中心业务。
- Palantir(公司):有人这样形容 SF Compute 的定制化工作方式。
- AI Engineer / Javits Center(活动/地点):主持人谈到下一年的大会地点和金融方向。
适合谁听
想看懂算力交易、GPU 融资与衍生品逻辑的工程师、投资人和基础设施创业者。