核心要点
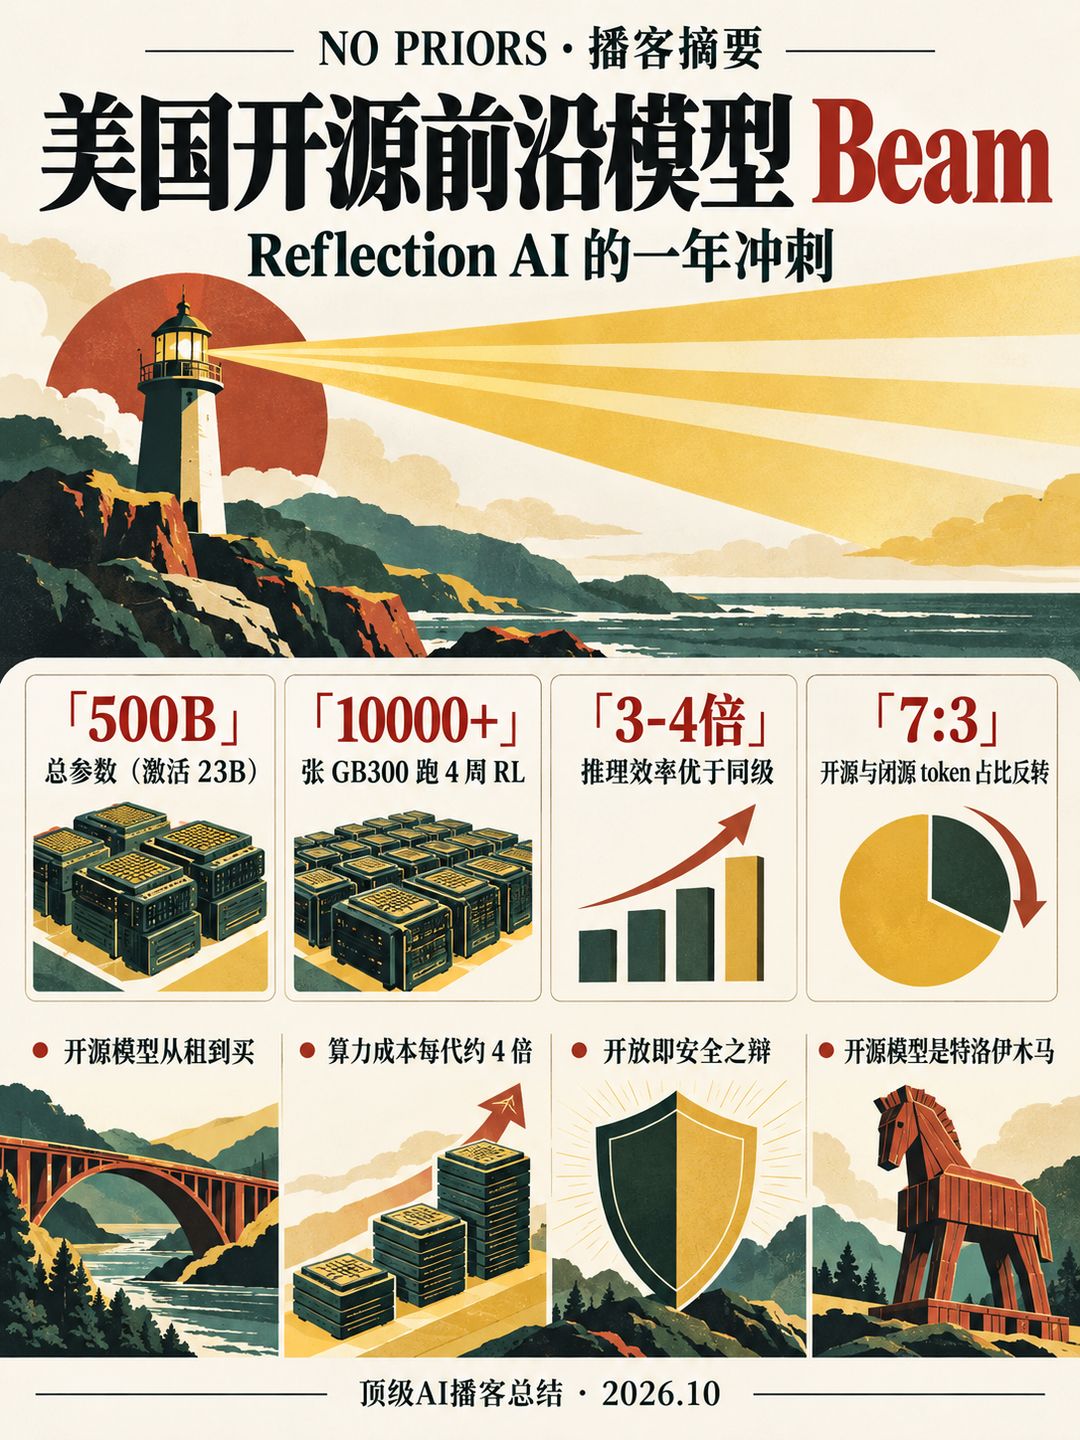
- Beam 规格:总参数 500B、激活 23B,用 6000 张 GB300 预训练,约数周,现在优化后约 12 天;RL 阶段用超过 10000 张 GB300 跑 4 周,他称是目前开源领域已公开的最大规模 RL。
- 算力成本曲线:追赶前沿的成本,约 18 个月前是数亿美元,半年前是数十亿,明年将到百亿级,每代模型约 4 倍算力。但模型参与自我改进后,效率每年提升约 7 倍(纯人工)到 RL 上的约 30 倍。
- 推理效率:Beam 面向编程和 agent 任务,推理效率比同能力档模型高 3~4 倍,对比更大模型可达约 10 倍。Misha 把这归因于强预训练底座加上超大规模 RL,速度与成本都直接惠及客户。
- 租与买:Misha 用「租房到买房」类比:token 是租一整套栈,企业支出到每年上亿美元闭源模型后才会转向自有。开源 token 占比已从约 3:7 翻转为 7:3,他预期格局类似 Linux 与操作系统。
- 企业路径:他认为企业多数 token 将来自「定制系统」(自建 harness),而非微调模型;金融 KYC、合规、网络防御、法律是最先落地的垂直场景。Reflection 提供部署工具与服务,以带动推理需求。
- 开源即安全:他援引 90 年代强加密由封闭转开放催生网络安全产业,以及 Linus 定律,主张开放让更多人能发现并修补漏洞;移除攻击能力同时也移除防御能力,OpenAI 与 Hugging Face 事件被他引为例证。
- 中美开源:Misha 视中国开源模型为对西方的「礼物」,但提醒其蒸馏、数据和国家支持的优势;开源模型像「特洛伊木马」,会带动整套软硬件栈,所以美国需要有竞争力的开源生态。
章节时间轴
- 0:46 Reflection 与 Beam 发布 — 一年内团队从约 30 人增至约 300 人,首个开放模型 Beam 发布,难点是同时做对 30 件事。
- 3:50 从 RL 到自训开源模型 — 创业时的 RL 赌注、中国开源模型占优的局面,以及为何必须自己预训练才能让 RL 跑得好。
- 7:39 前沿成本与算力曲线 — 追赶前沿从亿级到百亿级,每代约 4 倍算力,效率提升(7 倍到 30 倍)使渐近线出现。
- 12:15 Beam 训练细节与 RL 不停止改进 — 500B/23B 激活、GB300 集群规模,RL 曲线持续上升,问题转为经济学问题。
- 17:38 应用方向与数据 — 编程与 agent 打底,能力泛化但参差,金融、网络防御、法律等垂直场景靠评测生成合成数据。
- 19:58 推理效率 — Beam 比同级模型高效 3~4 倍,源于强底座加最大规模开源 RL,类比 AlphaGo。
- 22:17 商业模式:租 vs 买 — 开源与闭源都在最大化推理量,企业从租 token 到拥有智能,Reflection 提供部署栈与服务。
- 24:35 开源 token 占比与企业路径 — 3:7 翻转为 7:3,企业先定制系统再微调,支出过亿后才考虑开源与本地部署。
- 31:30 竞争公式 — 收入取决于智能密度、算力与客户信任的乘积,全栈商品化,利润被压缩。
- 34:35 中国开源与地缘政治 — 蒸馏、数据与国家支持,开源模型作为带动软硬件栈的「特洛伊木马」。
- 44:41 开源与安全之辩 — 开放即安全、Linus 定律、对三类安全的拆分,以及对末日叙事的批评。
- 56:14 展望:科学与数据中心 — 模型已能做博士论文级工作,生命科学与材料科学,数据中心类似当年的工厂。
- 60:51 研究团队与人才 — 模型参与研发,研究员数量稳态约 100,需求转向懂评测的「部署工程师」。
详细内容
一、从 RL 赌注到自训开源模型
Misha 与联合创始人 Ioannis(DeepMind 创始工程师之一,AlphaGo 等 RL 项目的核心贡献者)两年半前创业时,二人刚在 Gemini 1/1.5 团队做完 RL 对齐。当时模型基本只会聊天,约 95% 的算力花在预训练。他们的赌注是:把 RL 用到数学、编程等领域,可让模型具备 agent 能力,并且可以建立在当时出现的开源模型(Mistral 小模型、Llama 2,以及即将到来的 Llama 3)上,以独立实验室的方式更节省资本。
计划有两处出乎意料。第一,RL 比预期更快见效:他原以为从 2012 年 ImageNet 到 RL 大规模可用花了约 4 年,这次也会类似,结果 o1 很快出现。第二,一年后好的开源模型几乎都来自中国,西方缺少可用的底座。于是他们决定端到端自己造开源模型,理由有企业需求、地缘政治,还有一条研究上的原因:要让 RL 在大规模下有效,确实需要自己预训练,二者耦合得很紧。
困难方面,他的回答是「everything is hard」:要同时做对约 30 件事,包括招人留人、使命文化、数据、算力,以及把算力变成可用的基础设施。在大实验室里这些「稳定表面」是多年积累的,他在 DeepMind 时把它们视为理所当然,现在必须从头搭建。
二、算力成本与效率曲线
主持人问追赶前沿要多少资本,Misha 说前沿在移动,所以每年成本都更高:约 18 个月前是数亿美元量级,约半年前是数十亿,明年是百亿级。他的经验法则是每一代模型约 4 倍算力,比如从 10 万张 H100 到 10 万张 Blackwell(约 4 倍),再到下一代 10 万张 Vera Rubin。
但他认为会出现渐近线:前沿实验室已投入数千亿美元,再到万亿级不太可能。原因是算力使用在变得更高效,模型自己在帮助构建自己。纯人工研究时,预训练的计算效率每年约提升 7 倍(以相同 loss 所需算力衡量),而 RL 还有很大空间,在模型能自我改进的程度下可达约 30 倍;整体速度比研究员单干快 4 倍以上,且会继续加快。同时每个 FLOP 能产生的收入也在上升。
他还强调,一旦到了前沿,你就需要与其他前沿实验室同等的资源;追赶者能省的是「探索」成本,靠优秀人才把精力集中在已知有效的做法上。
三、Beam 的训练与推理效率
Beam 总参数 500B,激活 23B。预训练用 6000 张 GB300,原本跑了数周,现在靠基础设施效率可在约 12 天内完成;RL 用超过 10000 张 GB300 跑 4 周,所以 RL 实际花的 FLOP 更多,因为 RL 既要大规模推理(含 agent 的沙箱),又要训练,系统更复杂。最终模型在 7 月收到的 SpaceX 集群上训练,先预训练数周,再用合成数据做 RL,仍有许多已知有效的改进没来得及放进去。
他当年入行的原因就是 AlphaGo 的一张曲线:它一直在提升,直到被人为中止。他说 Beam 的 RL 曲线同样持续向上,只取决于投入多少算力,所以问题已从「能不能训」变成「数据在哪、什么在经济上有价值」。他还说这个领域更像工程学科,不像 5 年前那样百花齐放,部分原因是硬件彩票:一旦某种方法跑通,硬件就围绕它共同优化。
Beam 针对编程与 agent 任务训练,推理效率比同能力档模型高 3~4 倍,对比更大的模型可达约 10 倍。Misha 的解释是强预训练底座加最大规模的开源 RL,类似早期 AlphaGo 先模仿人类棋局再靠 RL 变得「搜索得很聪明」。效率意味着更快完成任务、更低成本,适合做企业与主权客户的「工作马」模型。
四、泛化、数据与商业化
编程和 agent 能力是智能的基础,但泛化是「参差的」:不同版本的 Terminal Bench 之间并不会干净地泛化,但一旦有了通用 agent 能力,拿到新 harness 的数据就会很快适应。所以关键是找到经济上有价值的数据池:Reflection 不训练客户数据,而是搭建评测,再生成近似的合成数据。他提到的具体场景包括金融 KYC 与合规流程、网络防御、法律等 agent 垂直领域。
商业化上,他认为开源与闭源本质相同,都在最大化推理量,区别是「租」与「买」。买 token 是租一整套栈(harness、模型、推理软件、集群管理、GPU);企业成熟后想拥有智能,就像人从租房转向买房。开源模型虽宽松授权,但落地仍需要集群管理、推理软件、harness 等配套,Reflection 为大型企业和主权客户提供这些工具及服务,服务是带动推理需求的「需求驱动器」。
五、开源 token 占比与企业采用路径
他观察到,在 OpenRouter、Vercel 这类网关上,闭源与开源 token 的占比约半年前是 7:3,如今几乎反转为开源 7:3。他预期未来类似操作系统:95% 以上服务器跑 Linux,但微软、苹果仍极有价值;开源上的经济价值也会很大,因为运行模型所需的算力与云仍然昂贵。
对于「定制」的比例,行业说法是专用推理服务中 90% 以上是定制模型,但那主要是 Cursor、Cognition、Harvey 这类 AI 原生公司。Misha 的不同看法是,企业多数 token 将来自「定制系统」而不是微调模型,因为企业是围绕既有产品与工具来架构,直接冲到微调阻力很大。他认为企业不会直接冲到「拥有」阶段,而要先经过「租」:当每年在闭源模型上花数亿美元时,才开始考虑成本优化;由于算力短缺、超大云厂商拿不到合适价格,本地部署也在复兴,比如在 Dell 的裸金属上自建服务。
竞争公式方面,他认为长期赢家取决于「智能密度 × 算力 × 客户信任」。他认为整个栈都在商品化,开源模型与闭源模型之间的张力会压缩利润,AI 原生公司在谈闭源合同时会明确以开源生态为筹码;算力稀缺在较长时间内仍是关键约束。
六、中国开源模型与地缘政治
他认为中国开源生态对世界是巨大的利好,西方许多公司因此建立了更持久的业务;否则可能出现「高枝被砍」的局面,应用层好产品会被闭源模型商吸收。但他不希望世界单极:闭源实验室若只有一两家很可怕,开源智能若只来自一个国家也一样;理想是 10 到 20 家,鉴于资本支出,至少要有两个。所以这更多是竞争张力,而不是纯粹的西方对中国。
关于中国的优势,他提到:以工业规模蒸馏闭源模型、更便宜或免费的数据(如受版权保护的 PDF 在中国监管下可用)、以及某种直接或间接的国家支持(这些公司长期没有收入)。主持人称中国开源本质上是对西方企业的补贴,Misha 表示同意。他认为这些公司正在变成真正的业务,在国内相当于闭源实验室。为何继续开源?他的假设是中国是相对封闭的市场,开源模型提供者就是国内的智能供应商;同时,让其他国家基于你的东西构建在地缘上极为有利,和 5G、光纤、一带一路类似。
他把开源模型称为「特洛伊木马」:模型本身不够用,买进的是整套软硬件生态。比如盟国可能今天在美国芯片上跑中国模型,但华为等很快会提供全栈方案。他把芯片和数据中心比作铁路这类基础设施,掌握者拥有地缘杠杆。他还指出美国历来的打法是让世界建立在自己的技术上(互联网、开放协议、开源、美元、海军保障下的自由贸易),但在开源上美国一度落后,美国生态刚刚起步,仍要追赶;同时《财富》500 强中对中国模型的抵触使其开源模型使用占比仍低。
七、开源与安全
Misha 承认安全是合理担忧,但认为现有安全世界观已带有教条色彩。他以软件为类比:90 年代关于强加密要不要闭源,NSA 与公民自由倡导者争论;封闭一侧发生了几个灾难性失败,少数工程师设计的系统有无法预料的后果并很容易被攻破,最终强加密走向开放,并催生整个网络安全领域。所以默认状态是「开放即安全」。AI 与软件类似但更极端:黑盒使漏洞长尾更长;他引用 Linus 定律「有足够多的眼睛,所有 bug 都浅」,认为安全漏洞同理。如今只有几百名闭源实验室内的安全研究员,无论多善意都不可能覆盖长尾。他举例,一个强大的闭源模型曾入侵另一家公司,该公司只能用开源模型来修复自己。
对主持人区分的三类安全(网络攻击、生物武器与恐怖主义、对人类的生存威胁),他主张按「现实到理论」的光谱看:网络能力去年还是理论,今天已成现实;未来 6 个月可预测的是经验性问题;最远端是纯理论场景。他认为舆论像是峰值落在末日情景上,而分布应峰值在现实,并批评有领导者宣称「10% 概率人类灭绝」是不可证实的数字。他提到曼哈顿计划时担心大气被点燃、纳米机器人「灰雾」等历史上的理论担忧作类比。
对于对齐,他认为迄今的对齐科学「极其无聊」,没有神奇的方程,更像打地鼠:早期预训练模型有毒,当时认为无法修复,后来靠足够的后训练数据就能修补并泛化,变得很难越狱。未来对齐问题也可能是平凡而枯燥的:发现漏洞、准备数据补丁、让语言模型去检测。对「个人和企业不应拥有如此强大工具」的说法,他认为这是「只有我们才有资格」的立场;防御应当大于攻击,类似白细胞生态;网络上攻防难以分离,移除攻击能力也会让想防御的人无能为力,他提到近期 OpenAI 与 Hugging Face 的事件中,因闭源模型护栏而转用开源模型。
八、科学、数据中心与研究团队
展望两到五年,Misha 最兴奋的是科学进展。他多年来把自己的博士论文当提示词给模型:两年前模型只能聊天,一年前只能回答到本科水平,半年前能在真正的博士水平上正确解决,如今还能提供他当时没考虑的新信息。他说博士可能「一周就能做完」。他还期待 AI 与真实实验的结合(生命科学、材料科学、化学),建立专有数据飞轮,虽然比「黑板上」的科学慢得多,但比以前快很多。他认为软件工程的变化仍被低估。
他参观 Stargate 时最深的印象是停车场里的车:数据中心创造数万个高薪岗位和税收,如同当年的工厂;当然需要隔离噪音、远离居民区。
研究团队方面,Ioannis 负责研究与技术。由于时间表限制,许多已知有效的改进没放进 Beam,他的策略是先用尽高影响、低风险的做法,再扩大风险,并用小规模扩展实验筛选,但有些现象只在大规模才出现。模型参与研发对研究员非常赋能,像「一位快速、热切且会听话的同事」,但模型能力参差,需要判断哪些环节可闭环;因此年度改进速度从约 7 倍提高到约 4 到 5 倍的倍数叠加。至于人员,他认为同样的工作 100 人可降到更少,但野心也在扩大,团队一直人手不足;研究员数百人很有用,3000 人则无益。AlphaGo 当时约 10 人,今天大项目约百人或数百人,他估计稳态约百人量级。同时会有大量「部署工程师」岗位:每项真实世界能力都需要一个懂评测、懂 harness 的小组,这与评测研究员技能相同,目前是培训缺口,而不是需求不足。
金句
当你移除网络攻击能力,也就移除了网络防御能力。 —— Misha Laskin 0:00
每一代模型大约需要 4 倍的算力,所以前沿成本是从亿级到十亿级,再到百亿级。 —— Misha Laskin 9:12
我们就像先租公寓,等成熟了就想买房;AI 正在走到企业想拥有智能的阶段。 —— Misha Laskin 23:03
开源模型是特洛伊木马,它带来的是整套基础设施。 —— Misha Laskin 55:29
对齐的科学迄今极其无聊、令人不满,没有神奇的对齐方程,更像打地鼠。 —— Misha Laskin 51:35
数据中心现在就像当年的工厂。 —— Misha Laskin 60:05
提到的书·产品·人物
- Beam(产品):Reflection AI 首个开放权重模型,500B 总参数、23B 激活,面向编程和 agent 任务。
- Reflection AI(公司):Misha 联合创办,目标是打造前沿开放智能。
- Ioannis Antonoglou(人物):联合创始人,DeepMind 创始工程师之一,负责研究与技术(转写中名字写作 Giannis)。
- AlphaGo(产品):Misha 入行的契机,作为 RL 持续改进和先模仿后 RL 的类比。
- Gemini 1 / 1.5(产品):两位创始人在 Google 参与的早期 RL 工作。
- OpenAI o1(产品):证明 RL 比预期更快可用。
- Llama 2 / Llama 3、Mistral(产品/公司):创业时期被视为可依赖的开源底座。
- NVIDIA H100 / Blackwell / GB300 / Vera Rubin(芯片):用于说明每代约 4 倍算力,Beam 在 GB300 上训练。
- SpaceX 集群(基础设施):Beam 最终模型的训练集群,7 月收到。
- Terminal Bench(评测):用于说明不同 harness 之间的参差泛化。
- OpenRouter、Vercel(平台):作为观察开源与闭源 token 占比的网关。
- Cursor、Cognition、Harvey(公司):AI 原生定制开源模型的代表。
- Linux、Linus Torvalds(产品/人物):开源操作系统类比,以及「足够多的眼睛」定律。
- Dell(公司):企业本地部署裸金属的例子。
- Huawei(公司):被提及可能提供全栈方案并锁定他国供应。
- Stargate(项目):Misha 参观后谈数据中心创造就业。
- Hugging Face、OpenAI(公司):开源防御事件的例子(转写文本较含糊)。
- Reid Hoffman(人物):「边飞边造飞机」的引用。
适合谁听
关心开源模型商业化、前沿训练成本、企业落地路径以及中美开源与 AI 安全争论的从业者和投资人。